
Dagster
Dagster Labs · Programmation
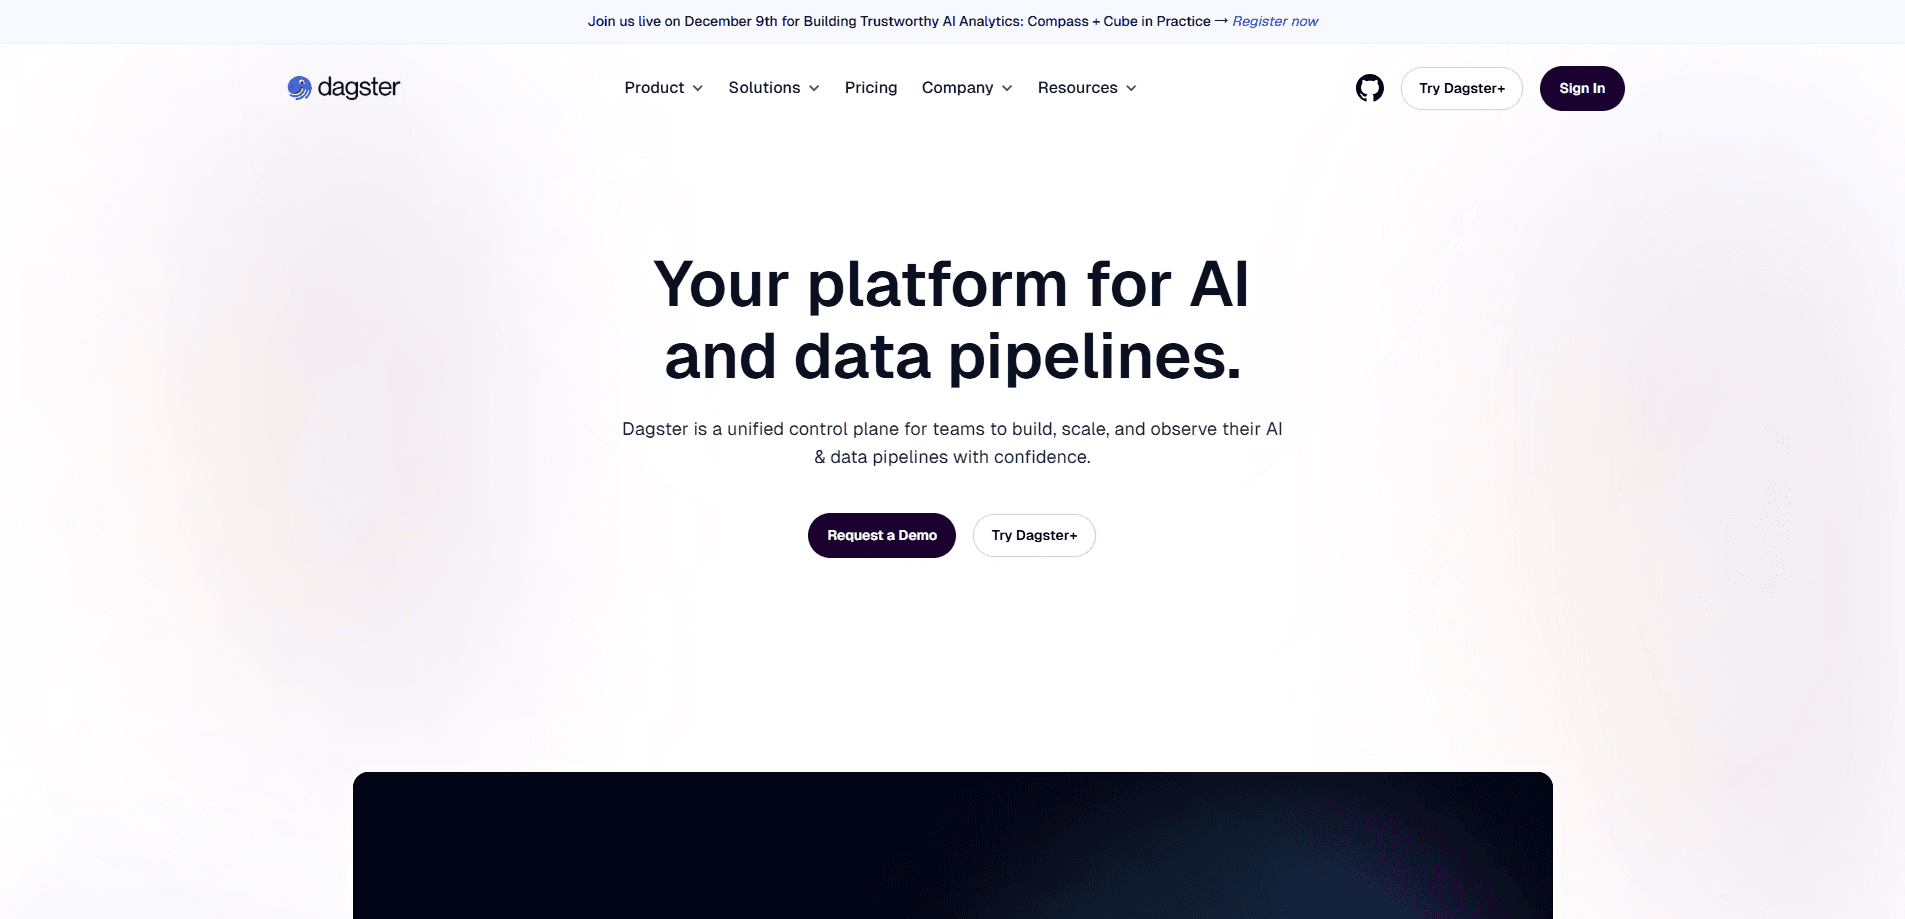
Dagster est une plateforme d'orchestration de données open source qui aide les équipes data à créer, planifier et surveiller des pipelines de données et d'IA fiables. Elle traite chaque sortie comme un actif à part entière, si bien que le lignage, les contrôles de qualité et le contexte de dépendances sont inclus par défaut. L'orchestration de pipelines de données est rarement aussi bien ordonnée. Une version hébergée appelée Dagster+ ajoute le déploiement sans serveur, les alertes et l'accès basé sur les rôles pour les équipes qui ne veulent pas gérer l'infrastructure elles-mêmes.
À propos de Dagster
Qu'est-ce que Dagster
Dagster est une plateforme moderne d'orchestration de données bâtie sur l'idée que les pipelines doivent être définis par les données qu'ils produisent, pas seulement par les tâches qu'ils exécutent. La plupart des outils d'orchestration décrivent les traitements comme des étapes dans une séquence. Dagster inverse ce modèle. Vous déclarez des actifs comme des tables, des fichiers et des modèles, et la plateforme détermine ce qui doit s'exécuter et quand. Ce basculement compte. C'est lui qui vous permet de remonter un chiffre jusqu'à sa source, de vérifier la fraîcheur automatiquement et de remettre une vision opérationnelle claire au reste de l'équipe.
Le projet est né dans le monde de l'open source et est maintenu par Dagster Labs (anciennement Elementl), avec le produit cloud Dagster+ par-dessus. Les équipes y viennent quand elles ont dépassé les tâches cron et les scripts shell, ou quand un ordonnanceur de workflows géré leur paraît trop rigide. Le déclencheur habituel est une stack de données qui s'étend sur plusieurs outils. Modèles dbt, traitements ELT et désormais pipelines d'IA. Aucun endroit unique pour voir comment tout se connecte.
La limite la plus importante, c'est la portée. Dagster ne transforme pas vos données à votre place et ne remplace ni votre entrepôt, ni votre couche de transformation, ni votre outil de BI. Il orchestre le travail autour de tous ces éléments. C'est aussi un produit destiné aux développeurs. Écrire des pipelines, c'est écrire du Python, donc les équipes sans appui d'ingénierie trouveront la courbe d'apprentissage raide face à un ordonnanceur sans code.
Premiers pas
- Installez le cœur open source en local avec pip et générez un projet avec l'outil en ligne de commande dg.
- Définissez votre premier actif en Python, en décrivant ce qu'il produit et de quels actifs en amont il dépend.
- Ajoutez des contrôles d'actifs et des politiques de fraîcheur pour que la plateforme signale des données périmées ou cassées sans que vous ayez à surveiller.
- Testez le pipeline en local dans l'interface web, en utilisant l'historique des exécutions et les vues de lignage pour confirmer que tout se relie.
- Déployez sur Dagster+ pour des exécutions planifiées, des alertes et un accès partagé, ou hébergez vous-même sur votre propre infrastructure.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Dagster.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Ingénieurs data
- Équipes analytiques qui utilisent dbt
- Équipes plateforme en entreprise en croissance
Tâches
- Orchestrer des traitements ELT et dbt
- Surveiller la fraîcheur des données
- Rétro-remplissage et gestion des partitions
- Exécuter des pipelines d'IA et de LLM
Cas d'usage
- Un projet dbt qui a dépassé la planification simple
- Déboguer le chiffre cassé d'un tableau de bord
- Passer d'une équipe à plusieurs
Fonctionnalités clés
Orchestration par actifs
L'idée centrale de Dagster, c'est que vous décrivez les données que vous voulez, pas l'ordre des étapes. Chaque actif sait ce qu'il produit et de quoi il dépend, et la plateforme résout le graphe d'exécution pour vous. Cette structure est ce qui rend possibles le lignage, la fraîcheur et les contrôles de qualité. Sans plomberie supplémentaire.
Lignage de données et observabilité intégrés
Chaque actif porte ses dépendances, ses métadonnées et ses signaux de santé dans une seule vue. Alors, que se passe-t-il quand quelque chose casse ? Vous retracez quelle source en amont l'a causé et quels rapports en aval sont touchés. C'est la partie que le plus d'équipes citent comme raison d'avoir quitté un ordonnanceur basé sur les tâches.
Intégration dbt native
Dagster lit votre projet dbt et transforme les modèles en actifs, avec les tests dbt qui apparaissent comme des contrôles d'actifs. Vous continuez d'écrire du dbt comme vous le faites déjà. Dagster gère la planification, les dépendances et la visibilité autour.
Contrôles de qualité et politiques de fraîcheur
Les contrôles d'actifs vous laissent affirmer des conditions sur vos données, et les politiques de fraîcheur définissent à quel point un actif doit être à jour. Les violations déclenchent des alertes par e-mail, Slack ou Microsoft Teams. Les problèmes remontent avant qu'un décideur ne le fasse.
Déploiements par branche
Les changements de pipeline peuvent être testés dans un environnement proche de la production avant d'atteindre des données réelles. Chaque branche obtient son propre déploiement isolé. Cela rend la revue d'un changement sur un système en marche bien moins stressante que d'approuver un diff à l'aveugle.
Déploiement hybride et sans serveur
Vous pouvez exécuter Dagster+ avec du calcul sans serveur ou le connecter à votre propre infrastructure sur Kubernetes, Docker ou un fournisseur cloud. Les configurations hybrides gardent les données dans votre réseau tout en utilisant le plan de contrôle géré. Parfait.
IA de Dagster+ et serveur MCP
La couche d'IA la plus récente travaille à partir du contexte que Dagster suit déjà, comme les exécutions, les échecs et l'historique d'automatisation. Elle peut aider à diagnostiquer des problèmes et à expliquer le comportement du pipeline. Un serveur MCP relie la plateforme à des assistants de code IA.
Avantages et inconvénients
Avantages
- Le modèle par actifs rend les dépendances et le lignage visibles par défaut, ce qui est la fonction que le plus d'équipes citent pour expliquer leur changement.
- Le bon support de dbt signifie que vous n'avez pas à abandonner un flux de transformation existant pour obtenir une meilleure orchestration.
- Le cœur open source maintient le coût d'entrée à zéro, et les offres payantes commencent bas pour ceux qui travaillent seuls.
- La testabilité est une préoccupation de premier ordre, donc les pipelines peuvent être validés avant de toucher des données de production.
Inconvénients
- C'est un outil code-first, donc les équipes sans compétences en Python trouveront un ordonnanceur sans code plus simple à adopter.
- Il ne transforme pas les données et ne remplace ni votre entrepôt ni votre couche de BI, donc c'est une pièce de plus dans la stack plutôt qu'une solution unique.
- Les fonctionnalités varient beaucoup selon l'offre : la recherche dans le catalogue, le contrôle d'accès basé sur les rôles et le suivi des coûts se trouvent dans les paliers supérieurs, donc les petites équipes peuvent buter sur des limites dans les offres moins chères.
Questions fréquentes
Il orchestre des pipelines de données et d'IA : il planifie les traitements, suit les dépendances, vérifie la qualité des données et affiche le lignage sur toute votre stack. Voyez-le comme la couche qui coordonne les outils que vous utilisez déjà plutôt que de les remplacer.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Dagster.
Alternatives à Dagster
Forefront
Forefront · ProgrammationForefront est une plateforme web pour construire avec de l'IA open source. Elle vous laisse affiner les principaux modèles de langage open source sur vos propres données, évaluer leurs performances et les exécuter via une API ou les exporter pour les héberger vous-même. Les développeurs qui veulent le confort d'une plateforme fermée mais tiennent à rester propriétaires de leurs modèles et de leurs données sont le public visé ici.

Startkit
StartKit.AI · ProgrammationStartkit est un boilerplate pour créer des produits SaaS d'IA et des wrappers d'IA. Voyez-le comme un boilerplate de startup IA avec les parties ennuyeuses déjà branchées : authentification, paiements Stripe et Lemon Squeezy, limites d'usage, e-mail transactionnel et un kit de démarrage d'API IA qui parle à OpenAI, Anthropic, Groq ou Llama. Vous clonez le dépôt, fixez votre prix et attaquez la partie du produit pour laquelle les gens paient vraiment. Il repose sur Next.js au-dessus de React et Tailwind, donc une bonne partie du code boilerplate vous semble déjà familière.
Testim
Tricentis · ProgrammationTestim est une plateforme d'automatisation des tests dopée à l'IA, qui sert à créer et exécuter des tests de bout en bout sur des applications web, mobiles et Salesforce. Elle s'appuie sur l'apprentissage automatique pour garder les tests stables quand une interface change, alors les équipes passent moins de temps à réparer des sélecteurs cassés. Pas mal pour un outil de tests automatisés que vous pouvez utiliser dès aujourd'hui. Vous créez des tests en enregistrant des actions dans un navigateur, puis vous ajoutez du JavaScript quand vous avez besoin de plus de contrôle. C'est un choix solide pour une équipe QA bien occupée.