
EnergeticAI
EnergeticAI open-source project · Programmation
EnergeticAI est une distribution open source de TensorFlow.js conçue pour les fonctions serverless : un modèle d'embeddings ou un classificateur de texte démarre en une cinquantaine de millisecondes.
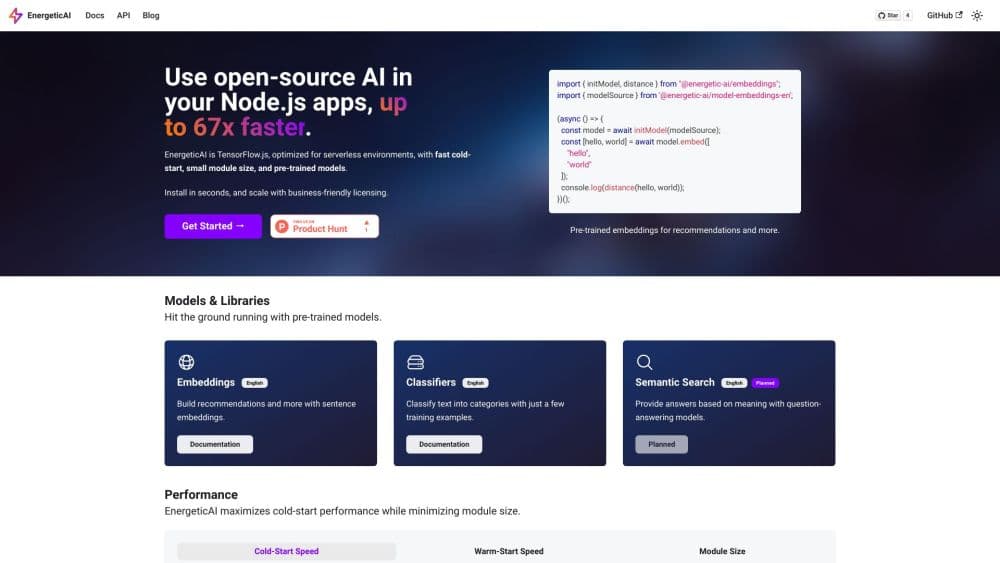
À propos de EnergeticAI
What Is EnergeticAI
EnergeticAI est une version allégée de TensorFlow.js, empaquetée pour les fonctions serverless du type AWS Lambda, Vercel Functions ou Netlify Functions. Le problème qu'il règle est très concret. La bibliothèque d'origine pèse entre 146 Mo et 513 Mo non compressés, ce qui fait sauter la limite de taille du paquet avant même que votre code s'exécute. Les poids du modèle se téléchargent en plus au premier appel, et le démarrage dépasse alors les deux secondes.
Le projet garde le strict nécessaire pour l'inférence. Le module tombe autour de 3 Mo, le démarrage à froid reste proche de 50 ms selon la mesure de l'équipe, et le paquet central remplace directement @tensorflow/tfjs-core. Votre code et vos modèles existants fonctionnent donc généralement sans réécriture.
Les limites comptent autant que les gains. Les modèles pré-entraînés couvrent uniquement les embeddings et la classification de texte en anglais, la recherche sémantique reste annoncée comme prévue, et tout tourne sur WebAssembly sans accès au GPU. La version npm est la 0.2.0, publiée en juin 2023 : voyez le projet comme stable mais peu actif, pas comme une plateforme en pleine croissance.
Getting Started
- Installez Node 18 ou une version plus récente, puis ajoutez le paquet central et la bibliothèque de modèles voulue :
npm install @energetic-ai/core @energetic-ai/embeddings @energetic-ai/model-embeddings-en. - Importez
initModeldepuis la bibliothèque de modèles avec la source correspondante, et chargez les poids une fois par instance de fonction. - Appelez
model.embed()sur un tableau de chaînes pour obtenir des vecteurs, ou passez par le paquet de classificateurs et entraînez sur quelques exemples étiquetés. - Comparez les vecteurs avec l'utilitaire
distance, puis injectez le score dans votre logique de classement, de filtrage ou de routage. - Déployez chez votre hébergeur serverless et vérifiez la taille du paquet, puisque cette limite est justement la raison du passage à EnergeticAI.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de EnergeticAI.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs Node.js qui cherchent de l’IA pour serverless
- Indépendants et petites équipes
- Équipes soumises à des règles strictes sur les données
- Développeurs backend qui posent leur première brique d'IA
Tâches
- Construire des recommandations produit à partir d'embeddings
- Trier des tickets de support ou des formulaires avec un classificateur de texte entraîné sur quelques dizaines d'exemples étiquetés.
- Regrouper avis, retours ou annonces en doublon en comparant les distances entre vecteurs plutôt qu'en écrivant des règles de mots clés.
- Ajouter une couche légère de recherche sémantique sur quelques centaines de documents, à condition d'accepter que les modèles dédiés soient encore annoncés comme prévus.
Cas d'usage
- Déployer sur une offre gratuite ou bas de gamme avec un plafond de paquet, où un module de 3 Mo fait la différence entre publier et renoncer.
- Faire tourner l'inférence sur des textes qui ne peuvent pas partir vers une API externe, comme des tickets internes, des notes médicales ou des données clients sous contrat.
- Prototyper une fonctionnalité d'IA sur un portable et pousser le même code en production sans réécrire la couche modèle autour du SDK d'un fournisseur.
Fonctionnalités clés
Empaquetage pensé pour le serverless
Tout le projet s'organise autour des contraintes des plateformes de fonctions. Le module descend à environ 3 Mo, une taille qui tient dans les limites habituelles de Lambda et des environnements de périphérie où TensorFlow.js échoue. Les poids voyagent dans le paquet au lieu d'être téléchargés au premier appel, si bien qu'un conteneur froid n'attend pas le réseau pour répondre.
Démarrage à froid
Le site annonce jusqu'à 67 fois plus rapide que TensorFlow.js dans les fonctions serverless, en mesurant l'initialisation du modèle et l'embedding d'un paragraphe de cinq phrases sur un MacBook Pro M1 Max. Vos chiffres varieront selon l'hébergeur et la taille de l'entrée. L'ordre de grandeur reste le même : des dizaines de millisecondes au lieu de secondes, ce qui décide si une requête expire.
Modèle d'embeddings pré-entraîné
Le paquet d'embeddings transforme des chaînes en vecteurs que vous pouvez comparer, regrouper ou classer. Le modèle anglais arrive dans un paquet de poids séparé, donc vous n'installez que la langue nécessaire. C'est le chemin le plus court vers des recommandations et de la similarité de texte sans rien entraîner.
Classificateur de texte few-shot
Le paquet de classificateurs s'entraîne à l'exécution sur un petit ensemble d'exemples étiquetés. Il convient au routage et à l'étiquetage quand vous disposez de 20 ou 50 cas plutôt que d'un jeu de données complet. Les libellés restent dans votre dépôt et le modèle se réentraîne à chaque déploiement, ce qui versionne le comportement avec le code.
Compatibilité directe avec TensorFlow.js
Le module central reprend l'API de @tensorflow/tfjs-core, si bien que les imports et le code de modèle existants continuent généralement de fonctionner. Vous pouvez tester sur un seul endpoint avant d'engager tout le service, ce qui réduit le coût de l'essai.
Backend WebAssembly
L'inférence passe par WebAssembly, assez rapide pour des entrées courtes et disponible sur n'importe quel hôte Node sans compilation native. Aucune accélération GPU n'est proposée : les gros lots et les documents longs prennent nettement plus de temps que sur une machine équipée de CUDA.
Avantages et inconvénients
Avantages
- Ramène le paquet de plusieurs centaines de mégaoctets à environ 3 Mo, souvent la seule façon de publier un modèle sur une offre serverless.
- Le démarrage à froid reste proche de 50 ms dans la mesure du projet, et la requête utilisateur n'attend pas le chargement du modèle.
- Licence Apache 2.0 et modèles pré-entraînés choisis sous des termes comparables, ce qui simplifie l'usage commercial.
- Aucun coût par appel et aucune donnée envoyée hors de votre fonction, une vraie différence avec les API d'embeddings hébergées.
- Le paquet central s'insère dans du code TensorFlow.js existant, donc la migration se résume souvent à changer une dépendance.
Inconvénients
- Les modèles pré-entraînés n'existent qu'en anglais, un produit multilingue doit donc fournir ses propres poids et les tester.
- Sans GPU, les gros lots ralentissent, et un long corpus peut coûter plusieurs secondes par requête sur une petite fonction.
- Le catalogue reste court : embeddings et classificateurs aujourd'hui, recherche sémantique toujours annoncée comme prévue.
- La version npm est la 0.2.0 de juin 2023 : vous adoptez un projet au rythme de publication lent, donc figez les versions et lisez le code en cas de problème.
Questions fréquentes
Il exécute des modèles d'IA open source dans des fonctions serverless. Les usages courants sont les recommandations produit, la classification de texte, la détection de doublons et la recherche sémantique dans des backends Node.js incapables d'embarquer une pile machine learning complète.
Contenus associés
Découvrez des outils, des compétences et des articles liés à EnergeticAI.
Alternatives à EnergeticAI

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.