
extract by Firecrawl
Firecrawl · Programmation
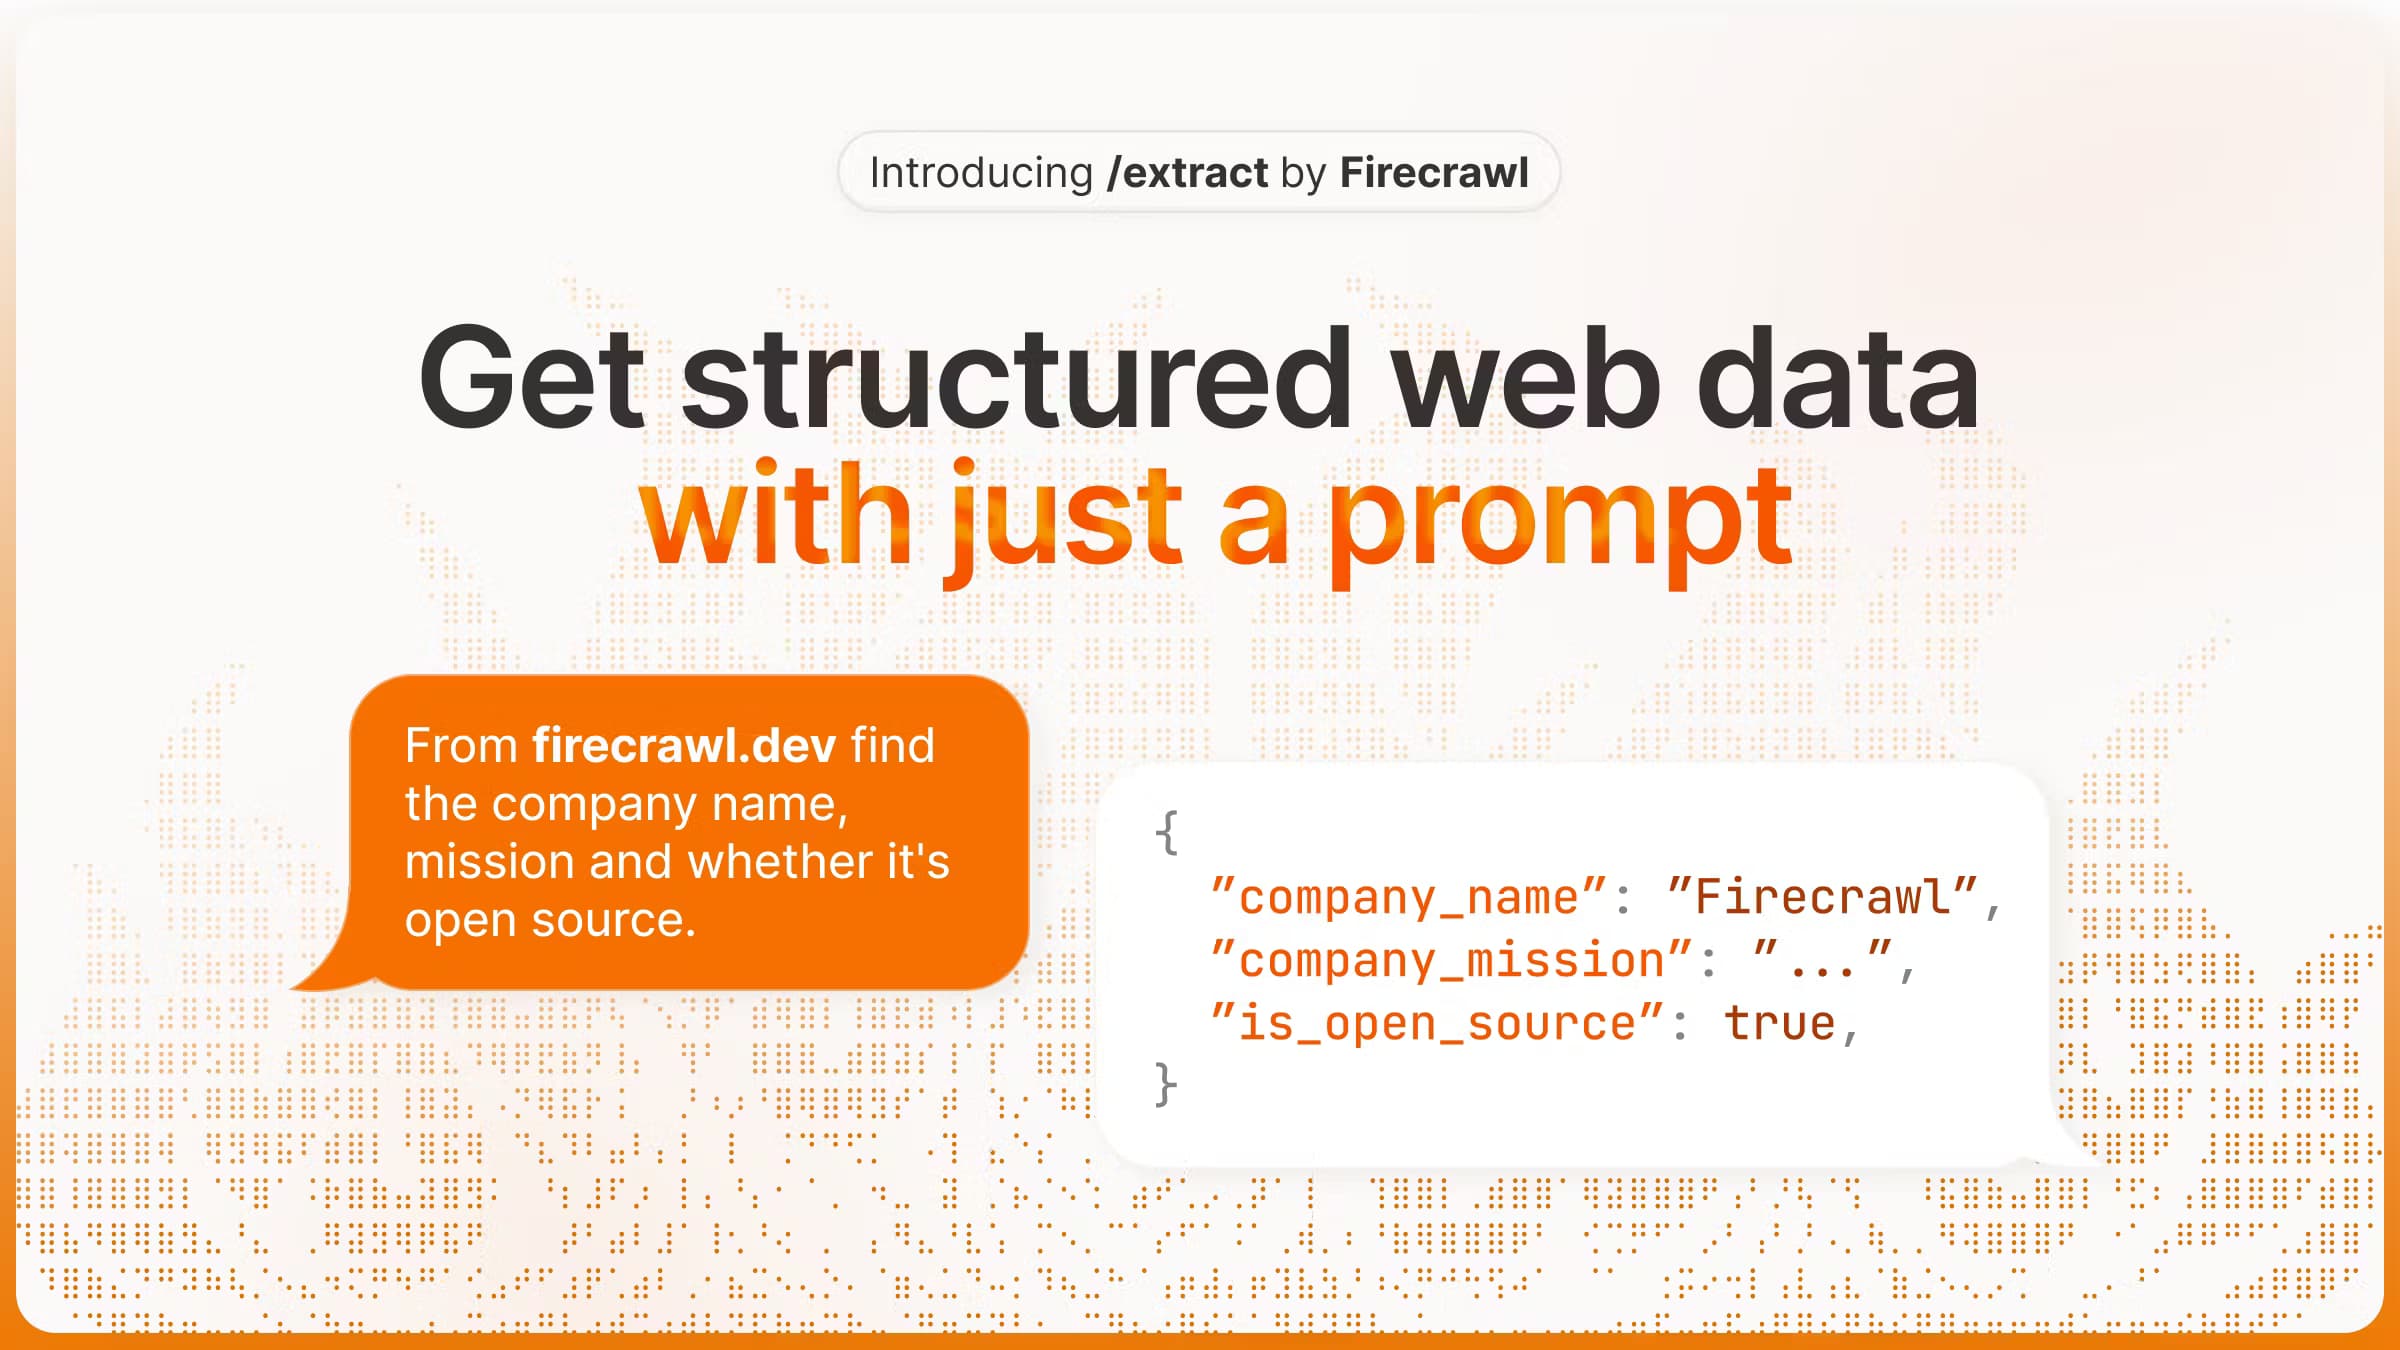
extract by Firecrawl est l'endpoint de l'API Firecrawl qui transforme n'importe quelle URL ou un domaine entier en JSON structuré. Vous fournissez des liens plus un prompt ou un schéma, et il renvoie les champs demandés.
À propos de extract by Firecrawl
What Is extract by Firecrawl
extract by Firecrawl est l'endpoint /extract de Firecrawl, une API de données web pensée pour les applications d'IA. Il aspire les pages que vous lui indiquez, puis s'appuie sur un modèle de langage pour en tirer des champs précis en JSON. Plutôt que d'écrire des sélecteurs à la main pour chaque site, vous décrivez les données en langage courant ou vous fournissez un schéma JSON, et Firecrawl renvoie les valeurs déjà rangées.
L'endpoint gère les côtés pénibles du scraping : pages lourdes en JavaScript, défenses anti-bots et changements de mise en page d'un site à l'autre. Vous pouvez viser une page, une liste ou un domaine entier avec un joker comme example.com/*, et Firecrawl explore ce qu'il trouve avant d'extraire. C'est l'outil des équipes qui ont besoin de fiches, de prix ou de données d'entreprise répétables, directement vers une base de données ou un flux en aval.
Deux limites cadrent l'usage. extract tourne comme une tâche asynchrone : vous envoyez les URL et interrogez un identifiant de tâche pour les résultats, au lieu d'obtenir une réponse instantanée. Et Firecrawl oriente désormais les nouveaux projets vers /agent, son successeur, qui trouve lui-même ses URL. extract fonctionne encore, mais c'est le chemin plus ancien.
Getting Started
- Créez un compte sur firecrawl.dev et copiez votre clé API depuis le tableau de bord
- Installez le SDK (pip install firecrawl-py ou npm install firecrawl) et initialisez un client avec la clé
- Appelez extract avec une liste d'URL, un prompt décrivant les champs ou un schéma JSON si vous voulez une forme figée
- Lisez les données renvoyées, ou interrogez l'identifiant de tâche si vous avez utilisé la méthode de démarrage pour de longues exécutions
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de extract by Firecrawl.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs qui bâtissent des applications d'IA
- Équipes data et analytique
- Fondateurs en étude de marché
- Bricoleurs d'automatisation
Tâches
- Extraire des fiches sur beaucoup de pages
- Transformer des pages en désordre en JSON
- Surveiller les prix et la disponibilité
- Constituer des bases de connaissances pour le RAG
- Croiser les données de plusieurs sources
Cas d'usage
- Une équipe de recherche suit les prix des concurrents chaque semaine
- Un développeur donne des faits web récents à un assistant d'IA
- Un fondateur sonde un marché pour la première fois
- Une équipe d'exploitation tient un annuaire à jour
- Un ingénieur data normalise des sources éparpillées
Fonctionnalités clés
Extraction de données structurées par prompt ou par schéma
extract fonctionne de deux façons. Vous pouvez écrire un prompt en langage naturel qui décrit les données voulues, et le modèle choisit une forme sensée. Ou vous fournissez un schéma JSON, pour que chaque fiche revienne avec les champs et types exacts que vous avez définis. Les équipes qui veulent une forme stable pour une base de données choisissent le schéma ; celles qui explorent un site inconnu partent d'un prompt et le resserrent ensuite.
Extraction sur tout un domaine avec jokers
Vous pouvez viser extract sur une seule page, une courte liste ou un site entier. Une URL avec joker, comme example.com/*, indique à Firecrawl d'explorer le domaine et de lire chaque page trouvée avant d'extraire les champs. Une recherche sur tout un site tient donc en un appel, sans que vous montiez la liste d'URL vous-même. Le mode domaine complet est marqué expérimental, donc mieux vaut vérifier les résultats.
Enrichissement par recherche web
Activer l'option de recherche web laisse l'extraction dépasser les URL fournies. Firecrawl suit des pages liées pour combler un contexte manquant, utile quand une seule page ne porte pas tout ce qu'il vous faut. Un exemple documenté tire prix, fonctions et avis de dashcams en partant d'une fiche produit et en laissant la recherche élargir le filet.
Tâches asynchrones avec suivi de statut
extract tourne comme une tâche, pas comme un appel bloquant. Vous envoyez la requête et recevez un identifiant de tâche, puis vous interrogez l'endpoint de statut jusqu'à ce qu'il signale « completed ». Les états sont completed, processing, failed et cancelled, ce qui permet de l'accrocher à une file ou à un worker en arrière-plan. Les résultats de la tâche restent accessibles par l'API pendant 24 heures après la fin.
SDK officiels pour Python et Node
Firecrawl publie des SDK pour Python et Node, donc vous n'écrivez pas les appels HTTP à la main. Le client Python accepte un modèle Pydantic comme schéma, et le client Node prend un objet Zod, ce qui donne une sortie typée et validée. Les deux offrent une méthode de démarrage qui renvoie un identifiant de tâche tout de suite, plus une méthode de statut pour récupérer les résultats quand la tâche se termine.
Facturation en crédits, partagée entre endpoints
extract facture désormais en crédits, la même monnaie que les autres endpoints. Les tarifs des offres Firecrawl suivent cette logique de crédits. Un crédit vaut 15 jetons (tokens) sur extract, alors qu'un scrape de base coûte 1 crédit par page. Les crédits sont partagés entre tous les endpoints : résultats de recherche et pages aspirées puisent dans un seul solde. Le budget devient donc plus prévisible quand une tâche mêle extraction et exploration.
Un chemin de migration documenté vers Agent
Firecrawl présente extract comme l'outil plus ancien et dirige les nouveaux projets vers /agent, son successeur. Agent garde les options de prompt et de schéma, mais abandonne l'exigence d'URL, ce qui lui permet de chercher et de naviguer seul. Si votre besoin est « trouvez ces données quelque part sur le web », Agent est la voie ; si vous connaissez déjà les URL, extract fait encore le travail.
Avantages et inconvénients
Avantages
- La sortie par prompt ou schéma JSON vous évite d'écrire des sélecteurs à la main pour chaque site
- Les URL avec joker laissent une tâche couvrir un domaine entier, sans monter la liste de pages vous-même
- Les SDK officiels Python et Node prennent en charge Pydantic et Zod pour des résultats typés et validés
- La facturation en crédits est partagée entre endpoints, ce qui rend le budget prévisible quand une tâche mêle plusieurs travaux
- Un palier gratuit avec 1 000 crédits par mois couvre les tests légers sans carte bancaire
Inconvénients
- L'extraction est asynchrone, donc impossible de l'insérer dans une requête qui exige une réponse instantanée
- Firecrawl oriente désormais les nouveaux venus vers Agent, donc extract est le chemin plus ancien et reste derrière l'outil récent
- L'extraction sur tout un domaine avec joker est marquée expérimentale, donc les explorations larges peuvent demander une vérification des résultats
- Les résultats de la tâche disparaissent de l'API au bout de 24 heures, ce qui laisse le stockage longue durée à votre charge
- Les pages qui renvoient un statut d'erreur comme 403 ou 404 coûtent quand même un crédit
Questions fréquentes
C'est l'endpoint /extract de Firecrawl, une API de données web. Vous lui donnez des URL plus un prompt ou un schéma JSON, et un modèle de langage renvoie les champs demandés en JSON structuré. Il sert à tirer des fiches répétables de pages qui ne partagent pas une mise en page fixe.
Contenus associés
Découvrez des outils, des compétences et des articles liés à extract by Firecrawl.
Alternatives à extract by Firecrawl
Forefront
Forefront · ProgrammationForefront est une plateforme web pour construire avec de l'IA open source. Elle vous laisse affiner les principaux modèles de langage open source sur vos propres données, évaluer leurs performances et les exécuter via une API ou les exporter pour les héberger vous-même. Les développeurs qui veulent le confort d'une plateforme fermée mais tiennent à rester propriétaires de leurs modèles et de leurs données sont le public visé ici.

Startkit
StartKit.AI · ProgrammationStartkit est un boilerplate pour créer des produits SaaS d'IA et des wrappers d'IA. Voyez-le comme un boilerplate de startup IA avec les parties ennuyeuses déjà branchées : authentification, paiements Stripe et Lemon Squeezy, limites d'usage, e-mail transactionnel et un kit de démarrage d'API IA qui parle à OpenAI, Anthropic, Groq ou Llama. Vous clonez le dépôt, fixez votre prix et attaquez la partie du produit pour laquelle les gens paient vraiment. Il repose sur Next.js au-dessus de React et Tailwind, donc une bonne partie du code boilerplate vous semble déjà familière.
Testim
Tricentis · ProgrammationTestim est une plateforme d'automatisation des tests dopée à l'IA, qui sert à créer et exécuter des tests de bout en bout sur des applications web, mobiles et Salesforce. Elle s'appuie sur l'apprentissage automatique pour garder les tests stables quand une interface change, alors les équipes passent moins de temps à réparer des sélecteurs cassés. Pas mal pour un outil de tests automatisés que vous pouvez utiliser dès aujourd'hui. Vous créez des tests en enregistrant des actions dans un navigateur, puis vous ajoutez du JavaScript quand vous avez besoin de plus de contrôle. C'est un choix solide pour une équipe QA bien occupée.