
Finetunefast
FinetuneFast · Image · Autres
FinetuneFast est un ensemble de modèles de code pour affiner les modèles d'image, LLM et multimodaux : entraînement, préparation des données, déploiement et exemples de RAG pour livrer plus vite une app IA.
À propos de Finetunefast
What Is FinetuneFast
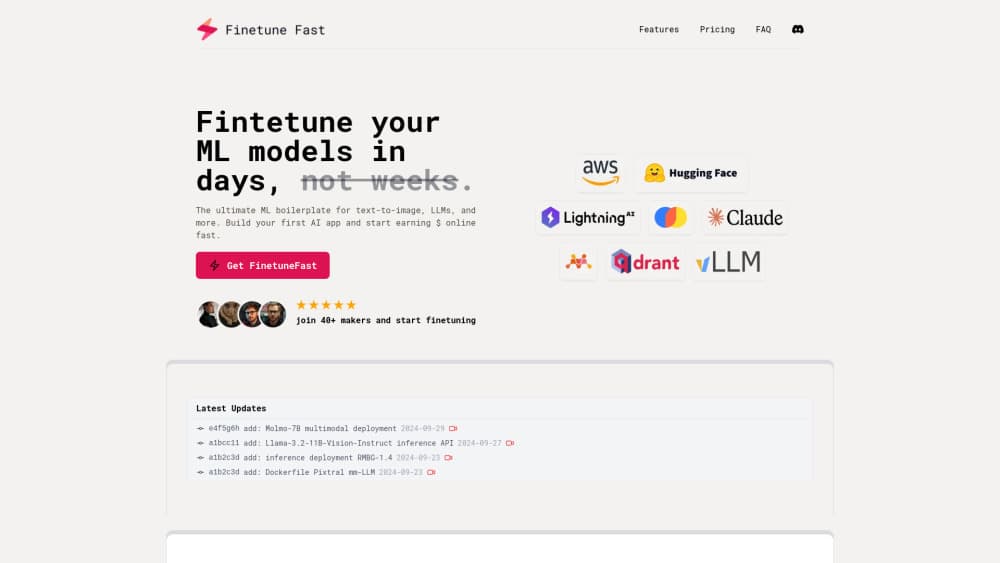
FinetuneFast vend une collection de modèles de code déjà terminés pour qui veut affiner un modèle de machine learning sans monter tout le processus soi-même. L'affinage, ou fine-tuning, consiste à reprendre un modèle déjà entraîné et à le réentraîner sur vos propres données pour qu'il s'adapte à une tâche précise, qu'il s'agisse d'un style artistique personnel ou d'un chatbot de support qui parle comme votre entreprise.
Le projet a été lancé par Patrick, un ingénieur ML qui a construit l'outil après des années à préparer des entraînements à la main. L'affinage d'un modèle d'image est l'usage le plus visible, mais la voie sert aussi au texte et au multimodal. Le produit chiffre les heures qu'un affinage classique consume avant de livrer quoi que ce soit : environ quatre pour configurer l'environnement, six pour nettoyer les données, quatre pour intégrer les API, deux pour évaluer, trois pour déployer, et un temps sans fin pour faire monter l'infrastructure quand le modèle grandit. FinetuneFast range ces étapes dans des scripts déjà configurés : on saute la plomberie et on consacre le temps au modèle.
Les cas d'usage vont d'un style artistique personnel à un chatbot de support. Les limites comptent. C'est une bibliothèque de modèles, pas une plateforme hébergée avec un tableau de bord. On exécute toujours le code, on branche son propre GPU ou son cloud, et il faut être à l'aise avec un terminal ou un notebook. Les modèles de code privilégient les modèles ouverts et les flux courants, donc une architecture inhabituelle peut demander du travail en plus. Les nouveautés arrivent via une communauté Discord et, sur l'offre la plus chère, avec des mises à jour à vie.
Getting Started
- Achetez une offre sur finetunefast.com, puis téléchargez les fichiers. Il n'y a pas de version gratuite et le paiement est unique, pas mensuel.
- Ouvrez les notebooks ou les scripts d'entraînement et pointez-les vers votre jeu de données. Les pipelines de chargement attendent les fichiers au format documenté.
- Choisissez le modèle de base et les options d'entraînement. Pour l'image ou le LLM, vous partez en général d'un checkpoint, LoRA ou affinage complet, puis vous réglez les hyperparamètres.
- Lancez l'entraînement sur votre propre GPU. La prise en charge multi-GPU est incluse, de quoi répartir un gros travail sur plusieurs cartes.
- Déployez le modèle avec le code d'inférence, qui génère un point d'accès API et met en place la supervision et les journaux.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Finetunefast.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs indépendants et makers
- Petites équipes IA au budget serré
- Ingénieurs ML lassés de la configuration
- Fondateurs qui montent un SaaS IA
Tâches
- Affiner un modèle d'image
- Affiner un LLM
- Préparer les données d'entraînement
- Déployer un modèle derrière une API
- Ajouter de la recherche à une app IA
Cas d'usage
- Un designer qui entraîne un modèle d'image sur son style
- Un développeur qui lance un SaaS IA
- Un chercheur qui mène des expériences contrôlées
- Un amateur qui apprend l'affinage
Fonctionnalités clés
Modèles de code d'entraînement
Le cœur du produit, ce sont des scripts d'entraînement déjà configurés pour les modèles d'image, LLM et multimodaux. Au lieu d'écrire une boucle d'entraînement et de monter un chargeur de données à la main, vous réglez quelques options et vous lancez. Les scripts couvrent ce qui casse en premier, comme le chargement efficace des données et les outils d'hyperparamètres.
Pipelines de préparation des données
L'affinage bloque presque toujours sur des données en désordre, et les modèles de code traitent cette étape comme centrale. Les pipelines nettoient, formatent et organisent vos fichiers avant l'entraînement, la tâche que le produit lui-même estime à environ six heures par projet. Il faut toujours de bonnes données, mais la plomberie est déjà écrite.
Entraînement multi-GPU
La prise en charge multi-GPU fonctionne sans réglage, donc un gros affinage n'a pas à tourner sur une seule carte. Vous répartissez le travail sur les GPU disponibles, vous raccourcissez les longs entraînements et vous exploitez un matériel déjà loué.
Déploiement en un clic et mise à l'échelle automatique
Le code d'inférence prend un modèle entraîné et monte le chemin de service : déploiement en un clic, infrastructure à mise à l'échelle automatique, point d'accès API généré, supervision et journaux. De quoi combler l'écart entre un checkpoint dans un notebook et un modèle que votre app peut vraiment appeler.
Modèles d'inférence et de RAG
À côté du code d'entraînement, le paquet livre des modèles d'inférence prêts pour la production et des exemples de RAG. Le RAG, ou génération augmentée par recherche, permet à une app IA de puiser dans des documents externes pour que ses réponses s'appuient sur votre propre contenu. Ces modèles transforment un modèle affiné en fonctionnalité du produit.
Affinage sans code
Pour qui ne veut pas toucher au code d'entraînement, une voie sans code résout les étapes de l'affinage via une configuration guidée. Elle vise les makers plus intéressés par le résultat que par les rouages, et elle cohabite avec la voie tout-code plutôt que de la remplacer.
Avantages et inconvénients
Avantages
- Réduit le temps de configuration, de préparation et de déploiement qui domine un premier projet d'affinage, selon les heures chiffrées par le produit.
- Paiement unique avec projets illimités, donc le coût ne grimpe pas avec le nombre de modèles entraînés.
- Couvre tout le trajet, de l'entraînement à un point d'accès servi, avec des exemples de RAG dont presque toute app IA a besoin.
- L'offre All In ajoute le support Discord et les mises à jour à vie, utile si vous comptez continuer à construire.
Inconvénients
- Pas de version gratuite, donc impossible de tester les modèles de code avant de payer.
- C'est une bibliothèque de code, pas une plateforme gérée : vous apportez votre GPU ou votre cloud et vous continuez à tout exécuter vous-même.
- Le support est communautaire sur Discord, ce qui veut dire que l'aide dépend de qui est connecté, sans délai de réponse garanti.
- Les modèles de code tirent vers les modèles ouverts et les flux courants, donc un montage inhabituel peut demander du code que vous écrivez.
Questions fréquentes
Il fournit du code prêt à l'emploi pour affiner et déployer des modèles ML : scripts d'entraînement, pipelines de données, déploiement et exemples de RAG pour l'image, le LLM et le multimodal. Vous achetez les modèles de code et les exécutez sur votre matériel.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Finetunefast.
Alternatives à Finetunefast

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

Tractionwave
TractionWave · Image · MarketingTractionWave produit une carte de chaleur d'attention par IA pour les annonces statiques. Vous déposez un PNG ou un JPG, et vous obtenez l'attention prévue, des points chauds classés et des corrections avant de dépenser.

Imejis.io
Imejis.io · Image · MarketingImejis.io est un studio de design IA pour les agents et les équipes marketing. Vous décrivez une image avec vos mots, l'outil écrit le texte, construit la mise en page, l'adapte à chaque format et exporte le fichier final.