
Fish Speech
Fish Audio · Voix et langage · Vidéo
Fish Speech est le modèle text to speech open source de Fish Audio, aujourd'hui livré sous le nom Drama 3 : clonage vocal en 10 à 30 secondes, 83 langues et balises d'émotion.
À propos de Fish Speech
About
Qu'est-ce que Fish Speech
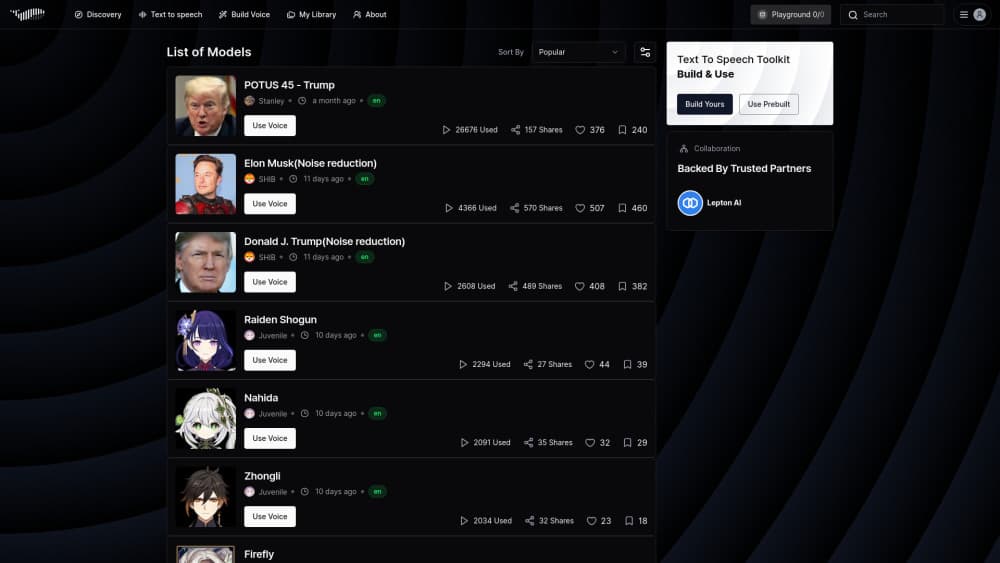
Fish Speech est un modèle text to speech open source développé par Fish Audio, l'entreprise derrière la plateforme fish.audio. Le nom recouvre deux choses livrées ensemble : les poids du modèle sur Hugging Face et le code sur GitHub, plus le service hébergé qui fait tourner ces mêmes modèles derrière un site et une API. Vous pouvez vous inscrire et l'utiliser comme n'importe quel générateur vocal IA, ou télécharger les poids et garder toute l'infrastructure chez vous.
La famille a évolué vite. Fish Speech 1.x et OpenAudio S1 ont posé la promesse : cloner une voix à partir d'un court extrait et piloter le ton en langage courant. S2 et S2.1 Pro ont gagné en précision et en streaming. Drama 3, publié le 13 octobre 2026, est le modèle actuel : 35B de paramètres dont 3B actifs par token, avec en plus l'édition locale de l'audio et la révision par tours.
Ce qu'il corrige, c'est l'écart entre l'ouvert et le fini. Presque tous les projets TTS open source sonnent plats face aux outils commerciaux, et presque tous les outils commerciaux vous obligent à passer par leur cloud. Ici les deux portes restent ouvertes : les poids se téléchargent sous licence communautaire Fish Audio, qui autorise l'usage commercial aux entreprises réalisant moins de 500 000 dollars de revenus annuels, et les offres hébergées démarrent gratuitement.
Les limites comptent aussi. L'auto-hébergement demande un GPU NVIDIA et un peu de patience avec les environnements Python. La qualité du clone suit la propreté de l'extrait de référence : un enregistrement avec du bruit de fond donne un clone avec du bruit de fond. Et l'essentiel des chiffres de benchmark vient des tests de Fish Audio ; Artificial Analysis reste la comparaison indépendante la plus solide aujourd'hui.
Pour commencer
- Ouvrez fish.audio et créez un compte gratuit. L'offre gratuite couvre environ 7 minutes d'audio par mois, de quoi juger si les voix conviennent à votre projet.
- Choisissez une voix dans la bibliothèque ou clonez la vôtre. Pour un clone, envoyez 10 à 30 secondes de parole nette, sans musique ni réverbération de pièce.
- Collez votre script dans la zone de texte et placez les balises de direction là où l'intention change, par exemple [whisper] avant une réplique ou [laughing] après.
- Générez, écoutez, puis ajustez les balises avant de réécrire le texte. Changer une balise modifie davantage le rendu qu'une phrase reformulée.
- Pour l'auto-hébergement, clonez le dépôt GitHub, installez l'environnement, récupérez les poids sur Hugging Face et lancez l'interface web ou le serveur API sur une machine équipée d'une carte NVIDIA récente.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Fish Speech.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Créateurs YouTube et podcasteurs
- Développeurs de jeux et d'animation
- Développeurs qui ajoutent de la voix à un produit
- Équipes de localisation
Tâches
- Doubler une vidéo dans une autre langue
- Maquetter des dialogues de personnage
- Transformer un article en audio
- Ajouter une couche vocale à un prototype
Cas d'usage
- Tester une idée avant de payer un studio
- Tenir une chaîne sur plusieurs marchés
- Livrer une démo dans un délai serré
Fonctionnalités clés
Clonage vocal à partir d'un court extrait
10 à 30 secondes d'audio de référence suffisent pour reproduire un timbre, et Fish Audio annonce 15 secondes sur sa page d'accueil. Le clone retient l'accent, la hauteur et le rythme de parole, pas seulement une impression générale. Un fichier mono enregistré près du micro donne le meilleur résultat ; la musique de fond est le moyen le plus rapide de tout gâcher.
Balises de direction dans le texte
Le rendu se pilote avec des instructions entre crochets, placées là où l'humeur change : [whispering], [angry], [sighing], [laughing], [pause]. Drama 3 accepte aussi la direction libre, donc [barely holding it together, forcing a smile] fonctionne comme balise. Les balises par paires, comme celles d'emphase, ne dirigent que quelques mots dans la phrase. C'est la vraie différence avec les anciens moteurs, où l'on réglait vitesse et hauteur en espérant que ça passe.
Large couverture linguistique
Drama 3 parle 83 langues, bien au-delà des 13 gérées par Fish Speech 1.5. Cela le place parmi les modèles TTS multilingues les plus larges que l'on peut télécharger. Le point clé reste le clonage entre langues : vous clonez une voix une fois et générez dans une autre langue en conservant l'identité du locuteur. Les balises de direction s'écrivent dans la langue où vous pensez, et le modèle les applique quand même.
Plusieurs voix dans une même scène
Un seul texte peut contenir plusieurs personnages repérés par des identifiants de locuteur, et le modèle génère tout l'échange d'une traite. Pour la fiction audio, les cinématiques de jeu ou une vidéo à deux présentateurs, cela supprime la boucle générer, coller, recaler qui rendait le travail multi-voix pénible.
Édition locale et révision par tours
Drama 3 permet de retoucher une prise terminée comme un document. Remplacez un mot et le timbre ainsi que les transitions alentour restent intacts, ce qui évite de régénérer cinq minutes d'audio pour une seule erreur. La révision par tours va dans l'autre sens : vous indiquez que la dernière prise devrait être plus douce ou plus triste, et le modèle la reprend avec ce contexte.
Poids ouverts et auto-hébergement
Le code et les poids sont publics, et la licence communautaire autorise l'usage commercial sous 500 000 dollars de revenus annuels. Pour une équipe avec des contraintes de confidentialité ou un volume prévisible, l'option est sérieuse : l'inférence locale ne facture pas au caractère. En échange, il faut du matériel, du temps d'installation et l'entretien d'une pile Python.
API en streaming à faible latence
L'API hébergée émet l'audio pendant la génération, avec un premier son autour de 100 ms et un facteur temps réel de 0,195 sur une H200 selon les mesures de Fish Audio. Synthèse vocale, reconnaissance vocale et endpoint d'agent vocal partagent la même clé. Sur un produit conversationnel, cette latence sépare un assistant qui coupe la parole d'un assistant qui attend son tour.
Avantages et inconvénients
Avantages
- Le clonage fonctionne avec une référence courte, donc pas besoin de séance studio pour obtenir une voix utilisable.
- L'émotion et le débit se pilotent avec des balises en langage courant, bien plus rapide à itérer que des curseurs de paramètres.
- L'offre gratuite et les poids ouverts offrent deux façons peu coûteuses d'évaluer le modèle avant de payer.
- 83 langues avec clonage inter-langues couvrent une bonne part du travail de localisation avec une seule identité vocale.
- La latence de streaming et une API ouverte le rendent viable dans un vrai produit, pas seulement pour des fichiers isolés.
Inconvénients
- L'auto-hébergement exige un GPU NVIDIA et de l'aisance avec les environnements Python, ce qui exclut l'utilisateur occasionnel.
- La qualité du clone dépend fortement de l'audio de référence : un enregistrement bruyant donne un résultat sourd, sans outil de nettoyage intégré.
- La licence communautaire plafonne l'usage commercial gratuit aux entreprises sous 500 000 dollars de revenus annuels, donc les plus grandes doivent négocier un accord.
- Presque tous les benchmarks publiés viennent du fabricant, et les comparaisons indépendantes mesurent la prononciation, pas l'étendue émotionnelle.
Questions fréquentes
Oui. Le service hébergé propose une offre gratuite d'environ 7 minutes de génération par mois, et les poids se téléchargent sans frais. L'usage commercial des poids ouverts reste libre pour les organisations sous 500 000 dollars de revenus annuels.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Fish Speech.
Alternatives à Fish Speech

Foley
Hanamori Labs, LLC · Voix et langage · Productivité · Assistant d’IAFoley est une liste de tâches vocale qui transforme une phrase prononcée en tâche classée, projet, date et heure compris, puis vous aide à organiser la journée à partir de ce qui est déjà noté.

HireKey
HireKey · Voix et langage · Productivité · ApprentissageHireKey est un copilote de recherche d'emploi IA conçu par une ancienne recruteuse tech. Il évalue l'adéquation au poste, adapte le CV, entraîne aux entretiens et suit chaque candidature.

Fluence
Yay Software (Yannick Huchard) · Rédaction · Voix et langage · ProductivitéFluence est une application Android qui lit à voix haute vos PDF, EPUB, fichiers Word et articles web, suit la phrase prononcée et répond aux questions sur le texte sans quitter le téléphone.