
Fuzzy Match
Radix Analytics Pvt Ltd · Programmation
Fuzzy Match est un outil web de rapprochement de données qui charge des fichiers CSV ou Excel et repère les noms proches, les fautes de frappe et les variantes d'orthographe dans les colonnes choisies.
À propos de Fuzzy Match
What Is Fuzzy Match
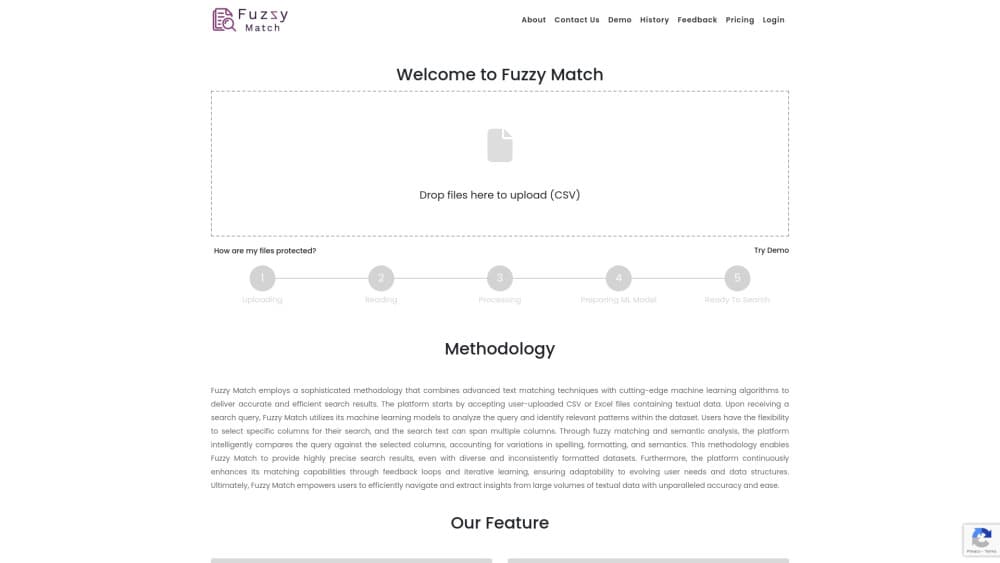
Fuzzy Match est une application web de Radix Analytics qui compare le texte saisi à un fichier importé. Vous désignez les colonnes à interroger, vous envoyez un nom, une adresse ou une référence produit, et l'outil renvoie les lignes proches de votre requête, y compris celles qui comportent des fautes de frappe ou une mise en forme différente.
Le produit s'attaque à un problème très courant au bureau: deux listes qui décrivent les mêmes entités et ne s'accordent jamais sur l'orthographe. Un client apparaît comme « Jon Smith » dans un export et comme « John Smyth » dans un autre. Avec un outil de correspondance floue de ce type, vous retrouvez ces paires sans écrire de SQL ni de Python.
C'est une console de recherche, pas une suite complète de nettoyage de données. Vous obtenez des correspondances classées et un historique des exécutions, mais pas un flux qui reconstruit un enregistrement maître. Chaque offre limite aussi la taille du fichier, le nombre de fichiers et le volume de résultats, donc les jeux de données très volumineux doivent être découpés avant l'import.
Getting Started
- Ouvrez fuzzymatch.in et testez la démo sans compte, ou connectez-vous pour débloquer les limites de l'offre gratuite.
- Importez un fichier CSV ou Excel et attendez que le service lise les lignes et prépare son modèle de comparaison.
- Sélectionnez les colonnes à interroger, puis saisissez le nom, l'adresse ou le code recherché.
- Parcourez les résultats classés, reformulez la requête si besoin et retrouvez l'exécution dans l'historique.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Fuzzy Match.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Analystes data
- Responsables opérations et CRM
- Petites équipes sans développeur
Tâches
- Déduplication d'une liste de clients
- Rapprochement d'adresses
- Nettoyage de catalogue
- Nettoyage de données avant reporting
Cas d'usage
- Audit ponctuel d'un fichier
- Contrôles fournisseurs mensuels
- Revue avant migration
Fonctionnalités clés
Une correspondance floue qui encaisse les fautes de frappe
Le moteur compare votre requête à chaque ligne et renvoie encore une correspondance quand des lettres manquent, s'ajoutent ou s'inversent. Cela compte pour le rapprochement d'enregistrements saisis à la main, où la première faute fait échouer un filtre exact.
Le contrôle des colonnes interrogées
Vous choisissez les colonnes lues par le moteur, et une même requête peut en couvrir plusieurs. Limiter la recherche à la colonne des noms réduit le bruit des notes et des champs libres, et la liste classée reste assez courte pour être relue.
Du machine learning plutôt que des listes de règles
Fuzzy Match présente sa comparaison comme un modèle entraîné sur le fichier, pas comme un ensemble figé d'exceptions. En pratique, cela aide quand le format varie d'une ligne à l'autre.
Des boucles de retour
La plateforme recueille vos avis sur les correspondances et s'en sert pour affiner les exécutions suivantes. Si vous signalez une paire erronée, le modèle reçoit un signal, et c'est la principale raison de se connecter plutôt que d'utiliser la démo anonyme.
Historique et gestion de la conservation
Chaque exécution apparaît dans un historique, et vous pouvez supprimer des fichiers avant leur expiration. La conservation dépend de l'offre: 24 heures en gratuit, puis 7, 15 ou 30 jours à mesure que vous montez en gamme.
Des limites par offre et des modèles sur mesure
Les paliers gratuit et payants diffèrent par la taille des fichiers, le nombre de résultats, le stockage et le quota mensuel de fichiers. Premium ajoute un modèle de ML entraîné sur vos données, taillé pour les équipes dont les règles de rapprochement sont propres à un secteur.
Avantages et inconvénients
Avantages
- Aucune installation ni configuration: tout se passe dans un onglet du navigateur et la démo fonctionne avant la création du compte.
- Des plafonds annoncés: taille de fichier, nombre de résultats et conservation sont publiés par offre, ce qui permet de savoir si le gratuit suffit.
- Une comparaison qui apprend: les corrections reviennent au modèle, ce qui fait mieux que des règles figées de distance entre chaînes sur des listes sales.
- Une option de modèle sur mesure: Premium vise les équipes qui ont besoin d'un réglage sur leurs propres données, pas d'un modèle générique.
Inconvénients
- Les plafonds de résultats pèsent sur les gros fichiers: même Premium s'arrête à 1 000 correspondances par recherche, donc un travail de 50 000 lignes doit être découpé.
- Pas d'API publique documentée: l'automatisation se limite aux imports manuels, ce qui exclut les pipelines planifiés sauf à construire quelque chose autour du parcours web.
- Conservation courte: les fichiers disparaissent au bout de 30 jours au maximum, l'outil ne peut donc pas servir de stockage léger pour un audit.
- La relecture humaine reste nécessaire: les correspondances proches contiennent de faux positifs et l'outil ne fusionne pas les enregistrements à votre place.
Questions fréquentes
Il cherche dans un fichier CSV ou Excel les lignes proches du texte saisi, y compris celles qui comportent des fautes de frappe et des variantes d'orthographe. Vous choisissez les colonnes, puis vous relisez les résultats classés.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Fuzzy Match.
Alternatives à Fuzzy Match

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.