

Gemini 3.8 & 3.8 Live Extended Thinking
Google DeepMind · Voix et langage · Chatbot
Gemini 3.8 Live et Gemini 3.8 Live Extended Thinking sont deux modèles d'IA vocale en temps réel de Google DeepMind, tous deux lancés le 15 septembre 2026. Le 3.8 Live standard est un modèle parole-à-parole réglé pour des interfaces vocales rapides et peu coûteuses, tandis que 3.8 Live Extended Thinking ajoute un raisonnement de fond en plusieurs étapes, ce qui lui permet de continuer à parler pendant qu'il travaille sur un problème difficile. On accède aux deux via la Gemini API, Google AI Studio et la Gemini Live API. Aucune installation supplémentaire. Les utilisateurs ordinaires les croisent déjà dans Gemini Live et Search Live, et Google indique que les deux modèles ont commencé à être déployés aussi dans l'application Gemini et dans Google Workspace.
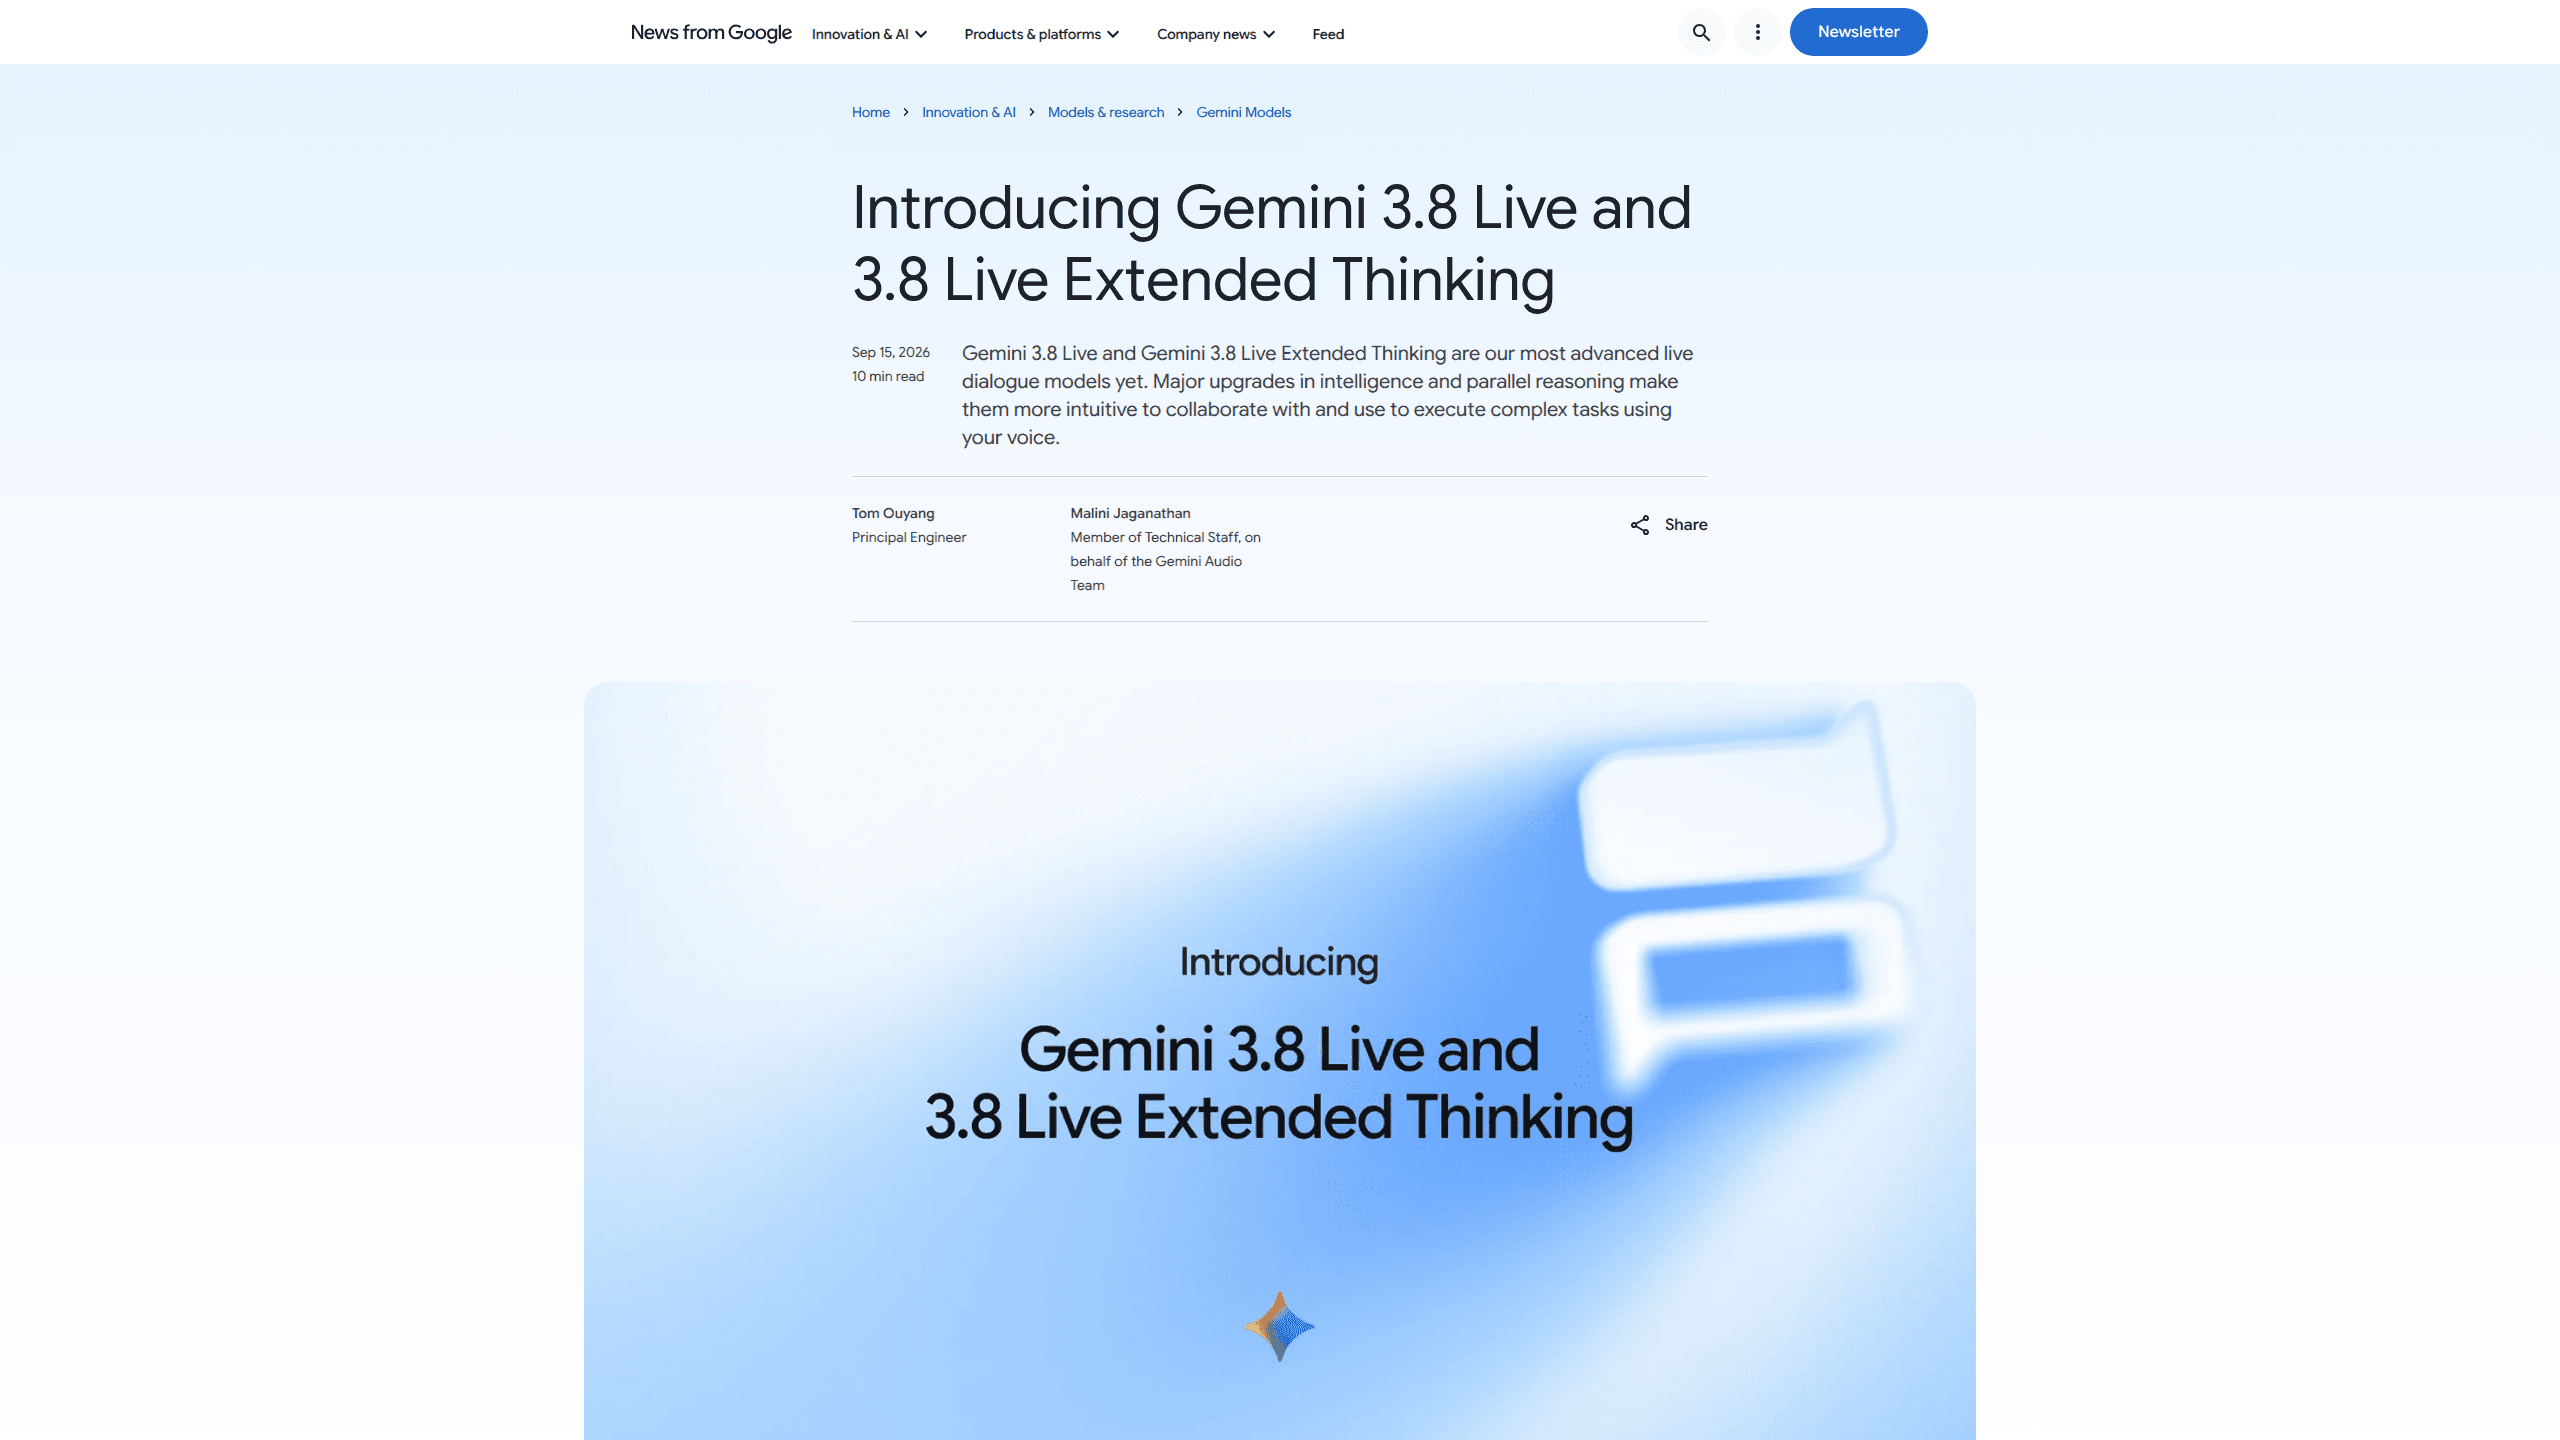
À propos de Gemini 3.8 & 3.8 Live Extended Thinking
Qu'est-ce que Gemini 3.8 et 3.8 Live Extended Thinking
Ce sont les modèles de conversation en temps réel les plus avancés de Google à ce jour, selon l'entreprise. Les deux sont nativement parole-à-parole : ils entendent de l'audio et répondent en audio au lieu de faire passer vos mots par un modèle de transcription séparé, puis un modèle de texte, puis un générateur de voix. Cette ancienne chaîne expliquait une bonne partie du retard et de la perte de ton.
La différence entre les deux tient à la façon dont ils traitent une question difficile, et ce seul choix de conception détermine sur lequel vous devez bâtir. Gemini 3.8 Live répond vite et appelle des outils en arrière-plan, ce qui convient au routage du support client, à la recherche vocale et à la pratique des langues. Gemini 3.8 Live Extended Thinking maintient un processus de « réflexion » pendant qu'il parle, ce qui lui permet de raconter sa progression sur des tâches en plusieurs étapes, comme planifier un voyage ou déboguer du code, sans rester muet.
Les limites principales sont pratiques. Extended Thinking ne prend en charge que les appels d'outils asynchrones non bloquants. Il faut aussi attendre un signal d'inactivité explicite avant de terminer une session. Et les niveaux de réflexion les plus élevés coûtent plus cher par minute d'audio. La tarification se fait à la minute d'audio, pas au token, donc les applications vocales toujours actives doivent calculer leur budget en amont.
Pour commencer
- Ouvrez Google AI Studio ou la console de la Gemini API et choisissez
gemini-3.8-liveougemini-3.8-live-extended-thinking. - Pour les applications vocales en direct, connectez-vous via la Gemini Live API sur un WebSocket à état plutôt qu'avec une requête unique.
- Envoyez l'audio d'entrée en PCM 16 bits à 16 kHz little-endian, et attendez l'audio de sortie en PCM 16 bits à 24 kHz.
- Si vous utilisez Extended Thinking, définissez un niveau de réflexion (low, medium ou high) et n'utilisez que des appels d'outils non bloquants.
- Ne terminez la session qu'après avoir vu un statut d'inactivité du modèle.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Gemini 3.8 & 3.8 Live Extended Thinking.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs qui créent des agents vocaux
- Équipes de support client
- Utilisateurs ordinaires de l'application Gemini
Tâches
- Dépannage en temps réel
- Pratique des langues en direct
- Réservation et planification
Cas d'usage
- Utiliser un assistant mains libres en conduisant ou en cuisinant, là où attendre en silence une réponse semble anormal.
- Guider quelqu'un à travers un croquis au tableau blanc, puisque le 3.8 Live lit l'entrée visuelle presque en temps réel.
- Coordonner plusieurs fonctions asynchrones dans une seule session parlée, comme vérifier le stock, puis le prix, puis le délai de livraison.
Fonctionnalités clés
Conversation parole-à-parole
Les deux modèles sautent l'ancienne chaîne transcrire puis générer. L'audio entre. L'audio ressort. Le gain : moins d'indices de ton perdus et moins de décalage entre ce que vous dites et ce qui revient. Pour une application vocale, cet écart, c'est toute l'expérience.
Penser à voix haute sans devenir muet
Extended Thinking mène son raisonnement en parallèle de la parole. Au lieu d'un silence total face à une question difficile, il ouvre sur une courte attente verbale comme « Laissez-moi vérifier », puis raconte sa progression pendant qu'il travaille. Les démos de Google incluent le guidage aux échecs en direct et la transformation de croquis au tableau blanc et de retours parlés en un composant React fonctionnel.
Appels d'outils et d'API en arrière-plan
Vous pouvez continuer à parler pendant que le modèle lance une recherche web ou appelle un outil. Dans Extended Thinking, seuls les outils asynchrones non bloquants sont pris en charge. Ce dernier détail compte. Un appel bloquant figerait le flux même que le modèle cherche à protéger.
Bascule entre 97 langues en un seul appel
Gemini 3.8 Live détecte et alterne entre 97 langues prises en charge sans que vous redémarriez la session. Les foyers multilingues et les centres d'appels qui reçoivent des appels en langues mélangées en profitent le plus, et personne n'a à choisir une langue au départ.
Entrée visuelle presque en temps réel
Le modèle standard comprend les images et les images de vidéo au fil de leur arrivée, environ une image par seconde. Cela lui permet de commenter ce qu'une caméra voit.
Filigrane audio SynthID
Chaque clip audio généré par ces modèles porte un filigrane SynthID invisible. Aucun bouton ne permet de le désactiver. Il ne change rien à ce que vous entendez, mais il donne aux plateformes un moyen de signaler une parole générée par IA.
Avantages et inconvénients
Avantages
- La conception parole-à-parole réduit le décalage qui rendait les anciens assistants vocaux robotiques.
- Extended Thinking garde une conversation vivante pendant qu'il travaille, donc les demandes complexes ne provoquent pas de silences totaux.
- La tarification à la minute d'audio, $0.005 en entrée et $0.018 en sortie, reste prévisible pour les applications à fort volume.
- La bascule native entre 97 langues convient aux produits multilingues sans installation supplémentaire.
- Le filigrane SynthID invisible est intégré d'origine pour qui publie de l'audio généré.
Inconvénients
- Extended Thinking n'autorise que les appels d'outils asynchrones non bloquants, donc les outils synchrones imposent une autre architecture.
- Il faut attendre un statut d'inactivité explicite pour terminer une session, ce qui ajoute un état que votre code doit suivre.
- La facturation à la minute d'audio grimpe vite pour les assistants toujours actifs, car il n'y a aucun plafond fixe.
- Les niveaux de réflexion les plus puissants augmentent le coût par minute, donc le raisonnement le plus profond n'est pas gratuit.
Questions fréquentes
Gemini 3.8 Live est réglé pour une conversation en temps réel rapide et peu coûteuse, tandis que 3.8 Live Extended Thinking ajoute un raisonnement de fond en plusieurs étapes et peut parler et réfléchir en même temps. Les deux partagent la même base parole-à-parole, alors choisissez selon la latence ou la profondeur.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Gemini 3.8 & 3.8 Live Extended Thinking.
Alternatives à Gemini 3.8 & 3.8 Live Extended Thinking
Prosp
Prosp · Rédaction · Voix et langage · MarketingProsp est un outil de prospection LinkedIn par IA, conçu pour les agences et les équipes commerciales. Il rédige le message et la note vocale avec votre propre voix pour chaque prospect, pour qu'ils répondent vraiment. Vous connectez vos comptes, trouvez des leads et laissez l'IA rédiger et envoyer des messages personnalisés à grande échelle, le tout depuis une seule boîte de réception. Il est fait pour qui prospecte en volume. C'est tout l'argument. Chaque contact doit quand même paraître humain.

Wordly AI Translation
Wordly · Voix et langage · ProductivitéWordly AI Translation est une plateforme de traduction et de sous-titrage par IA en temps réel conçue pour les réunions, les conférences et les événements. Elle fournit une traduction en direct, des sous-titres, des transcriptions et des résumés dans plus de 60 langues, et les participants rejoignent la session en scannant un QR code ou en ouvrant un lien, sans casque dédié. La plateforme fonctionne avec Zoom, Microsoft Teams, Google Meet et Webex, et elle vise les organisations qui veulent un accès multilingue sans embaucher d'interprètes humains pour chaque session. C'est aussi simple que ça.
Musicful
Musicful AI · Voix et langage · VidéoMusicful est un générateur de musique par IA et un créateur de clips musicaux par IA qui transforme un texte en musique en quelques minutes. Vous lui donnez un texte, des paroles ou une mélodie fredonnée, et il renvoie une piste finie avec voix et instruments. Il fait aussi office de générateur de chansons par IA, produit des clips musicaux à partir des chansons que vous créez et propose un outil de cover par IA ainsi qu'une API pour développeurs. La plateforme tourne dans un navigateur web et via une appli Android, donc vous pouvez commencer une chanson sur ordinateur et la reprendre sur votre téléphone.