
Griffin by Tavus
Tavus · Voix et langage · Vidéo · Chatbot
Griffin by Tavus est le premier modèle d'interaction humaine : un système vidéo vers vidéo, full-duplex, qui observe, écoute et répond pendant un appel vidéo en temps réel.
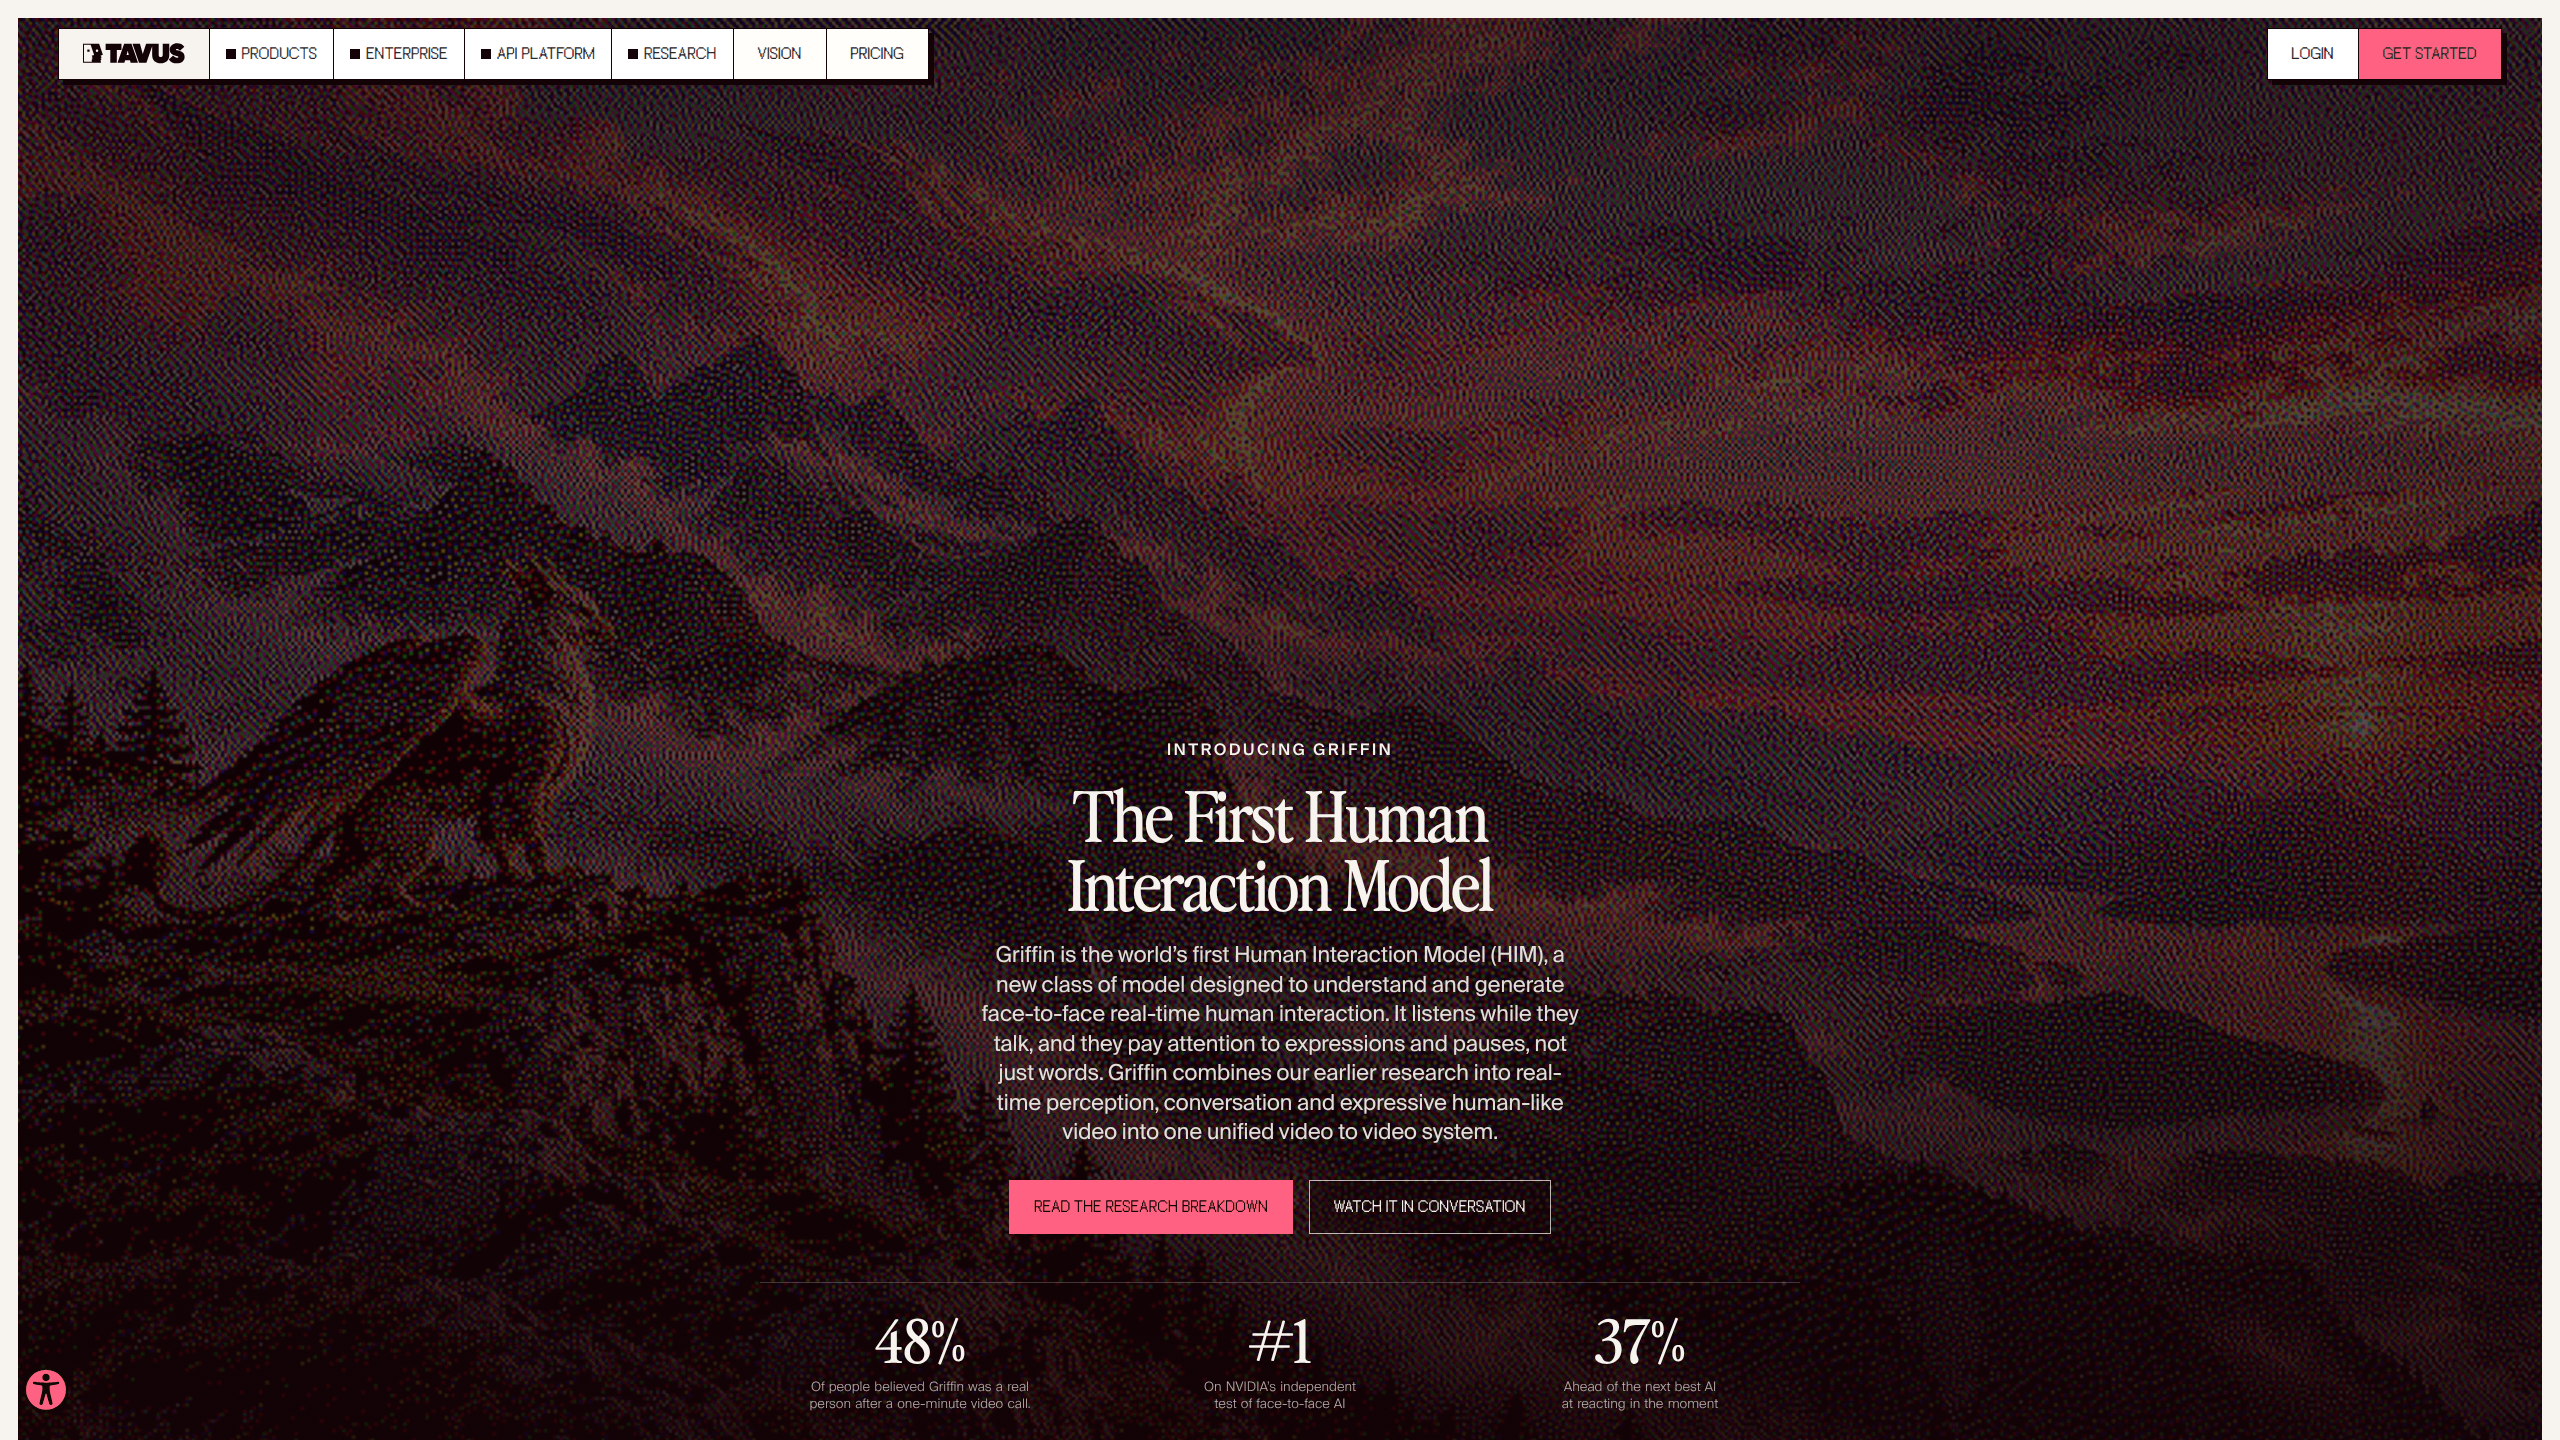
À propos de Griffin by Tavus
What Is Griffin by Tavus
Griffin est un modèle de recherche de Tavus qui tient une conversation en face à face lors d'un appel vidéo. Il lit à la fois la caméra et le micro, décide quand prendre la parole et génère le visage et la voix de son interlocuteur au fil de l'échange. Tavus l'a publié le 1er octobre 2026 et le présente comme le premier modèle d'interaction humaine, ou HIM.
Son architecture rompt avec celle de l'IA conversationnelle classique. La plupart des systèmes enchaînent reconnaissance vocale, modèle de langage, synthèse vocale et moteur de rendu d'avatar, et attendent que vous ayez fini de parler pour réagir. Griffin prend une décision à chaque fraction de seconde. Il peut donc hocher la tête pendant que vous parlez, traiter une pause comme un temps de réflexion et reprendre le fil quand vous l'interrompez.
Le revers, c'est l'accès. Griffin-Lite, la version disponible aujourd'hui, reste un aperçu de recherche réservé à un petit groupe de testeurs de confiance. Tavus indique qu'il n'est pas encore intégré à sa plateforme, qu'aucun tarif n'est publié et qu'il n'existe pas d'API publique. Le chiffre de 48% vient d'une étude menée par l'entreprise elle-même, avec 54 personnes et des appels d'une minute.
Getting Started
- Rendez-vous sur tavus.io/griffin et remplissez le formulaire de demande. L'accès se fait sur invitation, aucun bouton d'inscription ne garantit une place.
- Si votre demande est acceptée, rejoignez l'appel vidéo IA depuis le lien reçu. Rien ne s'installe sur votre machine.
- Autorisez la caméra et le micro, puis parlez comme avec un collègue. L'avatar IA produit sa réponse pendant que vous parlez.
- Testez un comportement à la fois. Coupez la parole au milieu d'une phrase, arrêtez-vous pour réfléchir ou montrez un objet à la caméra pour voir ce qu'il en fait.
- Traitez la séance comme une évaluation. Il n'y a ni tableau de bord, ni export, ni page de facturation : Griffin-Lite n'est pas un produit destiné aux clients.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Griffin by Tavus.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Les équipes produit qui construisent des agents vidéo en temps réel
- Les équipes formation
- Les chercheurs en IA conversationnelle
Tâches
- Répéter un appel commercial
- Préparer un entretien
- Pratiquer une langue
- Préparer une escalade support
Cas d'usage
- Décider si un agent vidéo convient à un processus
- Tester les interruptions avant de développer
- Évaluer une conversation réglementée
Fonctionnalités clés
Conversation full-duplex
Griffin écoute pendant qu'il parle. Il peut garder la parole, la céder ou s'arrêter quand vous l'interrompez, et il continue de suivre l'échange pendant sa propre réponse. Tavus l'a conçu comme une boucle continue et non comme un échange de tours, ce qui explique qu'une pause dans votre phrase ne met pas fin à votre tour.
Génération de la scène entière
Le modèle génère chaque pixel de l'image à partir d'une seule photo de référence. Cela couvre le visage, les mains, la chaise sur laquelle la personne est assise, les ombres et l'arrière-plan. La plupart des avatars animent une tête détourée, si bien qu'une main qui bouge casse l'illusion. Griffin n'a pas cette couture.
Sortie 720p en temps réel
La vidéo sort en 720p pendant l'appel, un latent à la fois. Tavus a mesuré 0,43 seconde en moyenne pour produire le plus petit fragment sur une H100, avec un meilleur cas à 0,27 seconde. En conversation, ce qui compte est l'écart entre votre interruption et la réaction du visage, et une demi-seconde suffit à être perçue comme de l'attention.
Perception visuelle
Griffin reçoit de la vidéo, pas seulement de l'audio. Il capte le regard, l'expression du visage, les gestes et les objets que vous montrez à la caméra, et il peut lire un écran partagé. C'est ainsi qu'il réagit quand vous levez une pièce cassée ou détournez les yeux pour réfléchir, au lieu de répondre à la transcription de vos mots.
Comportement et émotion
Le modèle module le ton, l'expression et le geste selon le contexte de l'échange. Il rit au bon moment, devient sérieux quand le sujet le demande et s'appuie sur des signaux non verbaux pour accuser réception de vos propos. Tavus a entraîné ces comportements dans le même système que celui qui décide quoi dire, et non comme une couche ajoutée après coup.
Clonage vocal à partir d'un court extrait
Le générateur de parole de Griffin clone une voix à partir d'une dizaine de secondes d'audio de référence. Il repose sur Tavec, le codec audio de Tavus, qui diffuse des paquets allant jusqu'à 10 millisecondes. Pour qui construit un avatar IA de marque, cet échantillon très court supprime une séance d'enregistrement de la préparation.
Avantages et inconvénients
Avantages
- 48% des participants à l'étude en direct de Tavus ont cru parler à une personne, contre 2,4% avec la pile précédente de l'entreprise, Phoenix-4.5.
- Griffin-Lite obtient 3,83 sur la piste de génération de VideoFDB, le benchmark de NVIDIA, avec la référence humaine à 3,92 et le système d'IA suivant à 2,80.
- Il gère les interruptions et les acquiescements sans perdre le fil, là où les piles chaînées voix et avatar craquent le plus souvent.
- La génération de scène entière fait bouger les mains, la posture et l'arrière-plan avec la conversation au lieu de les figer.
- Le clonage vocal demande une dizaine de secondes d'audio, ce qui rend un avatar IA sur mesure rapide à préparer.
Inconvénients
- Impossible de l'acheter. Griffin-Lite est réservé aux testeurs approuvés et Tavus n'a fixé aucune date de sortie générale : aucune équipe ne peut planifier un lancement dessus.
- Aucune API publique, aucun identifiant de modèle et aucun prix. Un développeur ne peut ni le tester dans sa propre pile ni le budgéter.
- Les 48% reposent sur 54 personnes et des appels d'une minute, menés par l'entreprise qui a créé le modèle. Les appels longs et une réplication indépendante restent non testés.
- La piste de perception montre un écart réel : 3,73 contre 4,20 pour les humains, avec 2,2 secondes de réponse contre 1,4. Un contexte visuel complexe le met encore en difficulté.
Questions fréquentes
Griffin est un modèle vidéo vers vidéo, full-duplex, qui tient une conversation en face à face en temps réel. Tavus le qualifie de modèle d'interaction humaine parce qu'il traite la perception, la prise de parole et la génération audiovisuelle dans un seul système, sans enchaîner des modèles séparés de parole, de langage et d'avatar.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Griffin by Tavus.
Alternatives à Griffin by Tavus

Foley
Hanamori Labs, LLC · Voix et langage · Productivité · Assistant d’IAFoley est une liste de tâches vocale qui transforme une phrase prononcée en tâche classée, projet, date et heure compris, puis vous aide à organiser la journée à partir de ce qui est déjà noté.

HireKey
HireKey · Voix et langage · Productivité · ApprentissageHireKey est un copilote de recherche d'emploi IA conçu par une ancienne recruteuse tech. Il évalue l'adéquation au poste, adapte le CV, entraîne aux entretiens et suit chaque candidature.

Fluence
Yay Software (Yannick Huchard) · Rédaction · Voix et langage · ProductivitéFluence est une application Android qui lit à voix haute vos PDF, EPUB, fichiers Word et articles web, suit la phrase prononcée et répond aux questions sur le texte sans quitter le téléphone.