
Helicone
Helicone, Inc. · Programmation
Helicone est une plateforme d'observabilité des LLM open source et une passerelle IA. Changez une URL de base pour journaliser chaque prompt, suivre les dépenses et router plus de 100 modèles.
À propos de Helicone
About
Qu'est-ce que Helicone
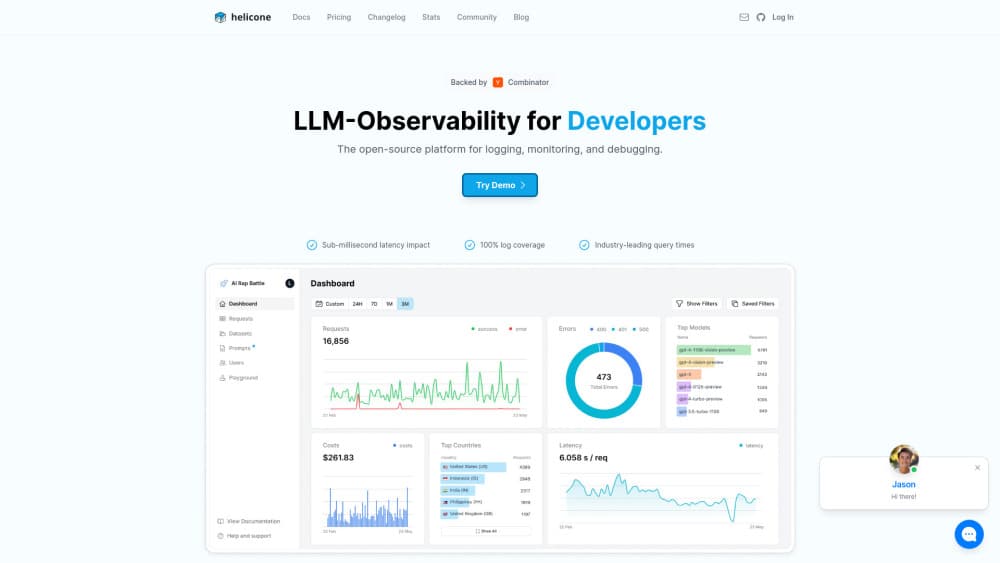
Helicone se place entre votre application et le fournisseur du modèle. Vous dirigez le SDK OpenAI vers l'adresse de la passerelle, ou vous ajoutez l'URL du proxy aux appels que vous faites déjà, et chaque requête apparaît dans un tableau de bord avec le prompt, la réponse, les tokens, le coût et la latence.
Cela répond aux questions qui arrivent une semaine après la mise en ligne. Pourquoi la conversation d'un client coûte 40 centimes. Quel prompt a cassé la sortie JSON. Si la lenteur vient de votre serveur ou du fournisseur. Les journaux de requêtes restent interrogeables, et vous les regroupez par utilisateur, par session ou par propriété personnalisée.
Le projet est open source sous licence Apache 2.0, avec une option auto-hébergée pour les équipes qui refusent d'envoyer leurs prompts à un tiers. Deux limites décident de son intérêt. Il faut accès au code qui appelle le modèle, puisque l'installation tient à une URL de base et à un en-tête. Le volet évaluation reste plus léger que celui des plateformes dédiées, donc une équipe qui mène beaucoup d'expériences garde un second outil.
Premiers pas
- Créez le compte gratuit et générez une clé d'API dans les réglages.
- Dirigez votre client OpenAI vers la passerelle Helicone, ou faites passer les appels existants par l'URL du proxy avec un en-tête Helicone-Auth.
- Envoyez une requête et ouvrez l'onglet des requêtes ; le journal apparaît en quelques secondes.
- Étiquetez les appels avec des propriétés personnalisées comme l'ID utilisateur ou l'offre, pour ventiler les dépenses ensuite.
- Posez une alerte sur le coût ou le taux d'erreur, puis invitez le reste de l'équipe.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Helicone.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Équipes d'ingénierie avec des fonctions LLM en production
- Développeurs indépendants et jeunes startups
- Équipes plateforme et DevOps
- Équipes soumises à des règles sur les données
Tâches
- Déboguer une mauvaise réponse
- Surveiller les dépenses
- Changer de fournisseur
- Comparer des prompts
- Auditer l'usage
Cas d'usage
- Un chatbot devenu coûteux après le lancement
- Un prototype qui doit essayer trois modèles cette semaine
- Un environnement réglementé
Fonctionnalités clés
Intégration en une ligne
L'installation se résume à une URL de base et à une clé d'API, donc un client OpenAI, Anthropic, Azure ou LiteLLM existant garde la forme de son code. Rien à installer sur le serveur, aucun agent à lancer, et c'est pourquoi les équipes voient des journaux l'après-midi même de leur inscription. La voie du proxy convient à tout langage capable d'envoyer une requête HTTP.
Journaux de requêtes et traces
Chaque entrée conserve le prompt complet, la réponse du modèle, les tokens, la latence et le coût calculé. Vous filtrez par modèle, statut, plage horaire ou propriété personnalisée, puis vous ouvrez une requête pour voir où le temps est parti. La journalisation des prompts à ce niveau transforme une plainte vague en une ligne de texte précise, que vous pouvez corriger.
Passerelle IA avec cache et repli
La passerelle IA est un point d'accès compatible OpenAI qui couvre plus de 100 modèles chez OpenAI, Anthropic, Google, Vertex, Groq et d'autres. Elle ajoute un cache de réponses, des limites de débit par clé et des replis automatiques quand un fournisseur tombe, et les crédits sont facturés au prix du fournisseur, sans marge. Vous pouvez aussi apporter vos propres clés si vous préférez séparer la facturation.
Analyse des utilisateurs et des sessions
Les propriétés personnalisées permettent d'attacher à une requête un ID utilisateur, une offre, le nom d'une fonction ou toute autre étiquette. Les sessions regroupent ensuite une conversation de plusieurs tours dans une seule vue, et vous voyez le coût et la longueur d'un parcours réel. Pour une équipe support, c'est la différence entre « le bot est lent » et « ce compte déclenche un appel d'outil de 12 secondes à chaque fois ».
Playground et gestion des prompts
Le playground lance des prompts sur plusieurs modèles côte à côte et affiche les réglages de raisonnement pour les modèles qui les exposent. Les prompts se sauvegardent, se versionnent et se réutilisent depuis le code, et les sorties se notent, ce qui juge une modification sur ses résultats plutôt que sur une impression. C'est le moyen rapide de tester un modèle moins cher avant de lui envoyer du trafic réel.
Alertes, rapports et HQL
Les alertes se déclenchent sur des seuils de coût, de taux d'erreur ou de latence, et les rapports programmés envoient un résumé par e-mail ou Slack. HQL, le langage de requête intégré, traite ce que les filtres du tableau de bord ne savent pas exprimer, comme le coût par utilisateur sur 30 jours. Les résultats s'exportent ou passent par l'API vers votre entrepôt.
Open source et auto-hébergement
Le code est public sous Apache 2.0, avec des milliers d'étoiles sur GitHub et un rythme de versions soutenu. Vous faites tourner toute la pile dans votre cloud avec Docker, ce qui compte quand les prompts contiennent des données clients que le juridique interdit d'exporter. La version hébergée et la version auto-hébergée partagent le même tableau de bord et la même API.
Avantages et inconvénients
Avantages
- Un changement d'URL de base suffit à lancer la journalisation, sans réécrire le SDK ni monter un projet de migration.
- La passerelle couvre plus de 100 modèles au prix du fournisseur, sans marge, avec cache et replis sur la même clé.
- Le code est open source sous Apache 2.0, avec une voie auto-hébergée pour les équipes tenues par des règles sur les données.
- L'offre gratuite sert vraiment : 10 000 requêtes par mois, 1 Go de stockage, aucune carte demandée.
- Coût, latence et erreurs tiennent sur un écran par requête, par utilisateur et par session, et vous abandonnez le tableur.
Inconvénients
- L'outil vise les développeurs. Sans accès au code qui appelle le modèle, le tableau de bord n'a rien à afficher.
- Les fonctions d'évaluation et de jeux de données sont plus minces que sur les plateformes dédiées, donc un suivi sérieux des expériences réclame un second outil.
- L'offre Pro démarre à 79 $/mois et la facturation à l'usage sur les requêtes et le stockage rend le montant difficile à prévoir quand le trafic monte.
- L'offre gratuite garde les journaux 7 jours et 1 Go, donc tout historique long exige une offre payante.
Questions fréquentes
Il journalise et analyse les appels que votre application envoie aux fournisseurs de LLM. Vous obtenez des journaux de requêtes avec prompts, réponses, tokens, coût et latence, plus une passerelle qui route ces appels vers plus de 100 modèles.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Helicone.
Alternatives à Helicone

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.