
Inferless
Inferless · Programmation
Inferless est une plateforme GPU serverless qui déploie des modèles de machine learning sous forme d'endpoints API, avec des démarrages à froid sous la seconde et une facturation à la seconde.
À propos de Inferless
About
Qu'est-ce qu'Inferless
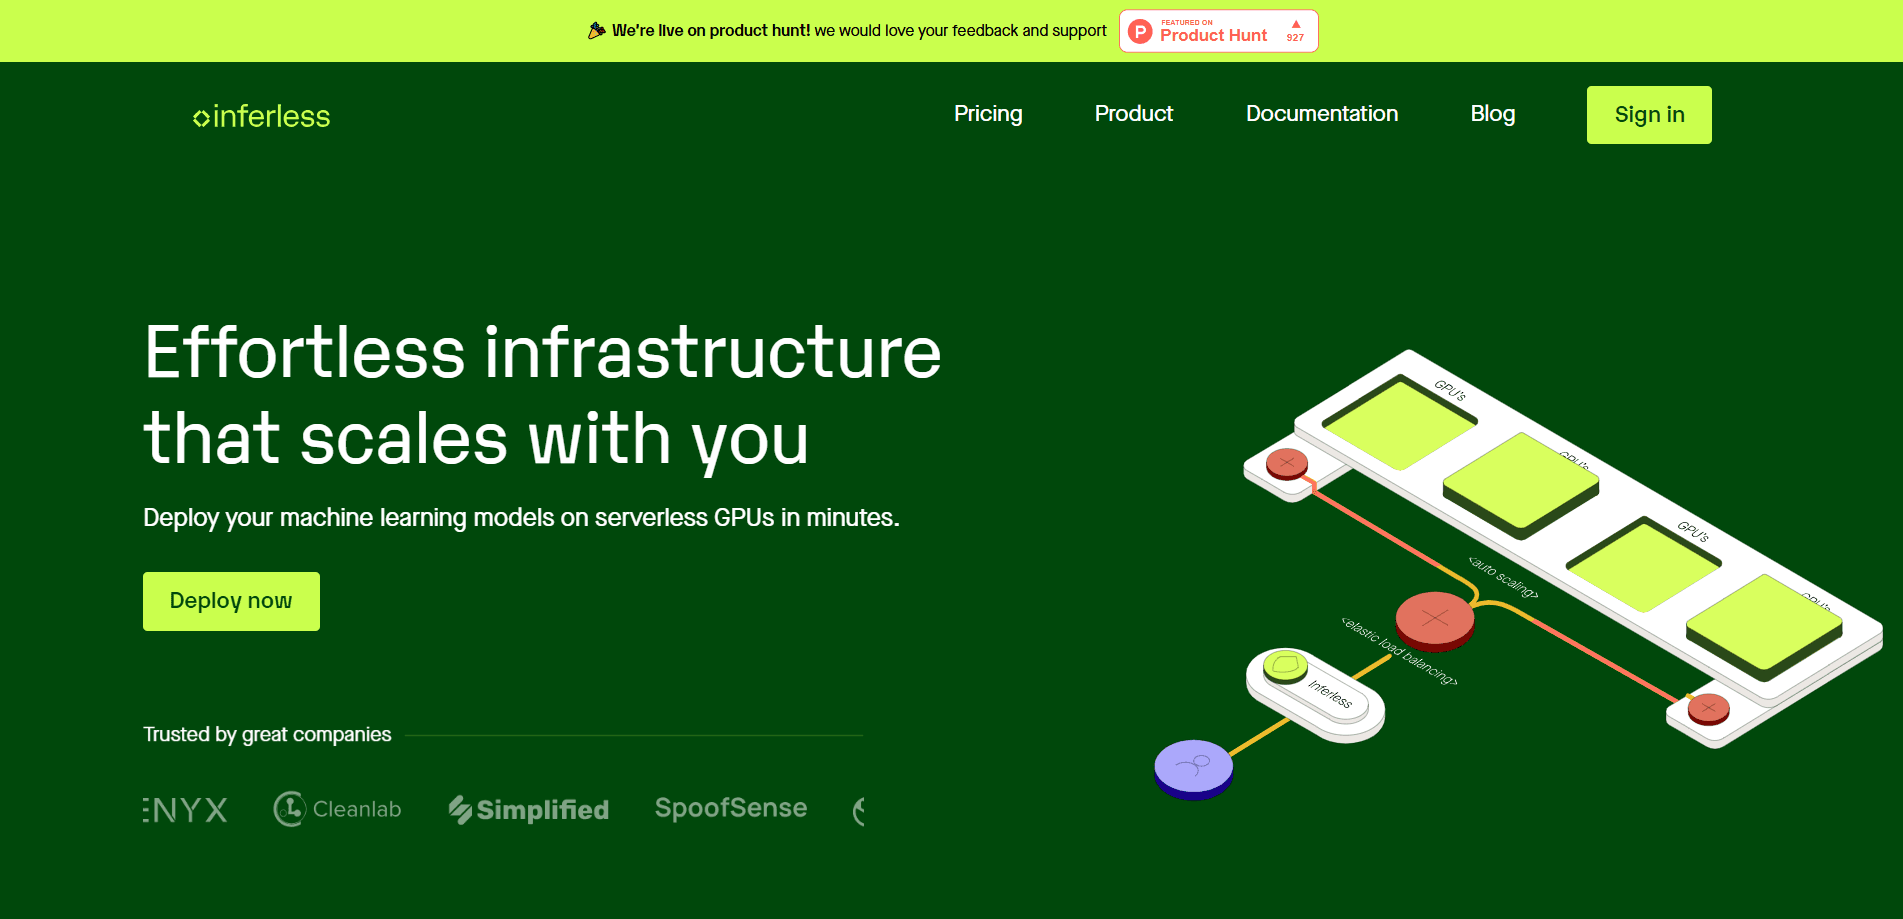
Inferless est une plateforme d'inférence GPU serverless qui transforme un modèle de machine learning déjà entraîné en endpoint API actif, sans que vous ayez à gérer le moindre GPU. Vous apportez le modèle, la plateforme s'occupe du provisionnement, de la mise à l'échelle et de toute l'infrastructure en dessous. Elle vise l'inférence ML, pas l'entraînement. La promesse est simple : vous évitez la configuration du cluster et obtenez un endpoint que votre application peut appeler.
Le problème visé, c'est le coût et l'effort. Faire tourner un modèle suppose souvent de louer un GPU 24 heures sur 24, même quand personne n'envoie de requête. Inferless facture à la seconde et descend à zéro quand le trafic s'arrête, donc vous payez seulement le calcul réellement utilisé. La plateforme s'appuie sur un moteur d'orchestration maison et une couche de stockage pour garder les démarrages à froid bas, ce qui compte quand un modèle doit se réveiller avant de répondre.
Les limites sont concrètes. C'est un outil pour développeurs, pas une application sans code, donc vous devez bien empaqueter le modèle et ses dépendances. Le tarif est à l'usage, économique à faible volume mais plus difficile à prévoir qu'un forfait fixe. Et certains usages, comme les longs entraînements, se prêtent mieux à une machine GPU dédiée qu'à un endpoint serverless conçu pour l'inférence.
Premiers pas
- Créez un compte Inferless et connectez une source de modèle comme Hugging Face, GitHub ou une image Docker
- Configurez l'environnement, les paquets et le type de GPU via un simple fichier YAML, sans écrire de code serveur
- Déployez le modèle et laissez Inferless construire l'environnement et lancer l'endpoint
- Appelez l'endpoint généré depuis votre application et laissez l'autoscaling absorber les pics de trafic
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Inferless.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Ingénieurs machine learning
- Startups
- Data scientists
- Développeurs d'applications
- Équipes en entreprise
Tâches
- Déployer un modèle maison
- Servir des modèles de langage
- Traitements d'inférence par lots
- Prototyper une idée
- Ajouter de l'inférence à une application
- Partager des données entre modèles
Cas d'usage
- Une startup qui lance une fonction IA
- Un data scientist qui valide un modèle
- Une équipe au trafic irrégulier
- Un développeur qui monte une démo
- Une entreprise avec ses propres modèles
Fonctionnalités clés
Démarrages à froid sous la seconde
Le plus dur en inférence serverless, c'est l'attente quand un modèle endormi se réveille pour répondre, le fameux cold start. Inferless s'y attaque avec un moteur d'orchestration maison, un routeur avancé et sa propre couche de stockage qui travaillent ensemble. L'entreprise annonce des réponses sous la seconde même pour de gros modèles, ce qui rend le passage à zéro viable pour les applications grand public. Si une fonction de chat ou de recherche doit attendre dix secondes le chargement d'un modèle, le serverless perd son intérêt.
Mise à l'échelle automatique depuis zéro
Inferless monte et descend votre endpoint selon le trafic, d'aucun GPU actif à des centaines à la fois. Le répartiteur de charge interne distribue les requêtes et ajoute ou retire de la capacité avec peu de surcoût, ce qui convient aux charges qui explosent sans prévenir. Vous ne planifiez pas la capacité de pointe à l'avance et vous ne la payez pas quand le trafic est calme.
Import de modèles depuis plusieurs sources
Vous pouvez récupérer des modèles depuis Hugging Face, GitHub, AWS S3, Google Cloud Storage, Docker ou la CLI Inferless, et la plateforme fait le reste. L'import en un clic depuis les dépôts que les équipes ML utilisent déjà réduit la préparation, donc mettre un modèle en production ne commence pas par un transfert de fichiers. Le support d'Azure est annoncé comme à venir.
Indépendant du modèle et du framework
La plateforme exécute des modèles PyTorch, TensorFlow et ONNX, et accepte aussi des fonctions Python personnalisées. Cette souplesse signifie que vous n'êtes enfermé ni dans un framework ni dans un format de modèle. Vous configurez environnements et paquets sur mesure via YAML, donc installer des bibliothèques supplémentaires n'oblige pas à écrire un serveur de zéro.
Prise en charge du GPU fractionné
Au lieu de louer un GPU entier pour un petit modèle, Inferless laisse plusieurs modèles et traitements partager le même GPU, avec rééquilibrage automatique et vidage des nœuds. Vous pouvez aussi utiliser des GPU fractionnés, donc un modèle qui a besoin d'une part d'A100 ne vous force pas à payer la carte entière. Pour les équipes qui font tourner beaucoup de petits modèles, ce partage fait souvent la différence entre viable et trop cher.
Monitoring et CI/CD
Inferless fournit des métriques Prometheus et des tableaux de bord Grafana pour suivre l'usage GPU et d'autres signaux de santé du système. Les nouvelles versions du modèle se déploient via des pipelines CI/CD, donc vous publiez une mise à jour sans reconstruire ni redéployer l'infrastructure à la main. Du même flux sortent des endpoints prêts à l'emploi, que vous pouvez brancher sur un backend ou un front end.
Avantages et inconvénients
Avantages
- La facturation à la seconde évite de payer des GPU inactifs quand le trafic tombe à zéro
- Les démarrages à froid sous la seconde rendent le passage à zéro viable pour les applications en direct
- L'import en un clic depuis Hugging Face, GitHub, S3 et Google Cloud Storage réduit le montage
- Indépendant du framework : PyTorch, TensorFlow, ONNX et Python maison fonctionnent
- Le partage de GPU fractionné baisse le coût de nombreux petits modèles
Inconvénients
- C'est un outil pour développeurs, il faut donc encore empaqueter le modèle et ses dépendances
- Le tarif à l'usage est économique à faible volume mais plus dur à prévoir qu'un forfait fixe
- Les longs entraînements ne sont pas la cible, la plateforme étant faite pour l'inférence
- Pas d'application mobile native, tout passe par la console web et la CLI
Questions fréquentes
Inferless est une plateforme GPU serverless pour le déploiement de modèles, et elle transforme des modèles de machine learning maison en endpoints API. Vous importez un modèle, configurez l'environnement et Inferless gère le matériel, la mise à l'échelle et les démarrages à froid.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Inferless.
Alternatives à Inferless
Forefront
Forefront · ProgrammationForefront est une plateforme web pour construire avec de l'IA open source. Elle vous laisse affiner les principaux modèles de langage open source sur vos propres données, évaluer leurs performances et les exécuter via une API ou les exporter pour les héberger vous-même. Les développeurs qui veulent le confort d'une plateforme fermée mais tiennent à rester propriétaires de leurs modèles et de leurs données sont le public visé ici.

Startkit
StartKit.AI · ProgrammationStartkit est un boilerplate pour créer des produits SaaS d'IA et des wrappers d'IA. Voyez-le comme un boilerplate de startup IA avec les parties ennuyeuses déjà branchées : authentification, paiements Stripe et Lemon Squeezy, limites d'usage, e-mail transactionnel et un kit de démarrage d'API IA qui parle à OpenAI, Anthropic, Groq ou Llama. Vous clonez le dépôt, fixez votre prix et attaquez la partie du produit pour laquelle les gens paient vraiment. Il repose sur Next.js au-dessus de React et Tailwind, donc une bonne partie du code boilerplate vous semble déjà familière.
Testim
Tricentis · ProgrammationTestim est une plateforme d'automatisation des tests dopée à l'IA, qui sert à créer et exécuter des tests de bout en bout sur des applications web, mobiles et Salesforce. Elle s'appuie sur l'apprentissage automatique pour garder les tests stables quand une interface change, alors les équipes passent moins de temps à réparer des sélecteurs cassés. Pas mal pour un outil de tests automatisés que vous pouvez utiliser dès aujourd'hui. Vous créez des tests en enregistrant des actions dans un navigateur, puis vous ajoutez du JavaScript quand vous avez besoin de plus de contrôle. C'est un choix solide pour une équipe QA bien occupée.