
Kyutai TTS
Kyutai · Voix et langage
Kyutai TTS est un modèle de synthèse vocale en streaming et open source qui commence à produire l'audio avant d'avoir tout le texte, ce qui garde la latence basse pour les assistants vocaux et les applis temps réel.
À propos de Kyutai TTS
About
Qu'est-ce que Kyutai TTS
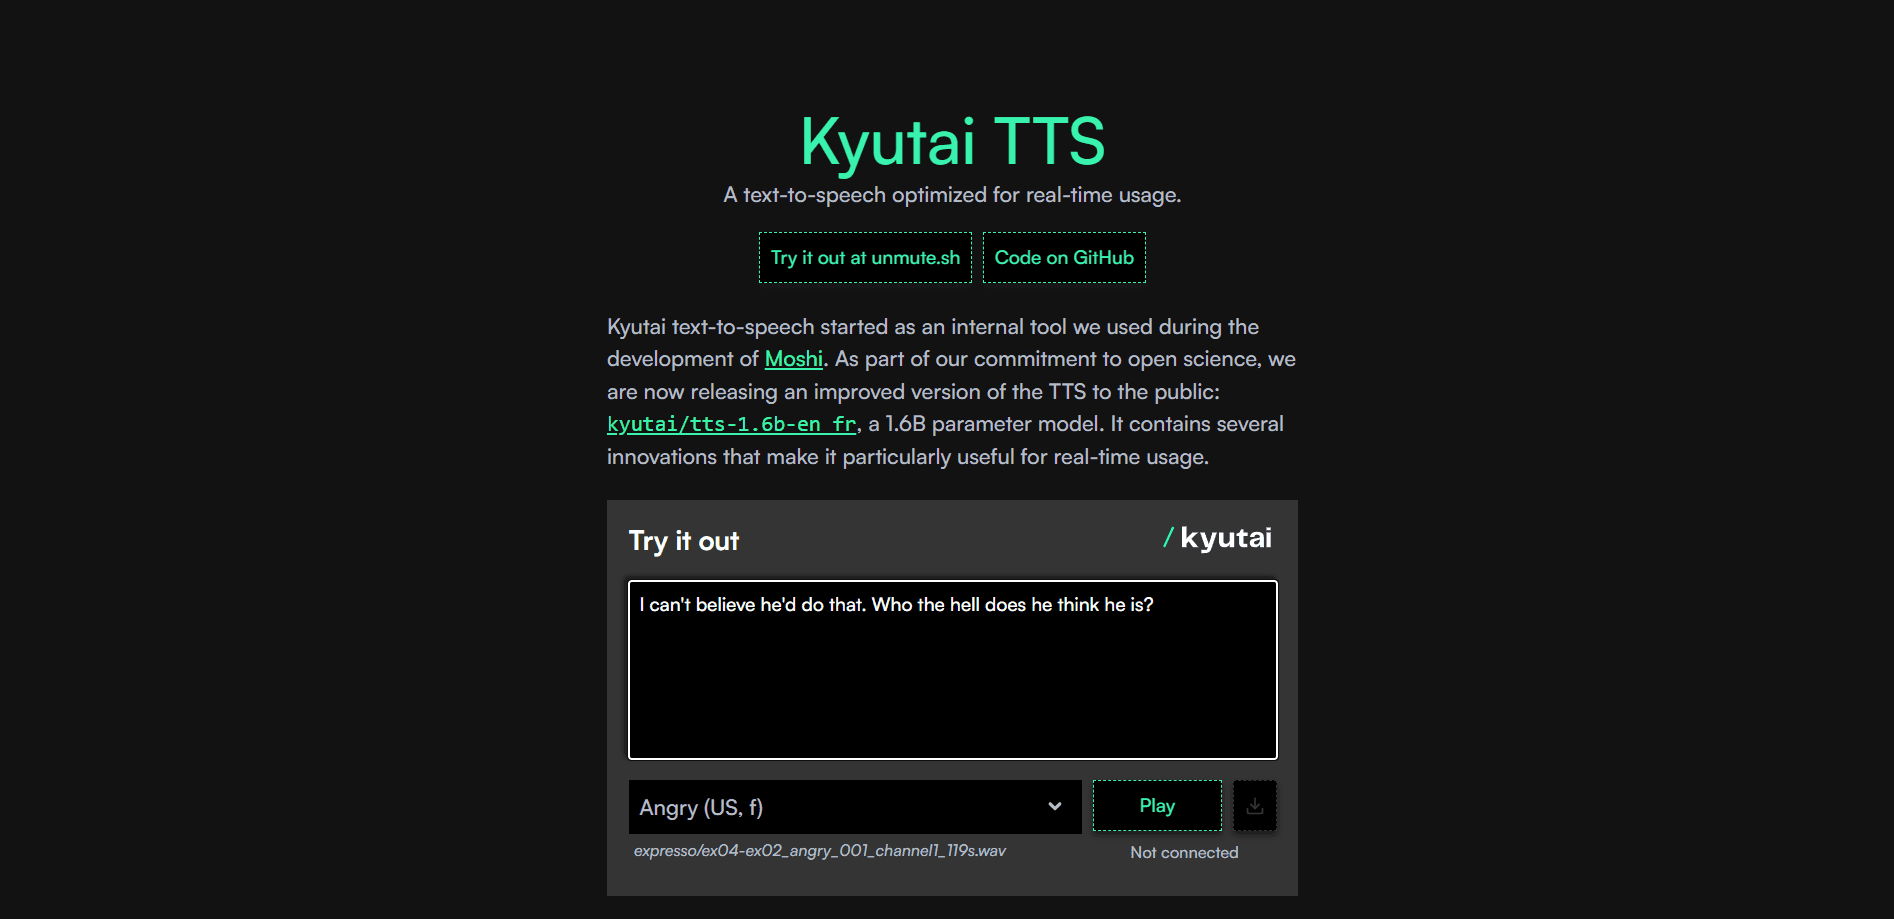
Kyutai TTS est un modèle de synthèse vocale conçu pour le streaming. Il lit un texte à voix haute, mais n'attend pas que vous ayez fini de taper. Il se met à parler dès qu'il a les premiers mots, et c'est ce qui le distingue des moteurs hors ligne qui exigent la phrase entière avant d'émettre le moindre son.
Kyutai est un laboratoire français de science ouverte financé par le groupe Iliad, le groupe CMA CM et Schmidt Sciences. Le laboratoire a créé Kyutai TTS 1.6B, l'un des plusieurs modèles audio de Kyutai, pour ses propres travaux sur Moshi, un système de dialogue vocal, avant de publier les poids en accès libre. Cette version vise la synthèse vocale à faible latence, un exercice que la plupart des moteurs ne font qu'après avoir lu tout le texte. Vous pouvez monter un assistant qui parle, générer de la narration ou ajouter de la voix à une appli sans payer au caractère.
Le point sensible, c'est la façon dont il atteint cette vitesse. Il a été entraîné sur 2,5 millions d'heures d'audio public et tourne mieux sur un GPU, donc ce n'est pas un service cloud prêt à l'emploi avec un tarif mensuel clair. Vous téléchargez les poids, préparez un environnement et le lancez vous-même. Deux versions existent : le modèle en streaming de 1.6B présenté ici et le plus récent Pocket TTS, un modèle plus léger fait pour les machines à CPU.
Pour commencer
- Créez un compte gratuit sur Hugging Face et acceptez la licence du modèle sur la page de Kyutai TTS.
- Installez le paquet moshi de Python avec pip, ou le crate moshi-server si vous comptez le servir en production.
- Chargez le checkpoint et le codec audio Mimi en Python, puis pointez le modèle vers un texte d'entrée.
- Générez l'audio par blocs pour une lecture en streaming, ou lancez-le sur un fichier pour une sortie hors ligne.
- Choisissez une voix prête dans le dépôt tts-voices, ou fournissez votre propre embedding de voix.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Kyutai TTS.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs qui construisent des assistants vocaux
- Chercheurs et étudiants
- Créateurs à petit budget
Tâches
- Réponses parlées en temps réel
- Clonage de voix pour une identité fixe
- Génération de narration par lots
Cas d'usage
- Alimenter un agent vocal conversationnel
- Ajouter de l'accessibilité à une appli
- Prototyper un produit multilingue
Fonctionnalités clés
Une sortie en streaming qui dépasse le TTS hors ligne
Kyutai TTS se met à parler dès qu'il reçoit les premiers mots d'un texte. Les moteurs hors ligne attendent le texte complet, ce qui ajoute des secondes de retard. Dans un assistant vocal, cet écart sépare une conversation fluide d'une pause gênante.
Reposant sur le delayed streams modeling
Le modèle vient des recherches de Kyutai sur le delayed streams modeling, une méthode pour les tâches en streaming qui naviguent entre texte et voix. Il reprend l'architecture multistream de Moshi, donc les flux de texte et d'audio s'alignent et la génération reste stable et rapide.
Clonage de voix par embeddings
Vous donnez au modèle une voix précise en lui passant un embedding déjà calculé du dépôt tts-voices. Kyutai a choisi cette voie plutôt que le clonage libre pour une raison. Le tatouage numérique s'enlève facilement sur les modèles ouverts, donc limiter le clonage à des embeddings stockés est la voie la plus sûre.
Traitement par lots pour un gros débit
Le modèle regroupe les requêtes au lieu de traiter une voix à la fois. Kyutai annonce environ 75x d'audio généré par unité de calcul, et l'entraînement a utilisé la distillation CFG pour éviter de doubler le lot au moment du guidage.
Voix en anglais et en français
Le modèle de 1.6B couvre l'anglais et le français d'origine. C'est une gamme étroite face à certains moteurs commerciaux, mais elle suffit pour des produits bilingues et garde le modèle assez léger pour l'auto-hébergement.
Plusieurs modes de déploiement
Vous pouvez lancer le modèle de trois façons. La version PyTorch sert à la recherche et aux essais, le serveur en Rust encaisse le trafic de production via websockets et une version quantifiée tourne sur des machines grand public.
Avantages et inconvénients
Avantages
- Poids ouverts et gratuits sous licence permissive, donc aucune facturation au caractère.
- La conception en streaming garde une latence assez basse pour une conversation en direct.
- Bon traitement par lots sur un seul GPU, ce qui baisse le coût quand on sert beaucoup d'utilisateurs à la fois.
- Adossé à un article publié, un notebook Colab et un dépôt de voix, donc vous ne partez pas de zéro.
Inconvénients
- Pas d'API hébergée, donc vous devez monter et maintenir le serveur vous-même.
- Un GPU est conseillé, ce qui exclut l'hébergement bon marché pour une charge en temps réel.
- Seuls l'anglais et le français sont pris en charge, donc les autres langues réclament un autre modèle.
- Le clonage de voix se limite à des embeddings déjà calculés, ce qui bloque les imitations libres.
Questions fréquentes
Oui. Les poids du modèle sortent sous CC-BY 4.0, donc vous pouvez les télécharger et les lancer sans frais. Ce que vous payez, c'est le matériel sur lequel il tourne.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Kyutai TTS.
Alternatives à Kyutai TTS

Prosp
Prosp · Rédaction · Voix et langage · MarketingProsp est un outil de prospection LinkedIn par IA, conçu pour les agences et les équipes commerciales. Il rédige le message et la note vocale avec votre propre voix pour chaque prospect, pour qu'ils répondent vraiment. Vous connectez vos comptes, trouvez des leads et laissez l'IA rédiger et envoyer des messages personnalisés à grande échelle, le tout depuis une seule boîte de réception. Il est fait pour qui prospecte en volume. C'est tout l'argument. Chaque contact doit quand même paraître humain.

Wordly AI Translation
Wordly · Voix et langage · ProductivitéWordly AI Translation est une plateforme de traduction et de sous-titrage par IA en temps réel conçue pour les réunions, les conférences et les événements. Elle fournit une traduction en direct, des sous-titres, des transcriptions et des résumés dans plus de 60 langues, et les participants rejoignent la session en scannant un QR code ou en ouvrant un lien, sans casque dédié. La plateforme fonctionne avec Zoom, Microsoft Teams, Google Meet et Webex, et elle vise les organisations qui veulent un accès multilingue sans embaucher d'interprètes humains pour chaque session. C'est aussi simple que ça.
Musicful
Musicful AI · Voix et langage · VidéoMusicful est un générateur de musique par IA et un créateur de clips musicaux par IA qui transforme un texte en musique en quelques minutes. Vous lui donnez un texte, des paroles ou une mélodie fredonnée, et il renvoie une piste finie avec voix et instruments. Il fait aussi office de générateur de chansons par IA, produit des clips musicaux à partir des chansons que vous créez et propose un outil de cover par IA ainsi qu'une API pour développeurs. La plateforme tourne dans un navigateur web et via une appli Android, donc vous pouvez commencer une chanson sur ordinateur et la reprendre sur votre téléphone.