
LangWatch
LangWatch B.V. · Programmation · Marketing
LangWatch est une plateforme open source d'observabilité des LLM qui trace, teste et évalue les agents IA, avec un gateway IA et la gestion des prompts au même endroit.
À propos de LangWatch
What Is LangWatch
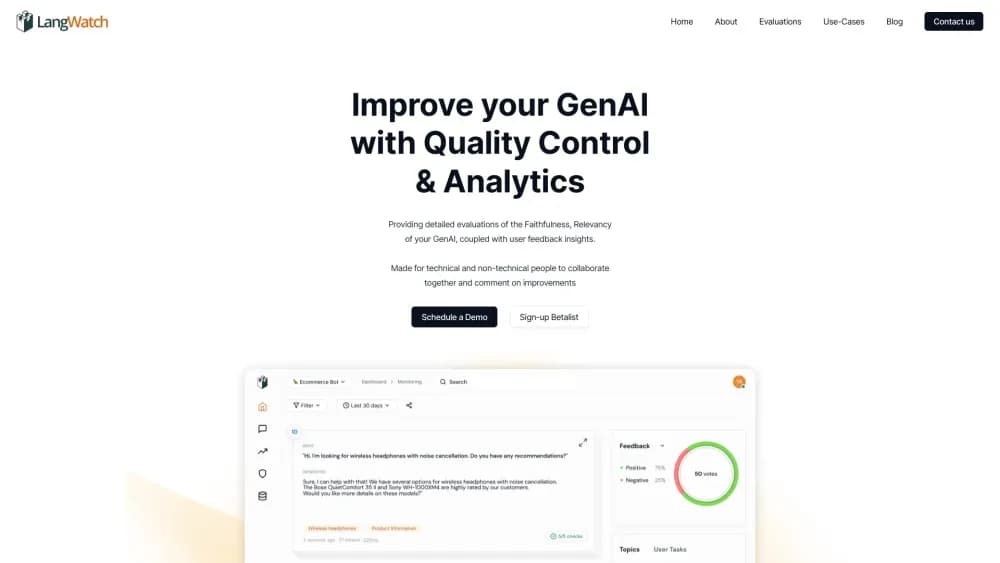
LangWatch est une plateforme LLMOps open source éditée par LangWatch B.V., société basée à Amsterdam. Elle couvre quatre chantiers qui vivent d'habitude dans des outils séparés : le traçage des LLM, les tests d'agents IA, l'évaluation des LLM et la gestion des prompts. Un gateway IA coiffe l'ensemble, si bien que chaque appel de modèle peut passer par un point d'entrée unique avec un budget rattaché.
Le projet a ouvert son code en septembre 2023 et le cœur reste sous licence Apache 2.0. Vous pouvez installer la plateforme sur votre infrastructure avec Docker ou Helm, et LangWatch Cloud fait tourner le même code. Les fonctions enterprise, comme la gouvernance de l'IA multi-sources et la détection d'anomalies, se trouvent dans un dossier sous licence distincte et demandent une offre payante.
Ce que l'outil règle, c'est le manque de visibilité. Une fois l'agent en production, une mauvaise réponse arrive rarement avec son explication. Il faut savoir quel appel d'outil a échoué, quelle recherche est revenue vide et combien la conversation a coûté. LangWatch enregistre chaque étape sous forme de trace et vous laisse rejouer le parcours. Le revers : c'est un outil de développeur. Quelqu'un dans l'équipe doit lire des traces et écrire des tests, et il n'existe pas de parcours sans code pour un product manager qui travaille seul.
Premiers pas
- Créez un projet sur app.langwatch.ai. L'offre Developer ne demande pas de carte.
- Branchez votre application avec le SDK Python ou TypeScript, ou pointez un exportateur OpenTelemetry vers le point d'entrée d'ingestion. LangChain, LangGraph, CrewAI, Mastra et Pydantic AI envoient leurs traces sans réécriture.
- Lancez l'agent une fois, puis ouvrez la vue des traces pour examiner les spans, les tokens, la latence et la conversation complète.
- Ajoutez un évaluateur ou un scénario avec utilisateur simulé, puis bloquez la fusion selon le score dans la CI.
- Déplacez les prompts vers le gestionnaire quand vous voulez versionner et tester A/B hors du code.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de LangWatch.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Ingénieurs IA qui mettent un agent en production
- Équipes plateforme en entreprise de taille moyenne
- Responsables d'ingénierie qui surveillent la dépense IA
Tâches
- Diagnostiquer une réponse fausse
- Tester les régressions avant une mise en production
- Comparer deux versions d'un prompt
- Auditer l'usage des assistants de code
Cas d'usage
- Un agent échoue sur un segment de clients
- Un fournisseur augmente ses prix du jour au lendemain
- Un déploiement réglementé impose l'auto-hébergement
Fonctionnalités clés
Traçage des LLM, quel que soit le framework
Chaque appel de modèle, appel d'outil, recherche et évaluation devient un span dans une trace, avec des spans imbriqués et un graphe d'exécution pour l'agent. Le comptage des tokens et le coût sortent automatiquement par fournisseur, prompt et modèle. Les traces se regroupent en sessions par fil de discussion, ce qui donne à lire une conversation entière plutôt qu'une requête isolée. Le texte, l'image et l'audio sont capturés aussi, un point qui compte quand l'agent traite des captures d'écran ou des notes vocales.
Tests d'agents avec utilisateurs simulés
Les tests d'agents IA partent d'un scénario écrit, et un LLM joue l'utilisateur en générant des messages réalistes à partir de ce scénario. L'exécution couvre un dialogue sur plusieurs tours, pas un prompt unique. Un agent juge note chaque tour et peut valider ou refuser à n'importe quel moment. La vérification des appels d'outils contrôle que le bon outil s'est déclenché au bon moment sur toute la conversation. Un visualiseur permet de rejouer l'exécution pas à pas et de mettre en pause pour annoter. Les tests vocaux tournent avec ElevenLabs, OpenAI Realtime, Twilio, Pipecat et Gemini Live, avec temps jusqu'au premier octet, latence p50 et p95, plus injection de bruit de fond et d'interruptions. Les tests adverses utilisent l'escalade Crescendo et la détection de refus pour trouver les failles avant un utilisateur.
Évaluation des LLM en laboratoire et en production
Les évaluateurs inclus couvrent les métriques RAGAS, l'hallucination, la toxicité, la détection de données personnelles et la notation par LLM juge. Vous lancez des expériences hors ligne depuis le SDK ou depuis un assistant sans code dans l'interface, puis comparez les exécutions sur la qualité, le coût et la latence. Les moniteurs de production notent le trafic réel et alertent quand la qualité chute. La notation porte sur un fil complet comme sur un message isolé, ce qui convient aux bots de support et aux agents à plusieurs étapes. Les jeux de données se construisent à partir de traces réelles, se génèrent avec l'IA ou acceptent des images, et une boîte d'annotations centralise la relecture humaine. Un évaluateur maison se définit une fois et se partage entre projets, et les mêmes contrôles s'exécutent en ligne comme garde-fous.
Gateway IA avec budgets par équipe
Un seul point d'entrée parle les API d'OpenAI et d'Anthropic, et route vers OpenAI, Anthropic, Google, Bedrock, Mistral ou tout autre fournisseur avec vos clés. Chaque appelant reçoit une clé virtuelle avec son budget, défini par personne, équipe ou client final. L'éditeur annonce 11 microsecondes de surcharge. Toute requête qui passe par là arrive sous forme de trace dans le même projet, donc le trafic du gateway et celui du SDK restent côte à côte.
Gestion des prompts versionnés
Les prompts sont des objets structurés avec messages, entrées et configuration, modifiables depuis le code, l'interface ou l'API. Le moteur Liquid ajoute variables et logique. La synchronisation GitHub permet de relire un changement de prompt comme une pull request, et des étiquettes marquent les versions staging et production. Un playground compare les variantes entre modèles, et les tests A/B donnent qualité, coût et latence par version. Des webhooks et Slack préviennent quand un prompt change.
Suivi des assistants de code et gouvernance de l'IA
Une commande, npx langwatch claude, place Claude Code, Codex, Copilot, Gemini CLI et opencode sur le même standard d'observation. Les sessions affichent tokens, coût et usage du cache par ingénieur et par dépôt, ce qui répond à la question de la destination réelle de la dépense IA. Le volet gouvernance de l'IA ajoute un inventaire de chaque outil et fournisseur utilisé, des règles d'anomalie sur l'activité et un journal d'audit pour les revues de sécurité.
Avantages et inconvénients
Avantages
- Cœur open source : la plateforme Apache 2.0 tourne sur votre propre ClickHouse avec Docker ou Helm, donc les traces n'ont pas à quitter votre réseau.
- Quatre outils sur un compte : traçage, tests, évaluation et prompts partagent les mêmes traces, ce qui supprime le copier-coller entre fournisseurs.
- Large couverture de frameworks : LangChain, LangGraph, CrewAI, Mastra, Pydantic AI, le SDK Vercel AI et OpenTelemetry envoient des traces sans réécrire l'agent.
- Offre gratuite utilisable : 50 000 événements par mois, deux utilisateurs et 14 jours de rétention, sans frais ni carte, de quoi tenir un prototype.
- Le gateway garde le contrôle : clés de fournisseur et budgets par personne restent dans votre compte, et chaque appel routé est tracé automatiquement.
Inconvénients
- Un outil de développeur avant tout : pas de parcours glisser-déposer pour construire un agent, et la configuration des évaluations suppose Python ou TypeScript.
- La facturation à l'usage se surveille : l'offre Growth inclut 200 000 événements puis facture 5 € par tranche de 100 000, et un agent bavard avec outils et recherches consomme bien plus vite qu'un simple chatbot.
- L'auto-hébergement implique de l'exploitation : ClickHouse et la plateforme tournent chez vous, mises à jour comprises, sauf à payer le support Enterprise.
- Gouvernance et SSO réservés à Enterprise : SSO maison, RBAC, journaux d'audit et masquage des données n'existent pas dans Growth, ce qui écarte certaines équipes réglementées jusqu'à négociation.
Questions fréquentes
LangWatch est une plateforme open source pour observer, tester et évaluer des applications LLM. Elle enregistre les traces d'agents, exécute des conversations simulées, note la qualité des réponses et gère les versions de prompts depuis un seul tableau de bord.
Contenus associés
Découvrez des outils, des compétences et des articles liés à LangWatch.
Alternatives à LangWatch

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.