
LFM2
Liquid AI · Autres
LFM2 est une famille de petits modèles de langue de Liquid AI pensée pour tourner sur l'appareil, un modèle d'IA embarqué pensé pour rester local. Les versions 350M, 700M et 1.2B sont rapides sur un simple processeur.
À propos de LFM2
What Is LFM2
LFM2 est la deuxième génération des modèles fondation de Liquid AI, sortie en juillet 2025. L'entreprise est issue du laboratoire CSAIL du MIT et conçoit des modèles qui échangent la taille brute contre la vitesse et l'efficacité mémoire. LFM2 se décline en trois versions denses : 350M, 700M et 1.2B de paramètres. Chacune est assez petite pour tourner sur un téléphone, un ordinateur portable ou le système d'une voiture sans centre de données derrière.
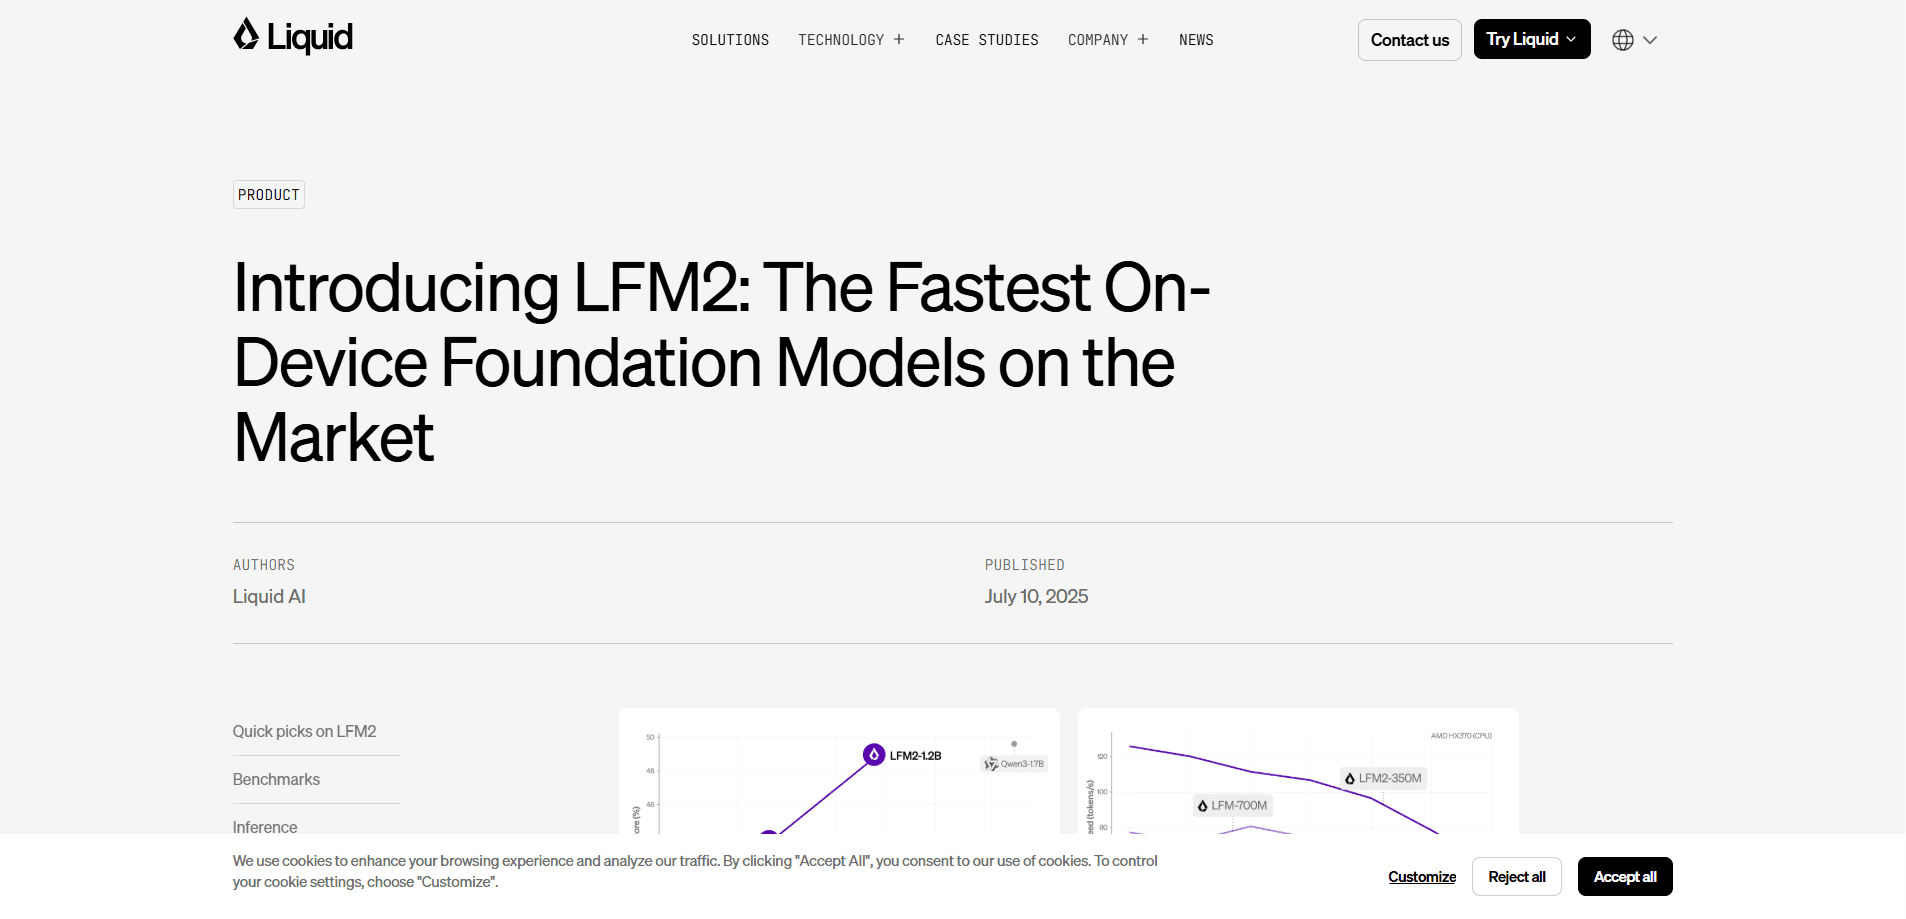
Le principe est simple. Les modèles dans le cloud sont puissants, mais lents et coûteux à faire tourner à grande échelle, et ils envoient vos données hors de l'appareil. LFM2 vise à garder une IA utile en local, là où les réponses reviennent en quelques millisecondes et où rien ne quitte la machine. Selon Liquid AI, ces modèles décodent et préremplissent deux fois plus vite que Qwen3 sur un processeur, et leur pipeline d'entraînement est 3 fois plus efficace que celui de la première génération LFM.
La limite, c'est qu'un petit modèle sait peu de choses. Liquid AI recommande d'affiner LFM2 pour des tâches précises comme l'extraction de données, le RAG ou le chat à plusieurs tours, et déconseille les travaux gourmands en connaissance, comme le raisonnement poussé ou la programmation complexe. Voyez LFM2 comme une brique rapide et privée, pas comme un assistant qui sait tout.
Getting Started
- Choisissez une version sur Hugging Face adaptée à votre matériel, du 350M pour les petits appareils au 1.2B pour un ordinateur portable ou un GPU unique
- Téléchargez les poids, ou passez par un format quantifié comme GGUF pour llama.cpp si vous voulez une empreinte encore plus réduite
- Exécutez le modèle en local via un framework compatible, dont llama.cpp, ExecuTorch ou l'outillage Transformers standard
- Affinez-le avec un framework comme TRL sur vos propres données si une version générale ne couvre pas votre tâche, puis déployez cette version sur votre appareil
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de LFM2.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs d'applications qui intègrent des fonctions locales
- Équipes soumises à des contraintes de confidentialité
- Passionnés et bricoleurs
- Startups sous 10 M$ de chiffre d'affaires
Tâches
- Flux agentiques
- Extraction de données
- Génération augmentée par récupération
- Chat à plusieurs tours
- Aide à l'écriture créative
Cas d'usage
- Une app mobile doit répondre hors ligne
- Un utilisateur d'ordinateur portable veut rédiger en local
- Un fabricant embarque de l'IA sur un appareil serré
- Une équipe réglementée doit garder les données en interne
- Un développeur prototype un agent sur le système d'une voiture
Fonctionnalités clés
Architecture hybride de convolution et d'attention
LFM2 mêle de courtes convolutions à une attention à requêtes groupées au lieu de s'appuyer sur la seule attention. Chaque modèle empile 16 blocs : 10 blocs de convolution courte à double porte et 6 blocs d'attention à requêtes groupées. Ce choix capture les motifs locaux à moindre coût et ne recourt à l'attention que là où elle rapporte, ce qui garde la latence et la mémoire basses sur le matériel réellement embarqué dans les téléphones et les ordinateurs portables.
Vitesse sur des processeurs ordinaires
La promesse tient au débit, pas à la précision brute. Selon Liquid AI, LFM2 décode et préremplit deux fois plus vite que Qwen3 sur un processeur, et le petit modèle 700M reste plus rapide qu'un Qwen 0.6B aussi bien dans llama.cpp que dans ExecuTorch malgré davantage de paramètres. Cet écart compte sur un téléphone ou un portable fin, où le processeur est la seule puce sur laquelle compter.
Quatre tailles pour différents appareils
La famille couvre 350M, 700M, 1.2B et 2.6B de paramètres, ce qui permet d'accorder le modèle à l'appareil. La version 350M trouve sa place dans les objets portables et les cibles embarquées serrées, tandis que la version 1.2B tourne sur un ordinateur portable ou un GPU unique et rivalise avec des modèles bien plus lourds. Comme il s'agit d'une famille pensée pour le bord, une seule architecture pour plusieurs tailles vous laisse monter ou descendre une fonction sans la réécrire.
Un benchmark LFM2 compétitif à petite échelle
Selon Liquid AI, LFM2-1.2B rivalise avec Qwen3-1.7B, un modèle qui compte 47 % de paramètres en plus, et ses scores approchent ceux de modèles plusieurs fois plus gros. La version 700M dépasse Gemma 3 1B IT, et celle de 350M joue à armes égales avec Qwen3-0.6B et Llama 3.2 1B Instruct. Dans les tests à plusieurs tours de l'entreprise, les évaluateurs ont préféré le modèle 1.2B à Llama 3.2 1B Instruct et Gemma 3 1B IT.
Poids ouverts et licence souple
Liquid AI publie les poids sur Hugging Face sous une licence ouverte inspirée d'Apache 2.0. L'usage académique et de recherche est gratuit, et les entreprises sous 10 M$ de chiffre d'affaires peuvent exploiter les modèles commercialement sans frais. Au-delà de ce seuil, vous contactez Liquid AI pour une licence commerciale, ce qui garde des conditions simples pour les petites équipes et laisse de la marge pour les accords avec de grands comptes.
Prise en charge d'un large outillage
LFM2 s'exporte vers les frameworks que les développeurs utilisent déjà. Il tourne via llama.cpp pour l'inférence locale, via PyTorch par ExecuTorch pour le mobile, et avec l'outillage Transformers standard pour l'entraînement. L'affinage avec TRL est une voie prise en charge, et les versions GGUF facilitent l'intégration dans des applications d'inférence existantes.
Contexte de 32K et entraînement multilingue
Chaque version gère une fenêtre de contexte de 32 768 tokens, de quoi traiter de longs documents et de longues conversations. L'entraînement s'est appuyé sur 10 000 milliards de tokens répartis à environ 75 % en anglais, 20 % en multilingue et 5 % en code, avec un effort particulier sur le japonais, l'arabe, le coréen, l'espagnol, le français et l'allemand. LFM2 convient donc aux applications qui servent plusieurs langues.
Avantages et inconvénients
Avantages
- Tourne vite sur les processeurs déjà présents dans les téléphones, les ordinateurs portables et les voitures, sans GPU ni service cloud
- Les petites versions gardent une empreinte mémoire réduite, ce qui convient aux objets portables et aux cibles embarquées serrées
- Ses scores égalent ou dépassent des modèles plus gros comme Qwen3-1.7B et Gemma 3 1B IT pour une fraction de la taille
- Des poids ouverts et une licence commerciale gratuite sous 10 M$ de chiffre d'affaires rendent le démarrage peu coûteux
- Fonctionne avec des outils connus comme llama.cpp, ExecuTorch et TRL, donc l'adoption n'impose aucune réécriture
Inconvénients
- Les petits modèles ont moins de connaissances générales, si bien que le raisonnement poussé ou la programmation complexe sortent de leur terrain
- Liquid AI recommande l'affinage pour des cas précis, ce qui ajoute du travail avant d'obtenir les meilleurs résultats
- La licence commerciale exige un accord payant dès que votre entreprise dépasse 10 M$ de chiffre d'affaires, donc monter en charge a un coût
- Des versions LFM2.5 plus récentes et des variantes plus grosses existent déjà, si bien que les trois tailles d'origine ne sont plus les plus récentes
Questions fréquentes
LFM2 est conçu pour l'IA embarquée, où un petit modèle tourne en local plutôt que dans le cloud. Les usages typiques incluent les flux agentiques, l'extraction de données, la génération augmentée par récupération, le chat à plusieurs tours et l'aide à l'écriture créative. Liquid AI oriente les développeurs vers des tâches précises et bien définies, pas vers le raisonnement généraliste.
Contenus associés
Découvrez des outils, des compétences et des articles liés à LFM2.
Alternatives à LFM2
BinkBink
BinkBink · AutresBinkBink est une plateforme de jeux en ligne gratuite et un créateur de jeux par IA qui permet à n'importe qui de transformer une courte description textuelle en un jeu de navigateur jouable. Vous pouvez plonger dans des centaines de jeux créés par la communauté. Ou décrivez votre propre idée, jouez-y en quelques secondes, puis partagez-la avec vos amis. Vous voulez créer votre propre jeu ? Pas besoin de coder. Aucun moteur à installer, aucun téléchargement, aucune prise de tête.

Audiogen
Audiogen Inc. · AutresAudiogen est un générateur de musique par IA conçu par Audiogen Inc., une petite équipe de recherche qui a passé environ deux ans et demi à entraîner son propre modèle de musique générative et à bâtir une interface web autour. Au lieu d'une simple zone de texte, cet outil de musique par IA transforme la timeline en une Station de Travail Audio Générative (GAW), pensée pour les débutants, où l'inpainting, l'extension, le remix et l'édition de pistes fonctionnent davantage comme de la peinture sur une toile. Le produit est encore en bêta, l'accès passe donc par une liste d'attente ou une invitation. Les formules payantes ne sont pas encore publiées.

Aiml API
AIMLAPI OÜ · AutresAiml API est une API unifiée de modèles d'IA qui place plus de 1000 modèles d'OpenAI, Google, Anthropic et d'autres derrière un seul point d'accès et une seule facture. Vous écrivez du code contre un unique schéma compatible OpenAI, puis vous passez d'un modèle de chat, d'image, de vidéo ou d'audio à un autre en changeant une chaîne de modèle. Elle convient aux développeurs et aux petites équipes qui veulent un accès multimodèle sans jongler avec une douzaine de comptes de fournisseurs distincts, et elle supprime le casse-tête habituel de la facturation quand on teste plusieurs prestataires. Une seule clé couvre tout.