
Liquid Inference
Architect Financial Technologies Inc. · Programmation · Productivité
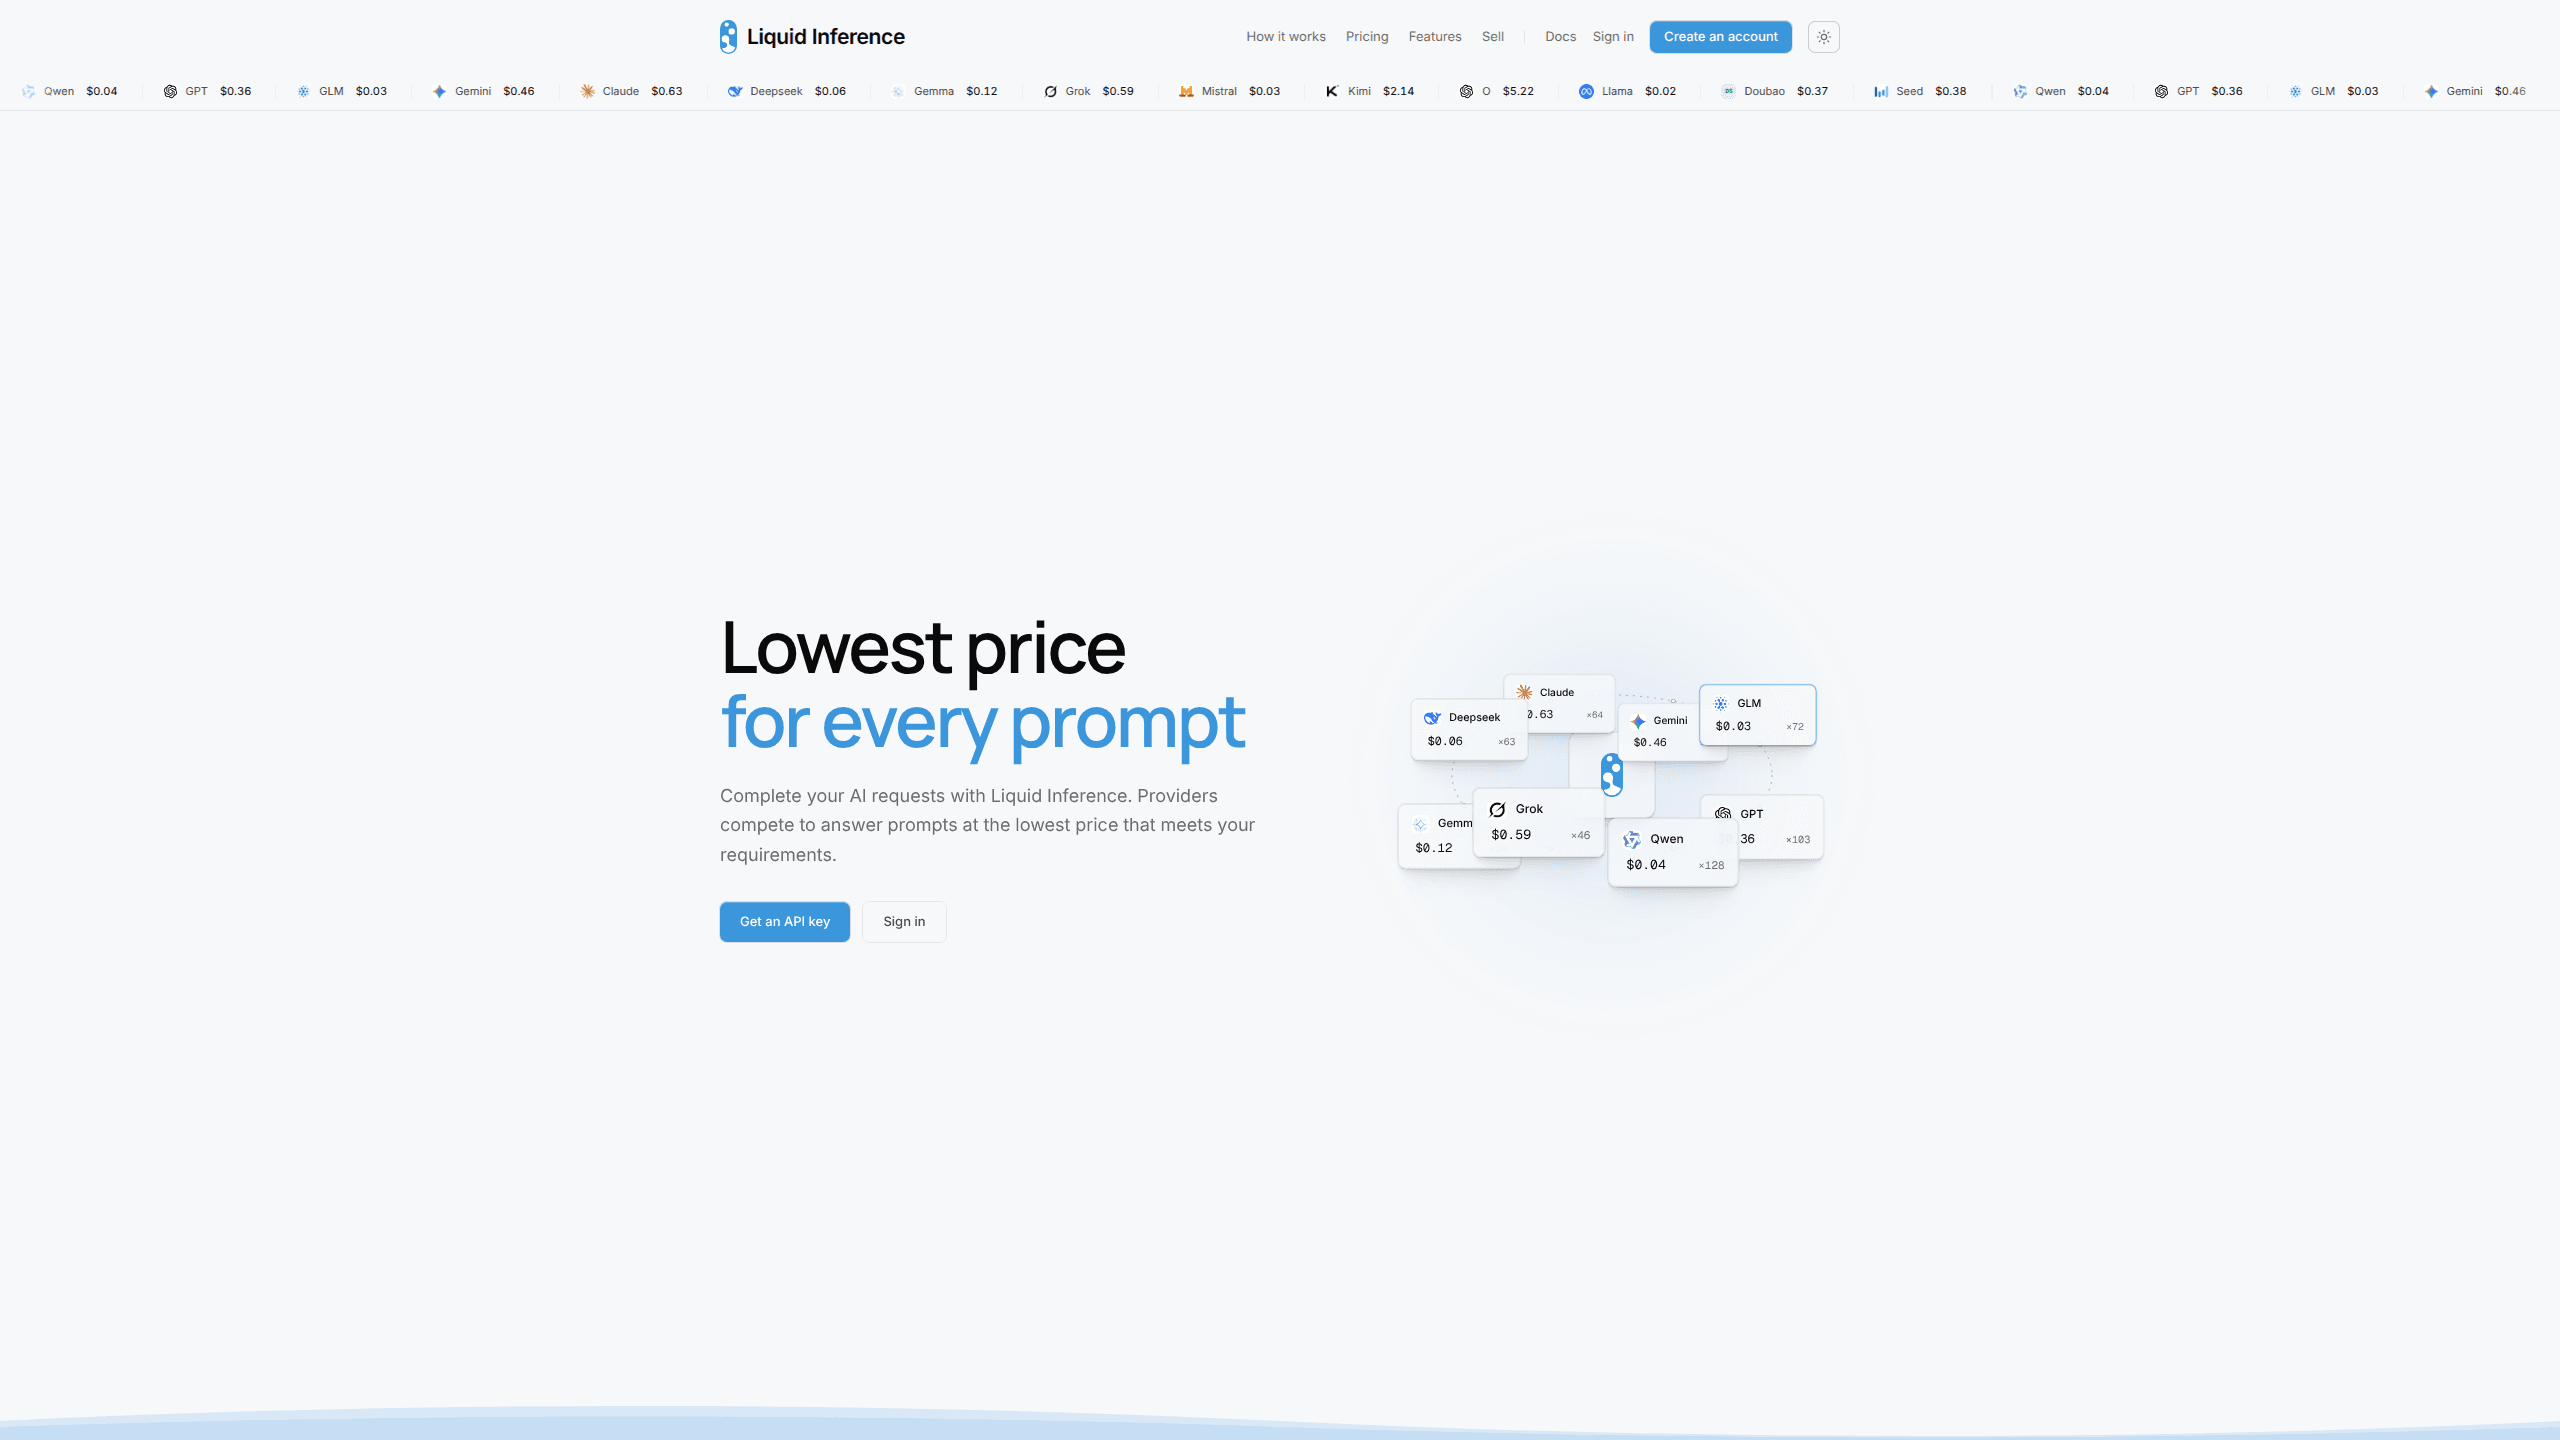
Liquid Inference est une place de marché de l'inférence IA éditée par Architect : chaque requête passe aux enchères et part vers le fournisseur le moins cher qui respecte vos règles.
À propos de Liquid Inference
About
Qu'est-ce que Liquid Inference
Liquid Inference est un routeur LLM qui fonctionne comme une bourse. Les fournisseurs publient une offre avec un prix au token pour chaque modèle qu'ils servent, et votre requête est attribuée à l'offre la moins chère qui remplit vos conditions. L'accès se fait par une interface de chat dans le navigateur ou par l'API d'inférence, qui accepte les formats d'OpenAI et d'Anthropic. La plateforme sert aussi de routeur de modèles : vous choisissez le nom et le marché décide qui le sert.
Le problème visé concerne la facture, pas le modèle. La plupart des équipes paient le tarif public d'un fournisseur fermé alors que plusieurs prestataires exploitent le même modèle ouvert. Ici, le plafond de prix est fixé avant le premier token, le budget non consommé revient sur votre solde et chaque tâche laisse un reçu indiquant le fournisseur retenu et le montant final.
Mieux vaut connaître les limites avant de basculer une charge de production. La plateforme a ouvert en octobre 2026, le nombre de vendeurs et les modèles proposés évoluent donc encore. La qualité varie selon le gagnant, ce qui explique les filtres de latence, de débit et de région dans les règles d'achat. Un plancher par token s'applique aussi, et sur les modèles très bon marché il pèse davantage que les 5 % affichés.
Premiers pas
- Créez un compte sur liquidinference.ai. L'inscription ouvre un espace de travail avec solde, clés d'API et reçus, et un crédit de départ permet de tester sans carte bancaire.
- Générez une clé sur la page dédiée. Le secret ne s'affiche qu'une fois, copiez-le avant de fermer le panneau.
- Dirigez votre client OpenAI ou Anthropic vers l'URL de base de la plateforme et remplacez la clé. Le nom du modèle doit figurer dans la liste publiée.
- Ajoutez un objet
exchangeau corps de la requête pour fixer un plafond de dépense, un délai avant le premier token, une politique de conservation ou une liste de fournisseurs autorisés. - Lisez le champ
exchangede la réponse ou ouvrez le reçu pour savoir quel fournisseur a gagné et combien la tâche a coûté.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Liquid Inference.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs qui font tourner des agents de code
- Startups à volume imprévisible
- Ingénieurs plateforme qui doivent justifier les dépenses
- Propriétaires de GPU avec de la capacité libre
Tâches
- Traitements par lots à budget plafonné
- Comparaison de modèles sur un même prompt
- Pipelines RAG et recherche
- Achat d'images, de voix ou de transcriptions
Cas d'usage
- Une boucle d'agent s'emballe et la facture grimpe
- Un fournisseur tombe en panne au milieu d'une longue série
- Une équipe cherche l'API LLM la moins chère pour un outil interne sans pouvoir tester chaque vendeur
Fonctionnalités clés
Une enchère à chaque requête
Chaque requête entre dans un carnet d'offres en direct. La plateforme écarte celles qui violent vos limites, classe les autres selon le coût estimé plus l'attente prévue, puis attribue la tâche à la meilleure. Le prix est plafonné avant la génération, le pire scénario est donc connu à l'avance.
Des règles d'achat que vous contrôlez
Un objet exchange facultatif porte les conditions. Vous y mettez un plafond en dollars, un temps maximal avant le premier token, un débit minimal, des régions autorisées, une conservation nulle et des listes de fournisseurs ou de modèles. Seules les offres qui respectent tout concourent, et la politique devient un champ de la requête plutôt qu'un ticket au support.
Bascule avant le premier token
Si le fournisseur retenu échoue avant d'écrire quoi que ce soit, la plateforme déplace la tâche vers l'offre suivante. Une fois la sortie commencée, elle ne change plus, une réponse ne mélange donc jamais deux modèles. Cette distinction compte pour les agents en streaming, où un changement en cours de flux casserait les appels d'outils déjà envoyés.
Reçus et données de marché publiques
Chaque tâche réglée possède un reçu avec le gagnant, le plafond, la consommation et la commission. Les titulaires d'un compte voient aussi le carnet d'ordres en direct, les cotations par fournisseur et les transactions conclues. Ces données sont accessibles par API avant l'envoi d'une requête, utile pour vérifier si un modèle se négocie au-dessus de son tarif habituel.
Routeur automatique et routage par axe
Avec liquid.auto, la plateforme choisit le modèle selon le score publié et le montant estimé dans la limite de votre plafond, avec des variantes premium, balanced et economy. Un suffixe au nom du modèle permet aussi de classer par plus intelligent, plus rapide ou moins cher. Dans les deux cas, l'enchère reste en dessous : le prix vient de vendeurs en concurrence.
Compatible avec votre pile actuelle
Les points d'accès forment une API compatible OpenAI pour Chat Completions et Responses, plus une route Anthropic Messages. Les SDK officiels fonctionnent après un changement d'URL de base. Des guides existent pour Claude Code, Codex, Cursor, Cline, Open WebUI, n8n, Dify, LangChain et beaucoup d'autres outils. La CLI Liquid lance un agent de code depuis le terminal avec la même clé.
Un côté vendeur pour les propriétaires de GPU
Les fournisseurs enregistrent leurs déploiements, fixent un prix par modèle et cotent pendant une session. La plateforme distribue les tâches, mesure la consommation et règle les paiements. Un propriétaire de GPU inactifs peut les monétiser sans construire sa propre facturation, et un vendeur déjà présent ailleurs peut inscrire le même déploiement ici comme seconde place.
Avantages et inconvénients
Avantages
- Le plafond est fixé avant la génération, un prompt avec une limite de sortie énorme ne peut donc pas produire de facture surprise.
- Vous gardez votre SDK et votre client. La migration se résume le plus souvent à une URL de base et une clé, sans réécriture.
- Les règles d'achat couvrent latence, région et conservation des données, ce qui rend la place de marché utilisable pour des charges soumises à des contraintes de conformité.
- Les reçus et le carnet public gardent la trace du coût de chaque tâche et du fournisseur qui l'a servie.
- Le côté vendeur offre aux propriétaires de GPU un moyen d'occuper leur capacité inactive sans pile de facturation maison.
Inconvénients
- La plateforme est récente. Ouverte en octobre 2026, elle compte moins de vendeurs que les routeurs établis, et la couverture des modèles peut évoluer sans préavis.
- Le plancher de 0,01 dollar par million de tokens pénalise les offres bon marché et gratuites. Sur un petit modèle, la commission effective peut approcher la moitié de ce que facture le fournisseur.
- La qualité dépend du gagnant. L'enchère optimise le prix et les performances déclarées, pas la qualité d'une réponse précise, et un score élevé ne garantit pas un meilleur résultat.
- Une requête ne peut pas changer de fournisseur une fois la sortie lancée. Si le vendeur se dégrade en cours de flux, il reste une réponse partielle et une nouvelle tentative.
Questions fréquentes
Liquid Inference est une place de marché de l'inférence LLM éditée par Architect Financial Technologies. Les fournisseurs publient des prix pour les modèles qu'ils servent et chaque requête est attribuée à l'offre la moins chère respectant les règles de coût, de vitesse, de région et de données de l'acheteur. L'accès se fait par le web, par API et par CLI.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Liquid Inference.
Alternatives à Liquid Inference

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.