
LiteLLM
BerriAI · Programmation · Autres
LiteLLM est une passerelle IA et une bibliothèque Python open source qui appelle plus de 100 LLM via une seule interface au format OpenAI, avec routage, suivi des dépenses et garde-fous.
À propos de LiteLLM
What Is LiteLLM
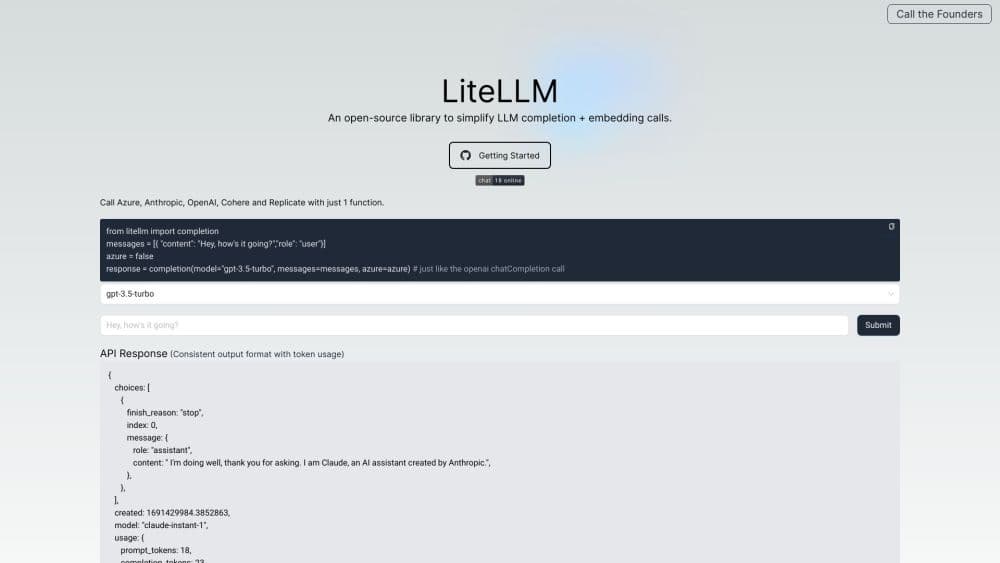
LiteLLM est un outil de BerriAI qui offre aux développeurs une seule interface pour appeler des modèles d'OpenAI, Anthropic, Gemini, Bedrock, Azure, Ollama et des dizaines d'autres fournisseurs. Au lieu d'apprendre un SDK, un mode d'authentification et un format de réponse différents pour chaque fournisseur, vous écrivez un seul appel et changez le nom du modèle quand vous voulez basculer vers un autre backend.
Le problème qu'il résout, c'est la dépendance à un fournisseur unique. Les équipes qui construisent sur une seule plateforme découvrent souvent que changer de modèle implique de réécrire les constructeurs de requêtes, la gestion des erreurs et la logique de streaming dans tout le code. LiteLLM place une couche de traduction sous votre code, si bien que la logique métier reste identique pendant que le modèle sous-jacent change dans un fichier de configuration.
Deux façons de l'utiliser couvrent la plupart des besoins. Le SDK Python s'intègre à une application existante sous forme de paquet, tandis que la passerelle (serveur proxy) fonctionne comme un service auto-hébergé qui centralise les clés virtuelles, les budgets et les journaux pour toute une équipe. Le revers de cette commodité, c'est que la passerelle ajoute de l'infrastructure à maintenir, et que la version open source suppose que vous l'hébergiez et la mettiez à jour vous-même.
Getting Started
- Installez le paquet avec
uv add litellmoupip install litellm, puis définissez les clés d'API de vos fournisseurs en variables d'environnement. - Pour la voie du SDK, importez
completionet appelez-la avec un nom de modèle commeopenai/gpt-4oouanthropic/claude-sonnet-4, en passant votre liste de messages. - Pour la voie de la passerelle, lancez
litellm --model gpt-4oou déployez l'image Docker, puis pointez n'importe quel client OpenAI vers l'URL de base locale. - Ajoutez une configuration Router quand vous voulez des nouvelles tentatives et des replis entre plusieurs déploiements, et connectez Postgres et Redis si vous faites tourner plus d'une instance de la passerelle.
- Suivez l'usage depuis le tableau de bord d'administration ou via un callback, et fixez des budgets par clé, utilisateur ou équipe à mesure que le trafic augmente.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de LiteLLM.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Ingénieurs backend
- Équipes plateforme et ML
- Chefs de produit qui mènent des tests
Tâches
- Accès unifié aux modèles
- Maîtrise des coûts
- Tolérance aux pannes et répartition de charge
- Observabilité
Cas d'usage
- Une startup partie sur un fournisseur et qui veut ajouter des modèles moins chers sans toucher à la logique métier.
- Une entreprise qui fait tourner une passerelle auto-hébergée pour que le trafic des modèles et les clés restent dans sa propre infrastructure.
- Une séance de prototypage où un seul script teste le même prompt sur cinq modèles différents.
Fonctionnalités clés
API unifiée pour plus de 100 fournisseurs
Une seule interface couvre OpenAI, Anthropic, Gemini, Bedrock, Azure, Vertex AI, Ollama, vLLM et bien d'autres. Toutes les réponses arrivent au format chat completions d'OpenAI, donc le code qui lit choices[0].message.content continue de fonctionner après un changement de fournisseur.
Compatibilité directe avec OpenAI
Les projets qui utilisent déjà le SDK OpenAI peuvent pointer leur client vers une passerelle LiteLLM en changeant l'URL de base et la clé. Aucun changement de code n'est nécessaire côté requêtes, ce qui en fait un moyen à faible risque d'ajouter le support de plusieurs modèles à une application en production.
Serveur proxy et passerelle LLM
La passerelle auto-hébergée sert de point de contrôle central pour une équipe. Elle gère les clés virtuelles, enregistre la dépense par clé, utilisateur, équipe et organisation, applique des limites RPM et TPM, et inclut un tableau de bord d'administration pour le quotidien.
Router avec nouvelles tentatives et replis
Le module Router coordonne plusieurs déploiements du même modèle. Il relance les appels échoués, bascule vers un déploiement sain quand un fournisseur tombe et répartit la charge entre les backends pour qu'un point d'accès lent ne bloque pas toute l'application.
Suivi des dépenses et budgets
LiteLLM calcule le coût de chaque appel et l'enregistre au nom de la clé ou du projet qui l'a émis. Les équipes peuvent fixer des budgets mensuels et des limites de débit, puis consulter la dépense sans construire leur propre système de mesure.
Observabilité et garde-fous
Une seule ligne de callback envoie journaux, comptages de tokens et traces vers Langfuse, MLflow, Helicone et d'autres outils. Les garde-fous permettent de filtrer ou de bloquer les entrées et sorties dangereuses, et la conversion des erreurs ramène les exceptions propres à chaque fournisseur vers des types OpenAI connus.
Avantages et inconvénients
Avantages
- Une interface au format OpenAI supprime le besoin d'apprendre un SDK distinct pour chaque fournisseur de modèles.
- Les changements de modèle se font dans la configuration, ce qui réduit le risque qu'un changement de fournisseur casse le code en production.
- Le cœur open source est gratuit sous licence MIT et peut tourner entièrement en auto-hébergé.
- Les nouvelles tentatives et replis du Router améliorent la disponibilité quand un fournisseur subit une panne.
- Le suivi des dépenses et les budgets donnent aux équipes une visibilité sur des coûts souvent invisibles autrement.
Inconvénients
- La passerelle est un service de plus à déployer, surveiller et mettre à jour, ce qui ajoute du travail d'exploitation aux petites équipes.
- La faire tourner sur plusieurs instances exige Postgres et Redis, si bien qu'un déploiement sérieux impose de vrais besoins d'infrastructure.
- Des fonctions comme le SSO, le SCIM, les journaux d'audit et le déploiement en réseau isolé restent derrière l'offre Enterprise payante.
- Les particularités des nouveaux fournisseurs peuvent arriver après les SDK officiels, donc des points d'accès peu utilisés demandent parfois une configuration supplémentaire.
Questions fréquentes
LiteLLM permet à une application d'appeler de nombreux fournisseurs de LLM via une seule interface au format OpenAI. Les développeurs l'utilisent pour éviter de réécrire du code à chaque changement de modèle et pour centraliser clés, budgets et journaux derrière une passerelle auto-hébergée.
Contenus associés
Découvrez des outils, des compétences et des articles liés à LiteLLM.
Alternatives à LiteLLM

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.