
LLMTest
LLMTest · Programmation
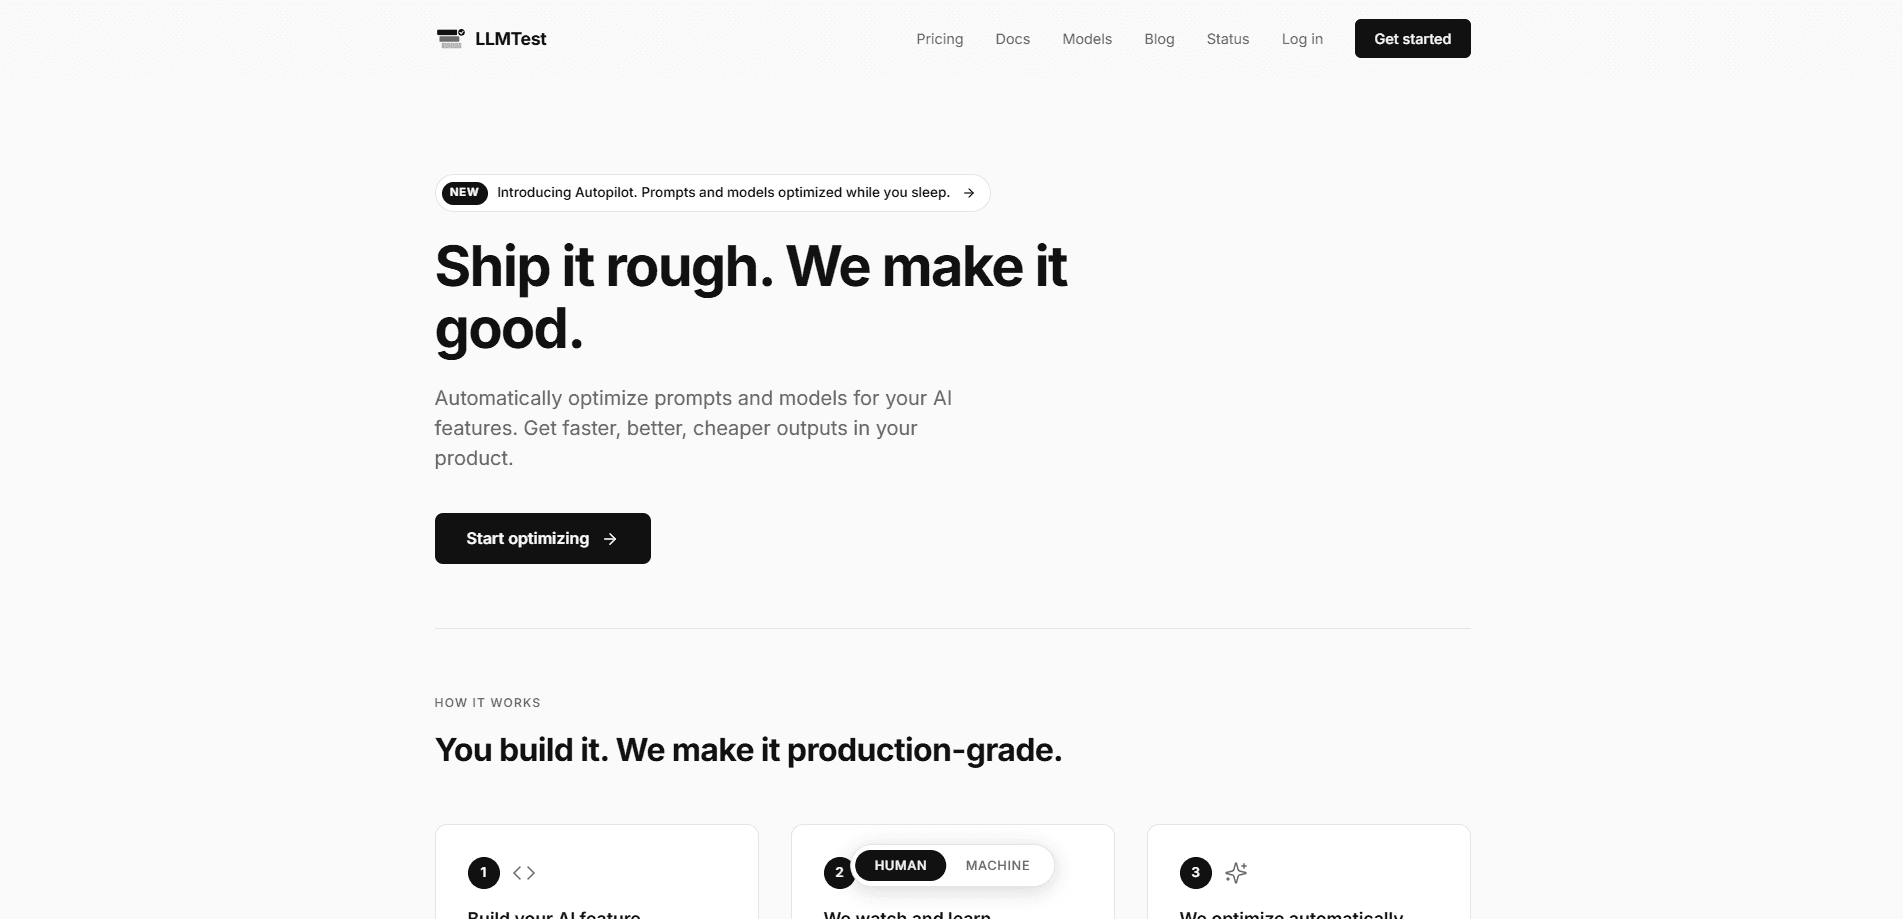
LLMTest est une plateforme basée sur un proxy pour livrer et tester des fonctionnalités d'IA construites sur de grands modèles de langage. Vous pointez votre application vers son point d'accès compatible avec OpenAI, vous choisissez l'un des plus de 340 modèles, et il gère pour vous les bascules automatiques, la réparation du JSON et le suivi des coûts. Il évalue aussi les modèles avant que vous ne livriez et, avec Autopilot, continue d'ajuster vos prompts et vos choix de modèles sur du trafic réel chaque semaine.
À propos de LLMTest
Qu'est-ce que LLMTest
LLMTest est un service qui se place entre votre produit et les fournisseurs de modèles que vous appelez. Au lieu de connecter votre application directement à OpenAI, Anthropic ou Google, vous faites passer les appels par le proxy de LLMTest à l'adresse https://llmtest.io/v1. Ce point d'accès unique parle le format d'OpenAI, donc la plupart des équipes changent une ligne (l'URL de base) et rien d'autre.
Le problème qu'il vise est familier à quiconque a livré une fonctionnalité d'IA : vous ne savez pas si vous avez choisi le bon modèle, vous ne savez pas ce que chaque fonctionnalité coûte réellement, et vous ne voulez pas que votre application casse quand un fournisseur passe une mauvaise journée. Voyez-le comme un proxy LLM avec des partis pris. LLMTest répond à ces trois questions. Il évalue plus de 340 modèles sur vos propres prompts, étiquette chaque appel par flux pour que vous voyiez le coût et la latence par fonctionnalité, et redirige les requêtes automatiquement quand un modèle est en panne ou limité en débit. La principale limite, c'est qu'il est conçu pour des développeurs, pas pour des utilisateurs finaux.
La principale limite, c'est qu'il est conçu pour des développeurs, pas pour des utilisateurs finaux. Il n'y a pas d'interface glisser-déposer pour les profils non techniques, et Autopilot ne se déclenche que sur les comptes de 14 jours ou plus avec au moins 20 appels réels sur un flux. Il faut être à l'aise pour modifier du code et lire un tableau de bord. C'est le compromis. Vous gagnez beaucoup de contrôle, mais vous apportez la compétence technique.
Une bascule de modèle ici veut dire une chose : quand un fournisseur échoue, un autre modèle reprend la requête. LLMTest fait ce remplacement pour vous.
Premiers pas
- Inscrivez-vous sur llmtest.io/signup et ajoutez 5 dollars de crédits à votre compte.
- Copiez votre clé d'API depuis le tableau de bord. Les clés commencent par
llmt_. - Remplacez votre URL de base par
https://llmtest.io/v1et utilisez votre clé LLMTest, ou choisissez un modèle si vous partez de zéro. - Ajoutez éventuellement un en-tête
X-Flowpour étiqueter les appels, afin que le coût et la latence soient regroupés par fonctionnalité. - Activez Autopilot quand votre compte est assez ancien et qu'un flux a du trafic réel, puis laissez-le tourner chaque semaine.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de LLMTest.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs qui livrent des fonctionnalités d'IA
- Responsables techniques qui surveillent les dépenses d'IA
- Équipes qui choisissent un modèle de zéro
Tâches
- Ajouter des bascules de modèles sans nouveau code
- Réparer les réponses JSON cassées
- Trouver des modèles moins chers qui gardent la qualité
- Suivre le coût en tokens par fonctionnalité
Cas d'usage
- Un chatbot qui casse quand un fournisseur tombe
- Une startup qui prépare sa première fonctionnalité d'IA
- Un produit en production avec des sorties de modèles chaque semaine
Fonctionnalités clés
Un point d'accès unique compatible avec OpenAI pour plus de 340 modèles
LLMTest expose une seule API à l'adresse https://llmtest.io/v1 qui parle le format d'OpenAI. Cela veut dire que le paquet officiel openai pour JavaScript et Python fonctionne après avoir changé l'URL de base et la clé. Vous pouvez appeler gpt-4o, anthropic/claude-sonnet-4, google/gemini-2.5-flash, meta-llama/llama-4-scout ou tout autre modèle pris en charge par le même chemin de code. Voyez-le comme une passerelle LLM qui cache la dispersion des fournisseurs. Pour une équipe qui utilise déjà un SDK OpenAI, c'est la migration la plus légère possible.
Bascules automatiques et récupération du JSON
Les bascules et la réparation du JSON fonctionnent dès que vous passez par le proxy, sans indicateurs de fonctionnalité ni code supplémentaire. Si un modèle renvoie un 429 ou un 5xx, LLMTest relance votre requête sur un autre modèle et votre application ne voit jamais l'échec. Si vous demandez une sortie JSON et que le modèle renvoie quelque chose de mal formé, le proxy le corrige ou le relance. Vous ne voyez que la forme de réponse standard, donc votre logique d'analyse reste inchangée. Si vous voulez tracer le moment d'un remplacement, l'en-tête de réponse x-llmtest-fallback-model indique quel modèle a réellement servi l'appel. Aucune devinette. Il vous le dit, c'est tout.
Suivi des coûts par flux
Chaque appel est journalisé avec le nombre de tokens, la latence et le coût. Vous étiquetez les appels avec un en-tête facultatif X-Flow, et LLMTest regroupe le tout par ce nom. Ainsi « chatbot de support » et « descriptions produit » apparaissent comme des lignes distinctes au lieu d'un total flou. C'est la partie utile. C'est ce qui permet de discuter du coût de l'IA avec des chiffres plutôt qu'à l'intuition.
Évaluer avant de livrer
Si vous n'avez pas encore choisi de modèle, le mode benchmark de LLMTest comble ce manque. Vous décrivez la fonctionnalité d'IA, le système génère des prompts de test et lance des benchmarks intelligents sur plus de 340 modèles. Un juge d'IA note chaque sortie, et la logique de sélection retient les concurrents les plus pertinents plutôt que de tester les 340 à l'aveugle. Aucun trafic réel nécessaire. Vous pouvez comparer les modèles avant le lancement.
Optimisation hebdomadaire avec Autopilot
Autopilot réécrit vos prompts et cherche des modèles moins chers ou meilleurs sur votre trafic réel, en tournant chaque semaine en arrière-plan. Il teste des variantes plus courtes et moins chères, et seuls les gains sûrs passent en production. Vous recevez un courriel le lundi matin avec ce qui a changé, ce que vous avez économisé et un lien de retour en arrière de 24 heures. Un clic annule n'importe quel changement.
Garde-fous sur chaque changement
Les changements d'Autopilot passent cinq contrôles avant d'être publiés, ce qui est la partie qui compte si vous tenez à ne pas casser la production. Un gain nécessite un taux de victoire avec 95 % de confiance, deux juges indépendants (Claude Sonnet et GPT-4o, positions inversées) qui s'accordent à 80 % ou plus, au moins 20 % d'économies, un ensemble doré de cinq entrées connues comme bonnes qui passe, et aucun biais de longueur (les variantes 50 % plus longues que la base nécessitent une validation humaine). Il ignore aussi les comptes de moins de 14 jours et applique un délai de 14 jours par flux, donc la même fonctionnalité n'est jamais réajustée deux fois dans cette fenêtre. Cela fait beaucoup de garde-fous.
Serveur MCP pour les flux dans l'IDE
LLMTest tourne aussi comme serveur MCP dans votre IDE, à côté du proxy de production. La plupart des équipes utilisent le proxy en production pour la fiabilité et le suivi des coûts, et le serveur MCP pendant le développement pour l'évaluation et la sélection de modèles. Les deux partagent la même clé d'API et les mêmes données, donc ce que vous testez pendant le développement correspond à ce qui tourne en production.
Avantages et inconvénients
Avantages
- Un point d'accès couvre plus de 340 modèles d'OpenAI, Anthropic, Google, Meta et Mistral, ce qui réduit le besoin de gérer des intégrations de fournisseurs séparées.
- Les bascules et la récupération du JSON sont activées par défaut, donc la fiabilité fonctionne sans code ajouté.
- Le suivi des coûts par flux donne une ventilation des dépenses d'IA que la plupart des équipes ne peuvent pas produire autrement.
- Les cinq garde-fous d'Autopilot (confiance, juges doubles, plancher d'économies, ensemble doré, contrôle de longueur) rendent les changements automatiques de prompt moins risqués qu'ils n'en ont l'air.
- Le coût d'entrée de 5 dollars est assez bas pour tester tout l'ensemble sur une vraie fonctionnalité.
Inconvénients
- Autopilot ne tourne pas avant qu'un compte ait 14 jours ou plus et qu'un flux ait 20 appels réels ou plus, donc les nouveaux projets attendent avant que la fonctionnalité phare s'active.
- Il n'y a pas de page de tarifs publique avec des formules fixes ; vous ajoutez des crédits et payez à l'usage, ce qui rend le budget moins prévisible au départ.
- Il suppose que vous êtes développeur. Les utilisateurs non techniques ne tireront pas grand-chose d'un proxy qui demande une URL de base et des en-têtes.
Questions fréquentes
C'est une couche de proxy et de test pour les fonctionnalités d'IA. Vous faites passer vos appels de modèles par son point d'accès compatible avec OpenAI, et il ajoute des bascules, la réparation du JSON, le suivi des coûts, l'évaluation de modèles et l'optimisation automatique des prompts. Toujours pas sûr d'en avoir besoin ? Lisez la suite.
Contenus associés
Découvrez des outils, des compétences et des articles liés à LLMTest.
Alternatives à LLMTest
Forefront
Forefront · ProgrammationForefront est une plateforme web pour construire avec de l'IA open source. Elle vous laisse affiner les principaux modèles de langage open source sur vos propres données, évaluer leurs performances et les exécuter via une API ou les exporter pour les héberger vous-même. Les développeurs qui veulent le confort d'une plateforme fermée mais tiennent à rester propriétaires de leurs modèles et de leurs données sont le public visé ici.

Startkit
StartKit.AI · ProgrammationStartkit est un boilerplate pour créer des produits SaaS d'IA et des wrappers d'IA. Voyez-le comme un boilerplate de startup IA avec les parties ennuyeuses déjà branchées : authentification, paiements Stripe et Lemon Squeezy, limites d'usage, e-mail transactionnel et un kit de démarrage d'API IA qui parle à OpenAI, Anthropic, Groq ou Llama. Vous clonez le dépôt, fixez votre prix et attaquez la partie du produit pour laquelle les gens paient vraiment. Il repose sur Next.js au-dessus de React et Tailwind, donc une bonne partie du code boilerplate vous semble déjà familière.
Testim
Tricentis · ProgrammationTestim est une plateforme d'automatisation des tests dopée à l'IA, qui sert à créer et exécuter des tests de bout en bout sur des applications web, mobiles et Salesforce. Elle s'appuie sur l'apprentissage automatique pour garder les tests stables quand une interface change, alors les équipes passent moins de temps à réparer des sélecteurs cassés. Pas mal pour un outil de tests automatisés que vous pouvez utiliser dès aujourd'hui. Vous créez des tests en enregistrant des actions dans un navigateur, puis vous ajoutez du JavaScript quand vous avez besoin de plus de contrôle. C'est un choix solide pour une équipe QA bien occupée.