
Maximem Synap
Maximem · Programmation · Productivité · Autres
Maximem Synap est une couche de mémoire managée pour agents IA qui conserve une mémoire structurée à long terme entre les sessions et compacte le contexte pour réduire le coût en tokens.
À propos de Maximem Synap
About
Qu'est-ce que Maximem Synap
Maximem Synap est une couche de mémoire hébergée qui s'installe entre votre application et son modèle de langage. Elle reçoit des conversations et des documents, en extrait des faits, des préférences, des épisodes et des événements datés, puis renvoie la part de mémoire qui correspond à la requête en cours. Votre agent cesse d'ouvrir chaque session sur une page blanche.
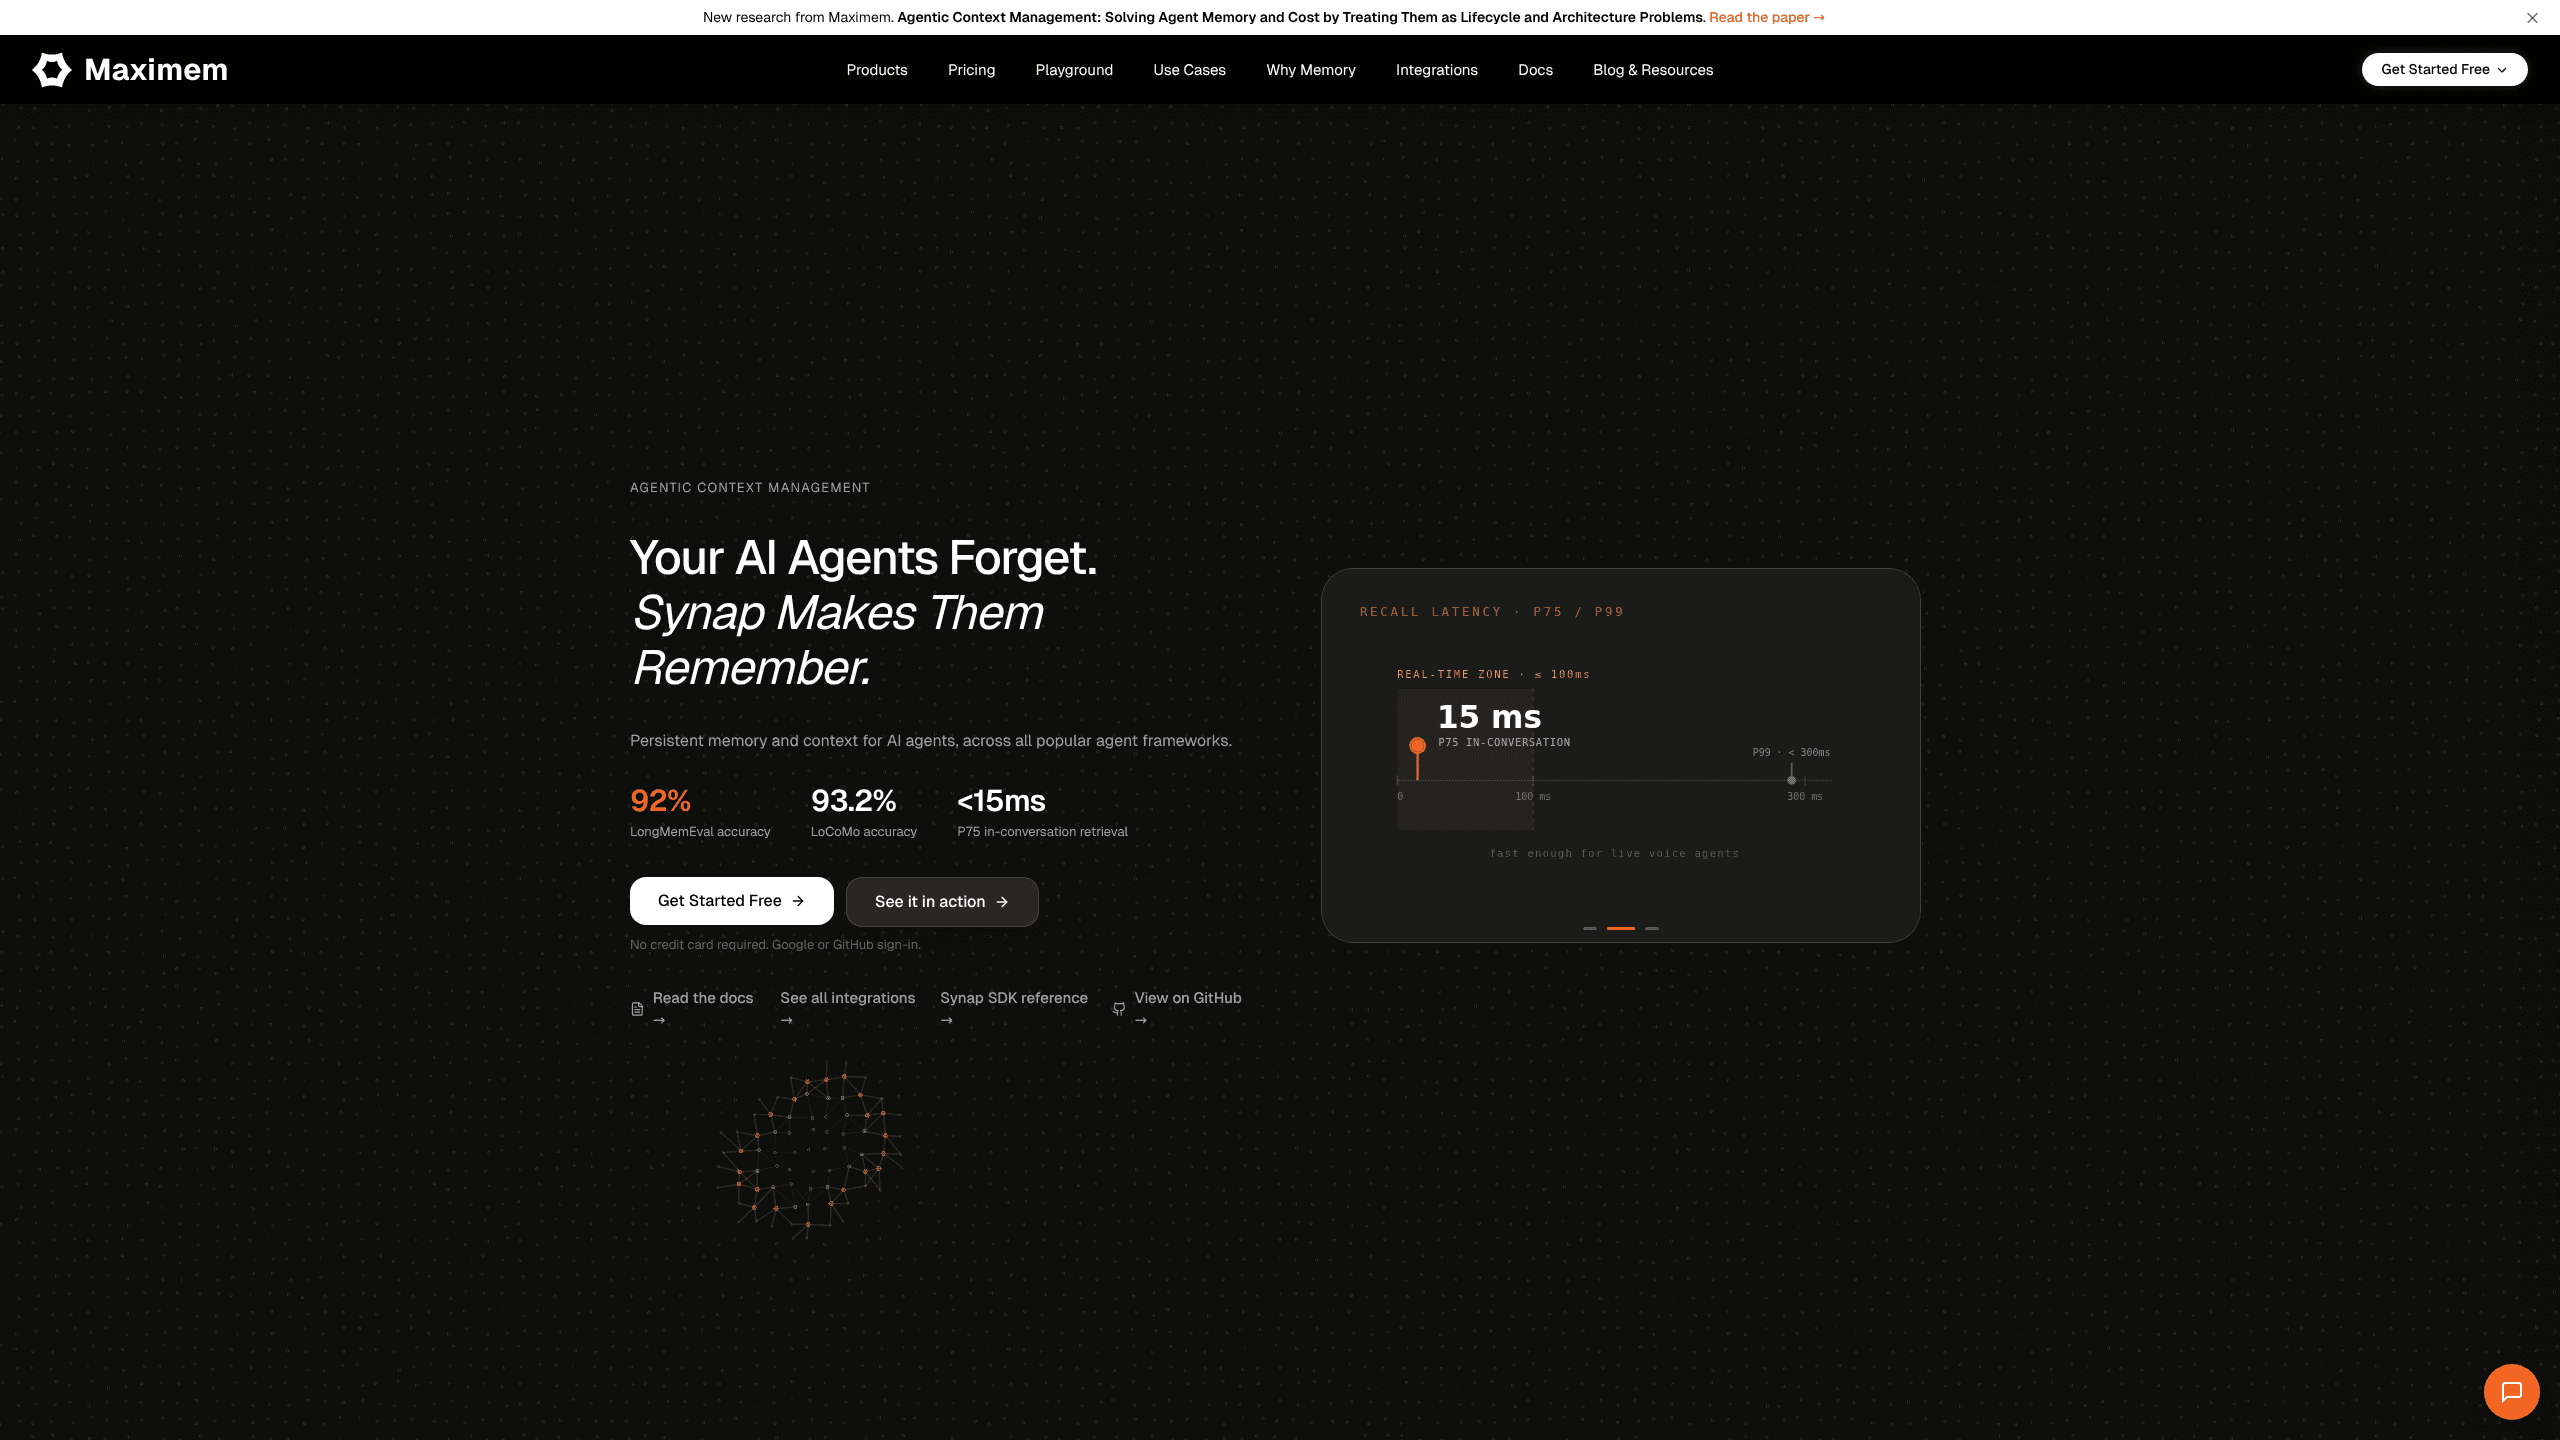
Derrière l'outil se trouve Maximem, la société qui a publié Synap comme implémentation de référence dans un article arXiv sur la gestion agentique du contexte. Elle annonce 95,6 % sur LongMemEval et 93,2 % sur LoCoMo, avec le modèle de réponse et le modèle juge indiqués à côté de chaque chiffre. Ce sont des résultats d'éditeur, publiés avec leurs conditions, pas un verdict indépendant.
Deux limites comptent avant de payer. La qualité dépend du mode de recherche appelé et du modèle qui répond, si bien que le chemin rapide avec un petit modèle ne reproduira pas la passe du benchmark. Et la facturation passe par des crédits par opération, donc la note suit votre façon de chercher et d'ingérer les données, pas le nombre de sièges.
Premiers pas
- Créez un compte sur synap.maximem.ai, puis copiez une clé d'API depuis le tableau de bord.
- Installez le SDK Python avec
pip install maximem-synap, ajoutez le paquet JavaScript ou TypeScript, ou passez outre le code et reliez un client MCP au serveur hébergé avec une URL et un jeton. - Rédigez un court fichier de cas d'usage. Synap en déduit l'architecture de mémoire de l'instance, si bien que le schéma suit votre domaine au lieu d'un modèle générique.
- Chargez vos conversations et documents passés en bloc, ou envoyez les nouveaux tours au fil de l'eau.
- Récupérez du contexte à chaque tour, puis compactez les longs fils dès que l'historique dépasse votre budget de tokens.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Maximem Synap.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Équipes produit IA qui construisent des assistants pour des utilisateurs récurrents
- Ingénieurs SaaS et plateformes de support
- Développeurs indépendants qui ajoutent de la mémoire à un agent de code
Tâches
- Conserver les préférences client d'une session à l'autre
- Recharger l'historique avant la mise en ligne
- Réduire les tokens de contexte sur les longs fils
- Cloisonner la mémoire par client
Cas d'usage
- Un copilote de support qui se souvient du forfait d'un client, de ses escalades passées et de son ton préféré sur des mois de tickets.
- Un agent de code qui retient les conventions du projet, les pistes écartées et les commentaires de revue entre deux sessions.
- Un produit B2B où chaque organisation cliente a besoin de son îlot de mémoire dans un seul déploiement.
Fonctionnalités clés
Une mémoire structurée, pas une transcription
La plupart des outils de mémoire pour agents IA stockent la transcription et la fouillent ensuite. Synap extrait des faits, des préférences, des épisodes, des émotions et des événements temporels, puis les conserve sous forme d'enregistrements typés. La recherche travaille sur ces enregistrements, donc une réponse peut s'appuyer sur une préférence de mars sans rejouer trois mois de conversation. Vous décrivez l'architecture de mémoire de votre domaine au lieu d'accepter un schéma figé.
Trois modes de recherche à des prix différents
Le chemin rapide coûte un crédit par requête et couvre la majorité des lectures dans un tour. L'hybride en coûte deux et ajoute une seconde passe. Le mode précis en coûte trois et ajoute la décomposition de la requête et un reranking. Maximem annonce une latence P75 sous 15 ms en recherche conversationnelle, le chiffre qui décide si la mémoire paraît instantanée ou lente.
Compactage agentique du contexte
Les longs historiques sont compressés en un résumé que vous récupérez plus tard, avec des appels pour vérifier si le compactage est périmé ou toujours en cours. Le but n'est pas de raccourcir pour raccourcir. Le compactage tient un budget de tokens sans perdre les détails qui changent une réponse, et Maximem affirme qu'avec l'anticipation il divise à peu près par deux les tokens de contexte par tour.
Recherche anticipée
Un flux d'écoute surveille la conversation et fait remonter les souvenirs probablement utiles avant que l'agent ne les demande, ce qui supprime un aller-retour à chaque tour. C'est aussi la fonction la plus difficile à juger sur une démo, alors testez-la sur votre propre trafic avant de bâtir un process dessus.
Portées de mémoire multi-tenant
Chaque enregistrement repose sur une échelle de portées qui vaut par défaut User, Customer et Client. Les lectures remontent la chaîne par priorité, les écritures restent là où vous les placez et une instance sert de nombreux clients. La suppression s'exécute par utilisateur via le SDK et l'API, la question qui arrive en premier dans un audit de sécurité.
SDK, serveur MCP et connecteurs
Les SDK natifs couvrent Python 3.11+ et Node.js 20+, et la version JavaScript tourne sur Vercel Edge, Cloudflare Workers et dans le navigateur pour les appels de mémoire et de contexte. Des connecteurs existent pour Claude Agent SDK, CrewAI, AutoGen, Microsoft Agent Framework et Vercel eve. Le serveur MCP couvre les plateformes sans code comme n8n, Gumloop et Claude.
Sécurité et audit
Le trafic passe en TLS 1.3, les données applicatives sont chiffrées au repos en AES-256 et les clés d'API sont hachées en SHA-256 avant stockage. La piste d'audit va de 7 jours sur l'offre Trial à 180 jours sur Scale, avec une rétention sur mesure en Enterprise.
Avantages et inconvénients
Avantages
- Les chiffres de benchmark arrivent avec le modèle de réponse, le modèle juge et la version du jeu de données, et le harnais comme les sorties sont publics.
- Toutes les offres embarquent l'ensemble des fonctions, donc le prix d'entrée achète les mêmes modes de recherche et le même compactage que l'offre haute.
- L'échelle de portées règle la mémoire multi-tenant sans que vous construisiez une couche d'isolation.
- Les SDK couvrent Python, Node et les environnements edge, et le serveur MCP évite tout code.
- Le prix par crédit et par opération est publié, donc vous estimez la facture avant de vous engager.
Inconvénients
- Les crédits compliquent la prévision : un document coûte de 2 à 25 crédits selon sa longueur, et une ingestion lourde épuise vite l'enveloppe Starter.
- L'essai gratuit plafonne à 12 500 crédits et une seule instance, de quoi tenir un prototype et guère plus.
- Aucune option auto-hébergée. Le BYOK couvre les clés du modèle, pas l'endroit où vit la mémoire.
- Presque toutes les preuves viennent des passes de l'éditeur. Les comparaisons indépendantes restent rares.
Questions fréquentes
Il donne à l'agent une mémoire qui survit à une conversation. Vous envoyez des conversations ou des documents, Synap en extrait une mémoire structurée, et les appels suivants renvoient un contexte classé et cloisonné par portée pour le tour en cours.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Maximem Synap.
Alternatives à Maximem Synap

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.