
MemoryCustodian
Zekun Wang (waittim) · Programmation
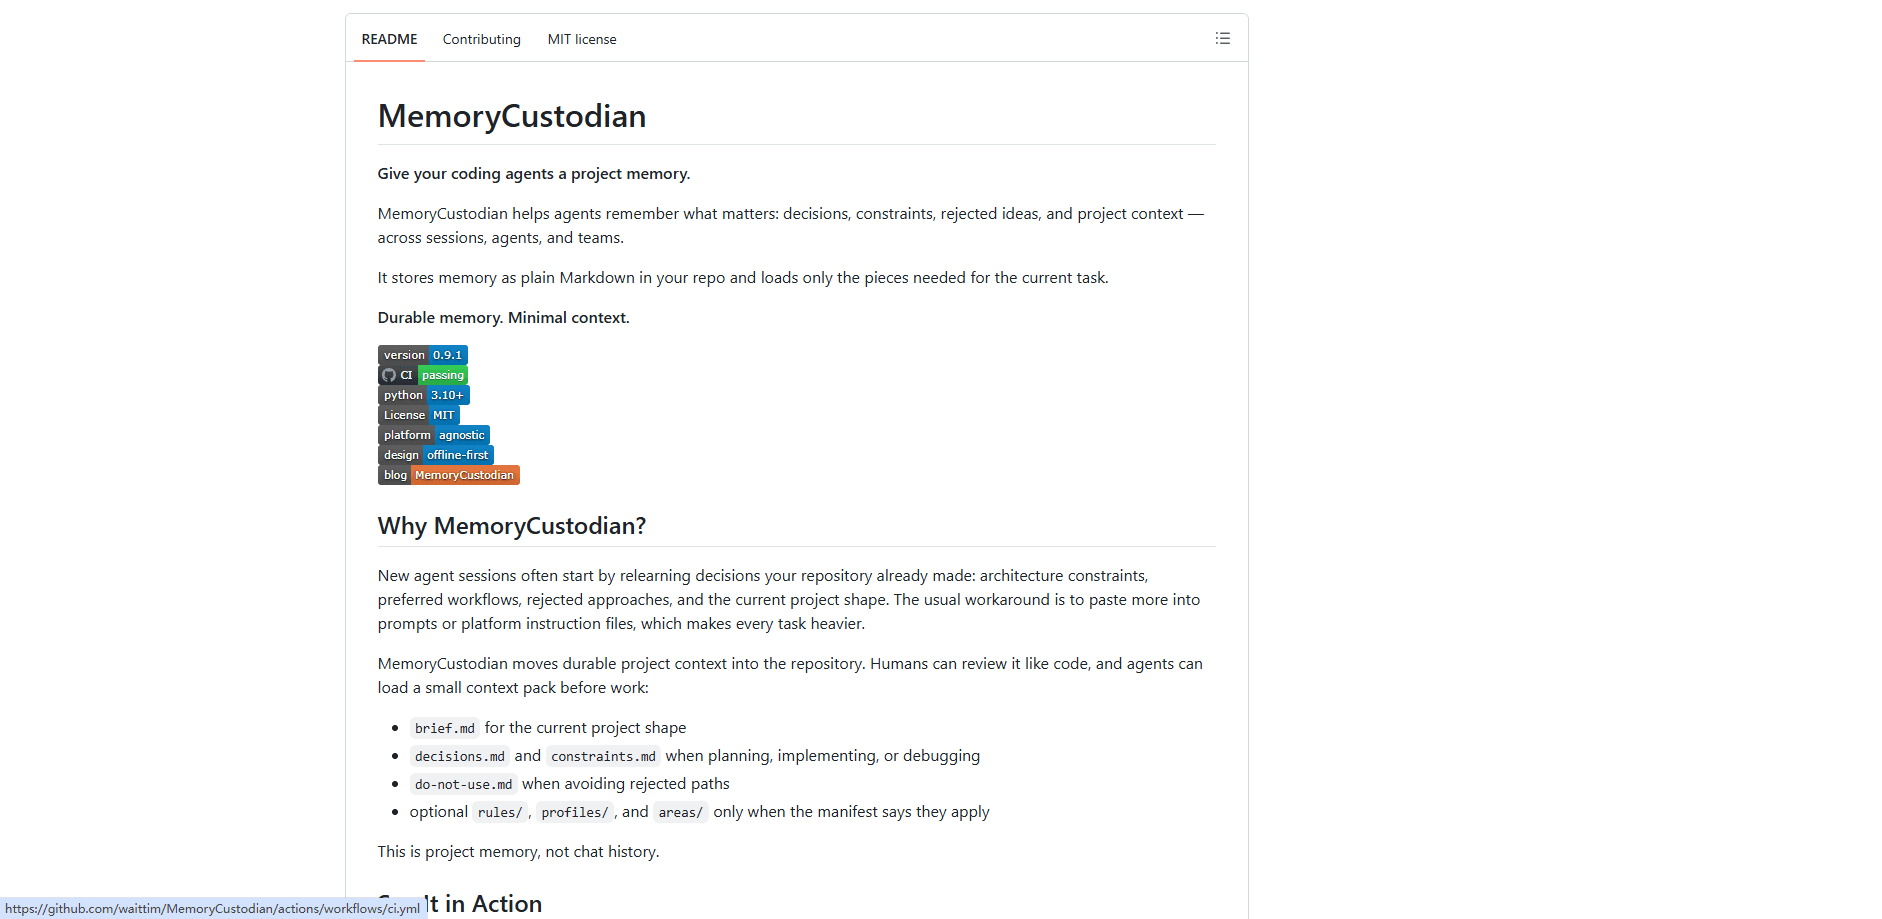
MemoryCustodian est un outil gratuit et open source qui donne aux agents de code une mémoire de projet durable. Il stocke les décisions, les contraintes et les idées écartées sous forme de fichiers Markdown simples dans votre dépôt, puis transmet à l'agent uniquement les éléments utiles à la tâche via un manifeste. Résultat : moins de remplissage dans les prompts et un travail plus régulier d'une session, d'un agent et d'un collègue à l'autre. Il est conçu pour la gestion du contexte des agents de code IA, pas pour les journaux de chat.
À propos de MemoryCustodian
Qu'est-ce que MemoryCustodian
MemoryCustodian est un outil de mémoire pour agents de code IA pensé pour celles et ceux qui travaillent avec Codex, Claude Code, Gemini ou n'importe quel agent basé sur un shell. Il convient aussi aux équipes qui partagent un même dépôt entre plusieurs hôtes d'agents et veulent une source unique de vérité. Le problème qu'il cible est précis : chaque nouvelle session d'agent tend à réapprendre des décisions que votre dépôt a déjà prises. Les contraintes d'architecture, les flux de travail préférés, les approches écartées et la forme actuelle du projet sont recollés dans les prompts, ce qui rend chaque tâche plus lourde que la précédente. Et pourquoi cela arrive-t-il ? Parce que la mémoire vit dans le chat, et que le chat est effacé.
La solution consiste à déplacer le contexte de projet durable dans le dépôt lui-même. MemoryCustodian garde ce contexte en Markdown simple sous docs/memory/, si bien que les humains peuvent le relire et le comparer comme du code. Avant une tâche, l'agent lit un petit paquet de contexte borné au lieu de tout l'historique. C'est le routage du contexte de l'agent en pratique. Il maintient l'usage des tokens bas et empêche l'agent d'inventer des règles que vous n'avez jamais acceptées.
Ce n'est pas un historique de chat. C'est de la mémoire de projet. Cette distinction compte, car la mémoire survit à une conversation effacée, à un changement de modèle ou à l'arrivée d'un nouveau collègue dans le dépôt. Le principal compromis : vous devez écrire les fichiers initiaux à la main. Un brief bâclé est signalé par les commandes intégrées de statut et de vérification.
Pour commencer
- Demandez à votre agent de code d'installer la skill MemoryCustodian depuis son dépôt GitHub, puis de l'initialiser.
- Ou lancez la CLI directement :
memory-custodian init --project-root /path/to/project --agent all(remplacezallparcodex,claudeougeminipour viser un seul hôte). - Passez en revue les fichiers générés dans
docs/memory/, en particulierbrief.md, et complétez les TODO à partir de la documentation faisant autorité de votre projet. - Enregistrez la mémoire durable au fil de votre travail avec
memory-custodian add, en étiquetant chaque entrée par un sujet et une preuve. - Lancez
memory-custodian statusetmemory-custodian checkpour confirmer que le protocole est sain avant de vous y fier.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de MemoryCustodian.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Les développeurs qui utilisent des agents de code au quotidien
- Les petites équipes qui partagent un dépôt
- Ceux qui alternent entre Codex, Claude Code et Gemini
Tâches
- Préserver les décisions d'architecture
- Suivre les approches écartées
- Intégrer une nouvelle session d'agent
Cas d'usage
- Reprendre un dépôt après une longue interruption
- Relire une pull request
- Faire tourner des agents en CI
Fonctionnalités clés
Mémoire Markdown native du dépôt
MemoryCustodian stocke toute la mémoire du projet en Markdown simple dans docs/memory/. Cela signifie qu'elle se relit, se compare, se valide et se restaure sans risque, exactement comme votre code source, ce qui est précisément l'intérêt quand la mémoire encode de vraies décisions d'ingénierie. Rien n'est enfermé dans une base de données propriétaire, et vos collègues peuvent relire les changements de mémoire dans les mêmes pull requests que le code.
Routage du contexte par manifeste
Au lieu de fourrer tout l'historique dans chaque prompt, l'outil lit d'abord manifest.md, puis brief.md, puis uniquement les fichiers que le manifeste désigne pour votre tâche. Le routage s'appuie sur des entrées explicites de tâche et de périmètre, sans devinette sémantique ni classement par LLM. Le routage du contexte de l'agent reste déterministe et prévisible. Vous obtenez un paquet de contexte borné qui correspond au travail en cours.
Types de tâches canoniques
La CLI embarque un ensemble fixe de catégories de tâches : general, planning, implementation, artifact, preferences, history et maintenance. Appeler read --task implementation tire la mémoire utile à l'écriture de code, tandis que d'autres tâches chargent une tranche différente selon le périmètre que vous passez. Un flag --strict-routing échoue en mode fermé face à un périmètre incomplet ou ambigu, plutôt que de deviner.
Écritures de mémoire prudentes
La mémoire active est adossée à des preuves. Les entrées reçoivent des identifiants stables comme MC-DEC-... et MC-SUBJ-..., et chaque écriture exige une confirmation de l'utilisateur ou une source du projet pour compter comme réelle. Les observations non confirmées de l'agent restent des candidates dans inbox.md jusqu'à ce qu'un humain les cautionne, ce qui tient les règles fantômes hors de votre mémoire de travail et loin de votre code.
Oubli, vérifications et maintenance
L'oubli se fait d'abord en aperçu et par périmètre : memory-custodian forget affiche un Plan ID que vous devez confirmer avant toute suppression. Cette étape d'aperçu compte, car les fichiers de mémoire sont partagés, donc une mauvaise suppression peut toucher l'agent de tout le monde d'un coup. Les commandes de maintenance comme compact maintiennent les fichiers dans le budget et archivent les entrées les plus anciennes sur demande. Des vérifications distinctes couvrent le routage, la fraîcheur, la vie privée, la sécurité et les conflits, y compris une relecture tenant compte des fusions Git par rapport à une branche de base.
CLI Python sans dépendances
Tout l'outil tourne sur la bibliothèque standard de Python. Aucune dépendance tierce à l'exécution. Il fonctionne hors ligne et n'a besoin ni de pipeline RAG ni de base de données vectorielle, ce qui évite la latence des embeddings et les récupérations hallucinées. L'installation se fait par un simple pip install éditable ou par un script wrapper fourni.
Avantages et inconvénients
Avantages
- Gratuit et open source sous licence MIT, sans palier payant ni limite d'usage.
- Fonctionne hors ligne, sans aucune dépendance tierce à l'exécution et sans base de données vectorielle.
- La mémoire vit dans votre dépôt en Markdown comparable, donc elle se relit et se restaure sans risque.
- Un seul ensemble de mémoire sert Codex, Claude Code, Gemini et les agents génériques de shell.
- Les écritures adossées à des preuves et les identifiants stables réduisent les règles fantômes et les écrasements accidentels.
- Léger en ressources : pas de serveur, pas de base de données, juste des fichiers Markdown dans votre dépôt.
Inconvénients
- C'est un outil de développeur visant les agents de code, donc les utilisateurs non techniques trouveront la CLI et les concepts du protocole lourds.
- Tirer de la valeur dépend de la curation du `brief.md` initial ; une configuration non curatée est signalée et la qualité du routage en pâtit.
- Le rappel de la mémoire est déterministe et fondé sur des règles, donc il ne résumera pas pour vous des conversations désordonnées.
Questions fréquentes
Il donne aux agents de code IA une mémoire de projet durable. Il stocke les décisions, les contraintes et les approches écartées dans votre dépôt et ne charge que les parties utiles à la tâche. Ainsi les agents cessent de réapprendre le même contexte à chaque session.
Contenus associés
Découvrez des outils, des compétences et des articles liés à MemoryCustodian.
Alternatives à MemoryCustodian
Forefront
Forefront · ProgrammationForefront est une plateforme web pour construire avec de l'IA open source. Elle vous laisse affiner les principaux modèles de langage open source sur vos propres données, évaluer leurs performances et les exécuter via une API ou les exporter pour les héberger vous-même. Les développeurs qui veulent le confort d'une plateforme fermée mais tiennent à rester propriétaires de leurs modèles et de leurs données sont le public visé ici.

Startkit
StartKit.AI · ProgrammationStartkit est un boilerplate pour créer des produits SaaS d'IA et des wrappers d'IA. Voyez-le comme un boilerplate de startup IA avec les parties ennuyeuses déjà branchées : authentification, paiements Stripe et Lemon Squeezy, limites d'usage, e-mail transactionnel et un kit de démarrage d'API IA qui parle à OpenAI, Anthropic, Groq ou Llama. Vous clonez le dépôt, fixez votre prix et attaquez la partie du produit pour laquelle les gens paient vraiment. Il repose sur Next.js au-dessus de React et Tailwind, donc une bonne partie du code boilerplate vous semble déjà familière.
Testim
Tricentis · ProgrammationTestim est une plateforme d'automatisation des tests dopée à l'IA, qui sert à créer et exécuter des tests de bout en bout sur des applications web, mobiles et Salesforce. Elle s'appuie sur l'apprentissage automatique pour garder les tests stables quand une interface change, alors les équipes passent moins de temps à réparer des sélecteurs cassés. Pas mal pour un outil de tests automatisés que vous pouvez utiliser dès aujourd'hui. Vous créez des tests en enregistrant des actions dans un navigateur, puis vous ajoutez du JavaScript quand vous avez besoin de plus de contrôle. C'est un choix solide pour une équipe QA bien occupée.