
Middleware Observability Platform
Middleware · Programmation
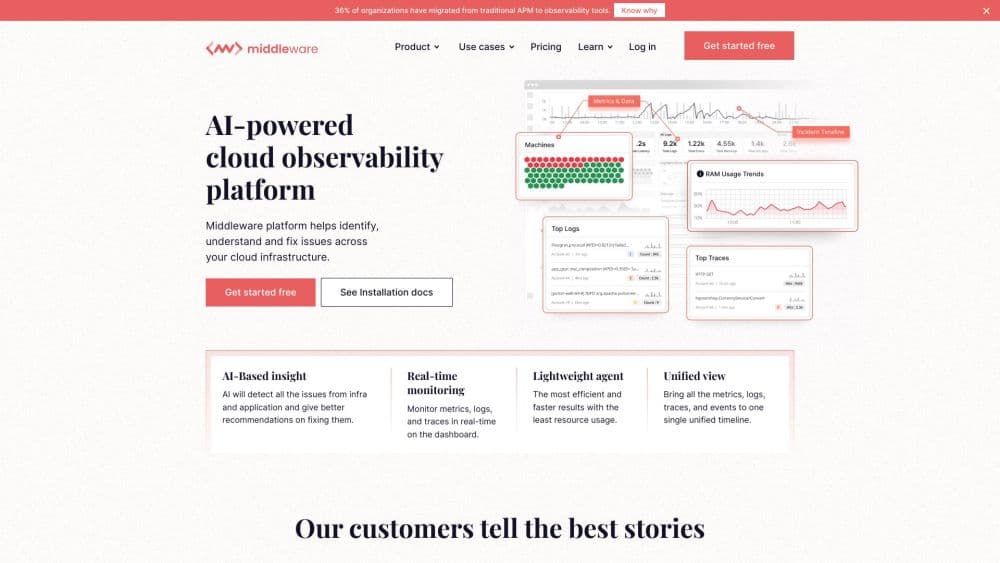
Middleware est une plateforme d'observabilité cloud qui rassemble journaux, métriques, traces et sessions d'utilisateurs réels sur une seule chronologie, puis s'appuie sur un agent d'IA pour trouver la cause d'un incident et proposer un correctif.
À propos de Middleware Observability Platform
About
Qu'est-ce que Middleware
Middleware Observability Platform est un service de supervision destiné aux équipes qui font tourner des applications sur Kubernetes, sur des machines virtuelles et sur des bases de données managées. Plutôt que d'acheter séparément un outil de métriques, un outil de journaux et un outil de supervision applicative, vous installez un agent et vous voyez le tout sur le même écran. Cette chronologie unique change tout au moment où ça casse : un appel d'API lent, une ligne de journal en erreur et la réécriture d'une session se retrouvent côte à côte, reliés par le même contexte de requête.
L'entreprise derrière la plateforme est Middleware, fondée en 2022 par des ingénieurs passés par Netflix, DigitalOcean, Google et Cisco. La collecte repose sur des agents installés sur les serveurs, des SDK par langage et des intégrations tierces, et la plateforme parle OpenTelemetry : vos collecteurs et vos agents existants peuvent donc l'alimenter sans migration. La facturation suit la consommation, et l'argument n'est pas un catalogue pléthorique pour service achats, mais le coût total.
Mieux vaut connaître les limites dès le départ. Il s'agit d'un service hébergé, donc les données quittent votre réseau sauf si vous payez l'option apportez votre propre cloud. Les processus de conformité poussés et les durées de rétention longues relèvent du contrat sur mesure. L'agent d'IA est arrivé après la supervision de base, et une équipe avec un contrôle des changements strict voudra examiner la fonction de pull request automatique avant de l'activer.
Premiers pas
- Créez votre compte sur app.middleware.io et connectez-vous avec Google, GitHub, un e-mail, Okta SSO ou Microsoft Entra ID.
- Ouvrez la page d'installation et copiez les valeurs MW_API_KEY et MW_TARGET de votre projet.
- Choisissez votre environnement : un DaemonSet Kubernetes, un agent pour Linux, un SDK Java, Python, Node.js ou autre, ou une intégration AWS, Azure, Prometheus ou Datadog.
- Déployez l'agent, puis vérifiez que les données arrivent dans le tableau de bord en quelques minutes.
- Construisez vos vues et vos alertes sur les signaux qui comptent pour votre équipe, puis activez la détection OpsAI pour attraper les anomalies qui échappent à vos règles.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Middleware Observability Platform.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Équipes DevOps et SRE
- Startups au budget serré
- Développeurs qui travaillent sur des fonctions de LLM
Tâches
- Identifier la cause d'un point d'accès lent
- Garder un cluster Kubernetes en bonne santé
- Surveiller les requêtes vers les bases de données
- Vérifier qu'une API répond depuis l'extérieur
Cas d'usage
- Un incident de production à deux heures du matin
- Le pic de trafic de la semaine de lancement
- La revue mensuelle des coûts
Fonctionnalités clés
Agent OpsAI pour la détection et la correction
OpsAI surveille en même temps les applications, l'infrastructure, les bases de données, les conteneurs, les journaux et les projets de LLM, puis croise ce qu'il trouve entre ces signaux. L'intérêt commence après l'alerte : il désigne une cause probable et propose un correctif, et il peut ouvrir un pull request avec la modification. La détection d'erreurs ne coûte rien et l'analyse de cause racine est facturée au token, donc vous pouvez garder les alertes actives même si vous ne voulez pas d'IA sur chaque incident.
Supervision des performances applicatives
Le module APM enregistre les traces en temps réel et suit une requête depuis le point d'accès de l'API jusqu'aux bases de données qu'elle touche. Le profilage continu montre quelle fonction brûle du processeur, ce qui répond à une autre question qu'une trace lente : la trace dit où le temps est passé, le profil dit quel code l'a dépensé. Les cartes de trafic et les vues de dépendances servent à expliquer une panne à qui n'est pas ingénieur.
Gestion des journaux avec QueryGenie
Les journaux arrivent depuis n'importe quelle source JSON, sans reformater la sortie avant l'envoi. Vous cherchez par attribut, en correspondance approximative ou par expression régulière, et vous mettez la vue en direct en pause pendant un déploiement. QueryGenie traduit une demande en langage naturel en requête, ce qui aide ceux qui n'écrivent pas de requête structurée tous les jours. Le masquage des données sensibles et l'extraction d'attributs propres se font avant le stockage, un point qui compte si vos journaux contiennent des données clients.
Supervision de l'infrastructure et de Kubernetes
L'instrumentation automatique couvre les serveurs, les clusters Kubernetes, les nœuds Linux et les services cloud sans script par machine. Santé du cluster, CRD et politiques réseau s'affichent dans une seule vue, avec un détail de niveau ECS pour les charges conteneurisées. Relier un pic de processeur à la latence qu'il a provoquée est le parcours pour lequel le produit a été conçu, et c'est la partie que les équipes remarquent en premier.
Supervision des utilisateurs réels et lecture de sessions
La supervision des utilisateurs réels capture ce que vivent réellement les visiteurs du site ou de l'app mobile, puis relie un chargement lent à la trace backend qui l'a causé. La lecture de sessions vous laisse regarder la session à côté des données réseau au lieu de demander à un utilisateur de décrire ce qu'il a vu. Les contrôles de confidentialité anonymisent les champs et limitent ce qui est capturé, ce qui rend la fonction utilisable dans des produits qui manipulent des données personnelles.
Tests synthétiques et tests navigateur
Les tests synthétiques lancent des requêtes HTTP, UDP, DNS et WebSocket depuis plusieurs localisations selon un planning, avec le détail complet de la requête et de la réponse. Les tests navigateur rejouent un parcours utilisateur, comme se connecter puis payer, sur plusieurs navigateurs et profils d'appareils. Ensemble, ils couvrent ce que la supervision côté serveur ne voit pas : si le service est joignable et utilisable depuis l'extérieur.
Observabilité des bases de données et des LLM
La supervision des bases de données descend au détail de chaque requête sur MySQL, PostgreSQL, MongoDB, Cassandra et Aurora, et suit processeur, mémoire, disque et débit à côté des requêtes elles-mêmes. Le module LLM mesure latence, consommation de tokens, coût, qualité de réponse et erreurs sur les prompts, les agents et les flux à plusieurs étapes, puis relie un appel IA coûteux ou en échec à la trace et à la session qui l'ont produit.
Avantages et inconvénients
Avantages
- Un agent et un écran pour les journaux, les métriques, les traces, l'infrastructure, les utilisateurs réels, les tests synthétiques et les données LLM, ce qui évite de changer d'outil au milieu d'un incident.
- La collecte fondée sur OpenTelemetry permet à vos collecteurs, agents Datadog et configurations Prometheus d'alimenter la plateforme sans démonter ce qui tourne déjà.
- Le tarif à l'usage démarre par une offre gratuite avec 100 Go de données et un nombre d'utilisateurs illimité, donc la facture suit la télémétrie et non les effectifs.
- Le pipeline de données permet d'écarter les sources de journaux bruyantes avant stockage, ce qui maîtrise à la fois la dépense et les résultats de recherche.
- La détection d'erreurs d'OpsAI est gratuite et ses changements de code passent par un pull request, le relecteur garde donc la main.
Inconvénients
- C'est une plateforme hébergée, donc les données quittent votre réseau sauf si vous payez l'option apportez votre propre cloud sur un contrat sur mesure.
- L'offre gratuite conserve 14 jours de données et le plan à l'usage prévoit 30 jours par défaut, une fenêtre courte pour qui doit remonter un an en arrière après un audit.
- La correction automatique et les suggestions de code présentent un vrai risque en environnement réglementé, et beaucoup d'équipes les laisseront désactivées au début.
- L'observabilité des LLM est plus récente que l'APM et les journaux, attendez-vous donc à moins d'intégrations poussées que chez les concurrents les plus anciens.
Questions fréquentes
Middleware supervise l'infrastructure, les conteneurs, Kubernetes, les traces applicatives, les journaux, les bases de données, les sessions d'utilisateurs réels, les tests synthétiques et les applications de LLM. Tout atterrit sur une chronologie reliée par le contexte de la requête, et vous passez donc de la plainte d'un utilisateur à la requête précise qui l'a provoquée.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Middleware Observability Platform.
Alternatives à Middleware Observability Platform
Forefront
Forefront · ProgrammationForefront est une plateforme web pour construire avec de l'IA open source. Elle vous laisse affiner les principaux modèles de langage open source sur vos propres données, évaluer leurs performances et les exécuter via une API ou les exporter pour les héberger vous-même. Les développeurs qui veulent le confort d'une plateforme fermée mais tiennent à rester propriétaires de leurs modèles et de leurs données sont le public visé ici.

Startkit
StartKit.AI · ProgrammationStartkit est un boilerplate pour créer des produits SaaS d'IA et des wrappers d'IA. Voyez-le comme un boilerplate de startup IA avec les parties ennuyeuses déjà branchées : authentification, paiements Stripe et Lemon Squeezy, limites d'usage, e-mail transactionnel et un kit de démarrage d'API IA qui parle à OpenAI, Anthropic, Groq ou Llama. Vous clonez le dépôt, fixez votre prix et attaquez la partie du produit pour laquelle les gens paient vraiment. Il repose sur Next.js au-dessus de React et Tailwind, donc une bonne partie du code boilerplate vous semble déjà familière.
Testim
Tricentis · ProgrammationTestim est une plateforme d'automatisation des tests dopée à l'IA, qui sert à créer et exécuter des tests de bout en bout sur des applications web, mobiles et Salesforce. Elle s'appuie sur l'apprentissage automatique pour garder les tests stables quand une interface change, alors les équipes passent moins de temps à réparer des sélecteurs cassés. Pas mal pour un outil de tests automatisés que vous pouvez utiliser dès aujourd'hui. Vous créez des tests en enregistrant des actions dans un navigateur, puis vous ajoutez du JavaScript quand vous avez besoin de plus de contrôle. C'est un choix solide pour une équipe QA bien occupée.