
MyScale
MOQI SINGAPORE PTE. LTD. · Programmation
MyScale est une base de données vectorielle SQL basée sur ClickHouse. Elle réunit recherche vectorielle, recherche textuelle et analyse dans un moteur qu'on interroge en SQL, pratique pour le RAG et les applis d'IA.
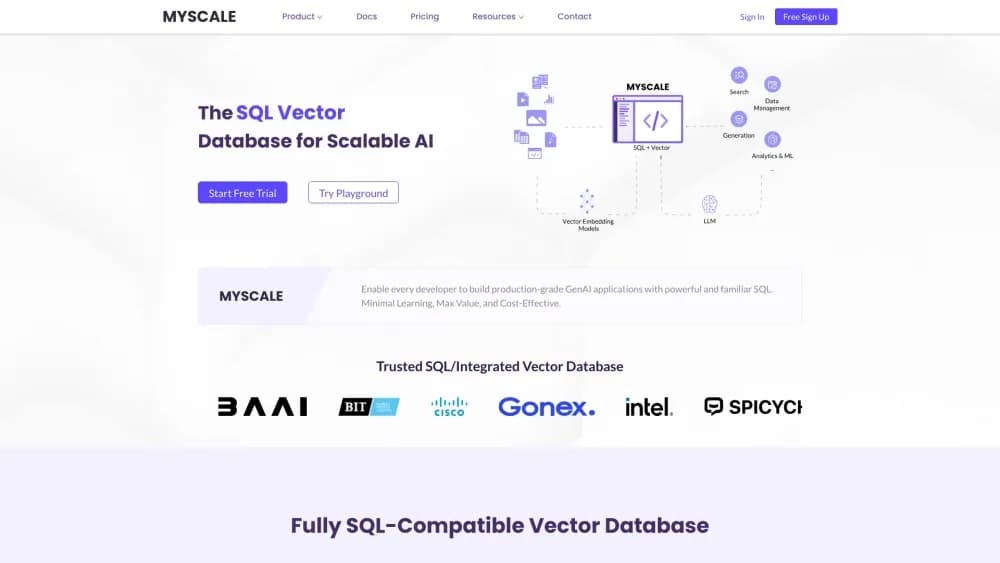
À propos de MyScale
What Is MyScale
MyScale est une base de données cloud pensée pour les applications d'IA, et elle repose sur le moteur open source ClickHouse. Le principe est simple : vous rangez données structurées, vecteurs et texte dans un seul système, puis vous interrogez le tout avec le SQL que vous connaissez déjà. Son moteur, appelé MSTG, est réglé pour la recherche vectorielle à l'échelle du milliard, et l'entreprise affirme qu'il dépasse les bases vectorielles dédiées de 4x à 10x en vitesse comme en coût. Ce chiffre vient de son propre benchmark, donc vérifiez-le avec vos vecteurs avant de le prendre pour argent comptant.
Le problème qu'elle résout, c'est la multiplication des outils. Une pile RAG classique colle un stockage vectoriel à une base relationnelle et à un moteur de recherche, puis vous maintenez trois systèmes et trois langages de requête. MyScale les réunit en un seul, si bien qu'une requête peut filtrer sur les métadonnées et trier par similarité vectorielle en même temps. Le développeur garde ses réflexes SQL au lieu d'apprendre une API vectorielle maison.
La contrepartie, c'est que MyScaleDB est jeune et plus étroite que ClickHouse lui-même. Elle dérive de ClickHouse et modifie le moteur de stockage et d'exécution pour le travail vectoriel, donc elle peut prendre du retard sur la version d'origine. Une version open source est hébergeable vous-même sous Apache 2.0, mais l'expérience soignée, moteur MSTG compris, passe par MyScale Cloud.
Getting Started
- Inscrivez-vous sur myscale.com et lancez un cluster depuis la page Clusters.
- Récupérez l'hôte, l'utilisateur et le mot de passe dans Connection Details, puis connectez-vous avec le client Python, Node.js, Go, JDBC ou HTTPS.
- Créez une table, insérez vos lignes et ajoutez un index vectoriel à la colonne de vecteurs avec une métrique comme cosine.
- Lancez une recherche vectorielle en SQL, avec ORDER BY distance et LIMIT, ou filtrez d'abord les lignes avec WHERE.
- Branchez-la à votre pile via les intégrations OpenAI, LangChain ou LlamaIndex, puis publiez.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de MyScale.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs backend et IA
- Créateurs de RAG
- Équipes data
Tâches
- Alimenter la récupération en RAG
- Recherche hybride
- Recherche vectorielle filtrée
- Ajouter une recherche sémantique à une appli
Cas d'usage
- Une équipe qui lance sa première fonction RAG
- Une startup qui remplace une pile multi-bases
- Une appli d'IA dont les données grossissent
Fonctionnalités clés
Requêtes vectorielles en SQL
MyScale traite la recherche vectorielle comme une opération SQL. Vous ajoutez un index vectoriel à une colonne, puis vous triez les lignes avec une fonction de distance dans ORDER BY, mêlée sans souci à WHERE, JOIN et GROUP BY. Si vous connaissez le SQL, vous savez déjà interroger ici une base de données vectorielle.
Moteur vectoriel MSTG
Le moteur MSTG est l'algorithme d'indexation maison de MyScale, et il s'appuie sur des SSD NVMe pour ranger plus de données par nœud. L'entreprise dit qu'il atteint environ 10x la densité de données des configurations standard et dépasse les bases vectorielles spécialisées en coût. C'est son benchmark, donc testez-le sur vos propres vecteurs avant de trancher.
Recherche textuelle et hybride
À côté des vecteurs, MyScale fournit un index plein texte BM25 avec des tokenizers configurables selon les langues. Vous lancez la recherche textuelle seule ou la mêlez aux résultats vectoriels dans une requête hybride. Pour le RAG, ce mélange ramène souvent de meilleurs passages que l'une ou l'autre méthode seule.
Recherche filtrée à tout ratio
La recherche filtrée est le point faible de beaucoup de bases vectorielles. MyScale applique d'abord le filtre sur les métadonnées, puis cherche dans les lignes restantes, donc la précision tient même quand un filtre ne garde qu'une infime tranche d'une table d'un milliard de lignes. En pratique, c'est la différence entre un résultat propre et un résultat lent et flou.
Gestion de données unifiée
Le stockage ne se limite pas aux vecteurs. MyScale gère colonnes structurées, JSON, texte, données géospatiales et séries temporelles dans la même table. Un produit, son embedding et son historique de ventes cohabitent, donc une seule requête peut joindre des fonctions d'IA et des données métier.
Intégrations et clients
MyScale se connecte à OpenAI, LangChain, LangChain JS/TS et LlamaIndex, et livre des clients Python, Node.js, Go et JDBC plus une interface HTTPS. La plupart des équipes la branchent sur un pipeline existant plutôt que de repartir de zéro, ce qui garde la migration courte.
MyScale Telemetry
Telemetry apporte une observabilité pour les systèmes LLM, donc vous tracez prompts, réponses et étapes de récupération au même endroit. Déboguer un pipeline RAG sans cela revient à deviner d'où vient une mauvaise réponse ; avec cela, vous voyez la récupération qui a nourri le modèle.
Sécurité et contrôle d'accès
MyScale propose un contrôle d'accès basé sur les rôles en SQL et déclare une conformité SOC 2 et ISO 27001. Pour les équipes qui traitent des données sensibles, cela ouvre une voie pour accorder un accès limité sans exposer tout le cluster.
Avantages et inconvénients
Avantages
- Comme elle est entièrement compatible SQL, une personne qui connaît le SQL lance une recherche vectorielle sans apprendre une API maison ni un nouveau langage de requête.
- Recherche vectorielle, recherche textuelle et analyse partagent un moteur, ce qui supprime les services en plus qu'exige une pile RAG classique.
- Le moteur MSTG vise des vecteurs à l'échelle du milliard sur disque, donc les grosses collections n'ont pas à tenir entièrement en mémoire.
- La recherche filtrée applique les filtres sur les métadonnées avant de trier, ce qui garde la précision sur les requêtes sélectives.
- Le pod gratuit pour 5M vecteurs 768D et les intégrations OpenAI, LangChain et LlamaIndex rendent le test rapide.
Inconvénients
- Les chiffres de performance et de coût de 4x à 10x viennent du benchmark de l'entreprise elle-même, donc il vaut mieux les reproduire sur vos données avant de vous y fier.
- Comme elle dérive de ClickHouse, MyScaleDB peut prendre du retard sur le moteur d'origine et sur son éventail de fonctions, ce qui compte si vous voulez le dernier cri de ClickHouse.
- Les fonctions les plus fortes, moteur MSTG inclus, vivent dans MyScale Cloud, donc héberger vous-même la version open source laisse un produit moins complet.
- Il n'y a pas d'appli mobile ou de bureau large, donc elle sert au travail serveur et aux pipelines plutôt qu'aux outils grand public.
Questions fréquentes
MyScale stocke et interroge les données derrière les applis d'IA, surtout pour la récupération dans les systèmes RAG et la recherche sémantique. Vous gardez vecteurs, texte et lignes structurées ensemble, puis vous les interrogez en SQL.
Contenus associés
Découvrez des outils, des compétences et des articles liés à MyScale.
Alternatives à MyScale

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.