
OctoAI
OctoAI (formerly OctoML, now part of NVIDIA) · Programmation
OctoAI était une API d'inférence IA cloud qui servait des modèles ouverts comme Llama, Mistral et Stable Diffusion via une API compatible OpenAI. NVIDIA l'a rachetée en 2024.
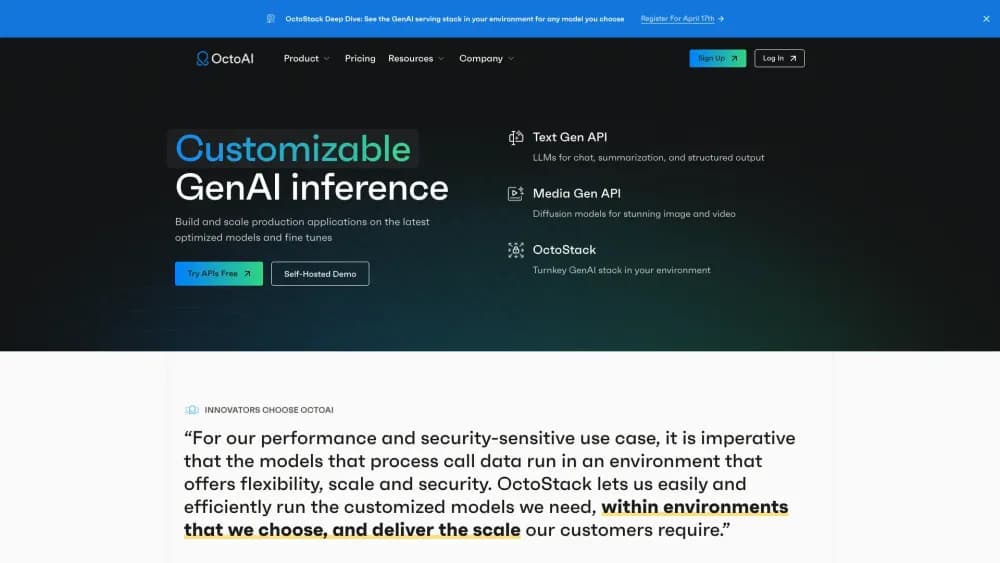
À propos de OctoAI
About
Qu'était OctoAI
OctoAI était une entreprise de Seattle qui vendait un accès rapide et bon marché à des modèles d'intelligence artificielle open source. Il suffisait d'envoyer une requête à son API, de choisir un modèle dans le catalogue et de recevoir du texte ou une image. L'argument, c'était la vitesse : chaque modèle était réglé pour tirer davantage d'une même GPU, si bien que les réponses arrivaient plus vite et coûtaient moins cher qu'un déploiement cloud classique.
L'équipe est venue aux modèles par les compilateurs, pas par les chatbots. OctoAI a démarré en 2019 sous le nom d'OctoML, une spin-off de l'université de Washington bâtie autour d'Apache TVM, un compilateur libre qui réécrit un modèle pour qu'il tourne correctement sur le processeur dont vous disposez. Ce travail a ensuite pris la forme d'un hébergement de modèles open source destiné aux développeurs d'applications qui voulaient Llama ou Stable Diffusion dans un produit sans recruter une équipe d'infrastructure machine learning.
Ce service n'existe plus. NVIDIA a racheté OctoAI en septembre 2024 et l'entreprise a prévenu ses clients que l'accès à tous ses services s'arrêterait le 31 octobre 2024. Les comptes ont été désactivés et l'API s'est éteinte. L'équipe est passée au pôle logiciel de NVIDIA. Qui cherche OctoAI aujourd'hui tombe sur un chapitre clos, et la vraie question est de savoir ce qui a pris sa place.
Pour démarrer
Il ne reste plus d'inscription à faire, la plateforme étant retirée. Ce qui suit décrit son fonctionnement quand elle était en service, utile si vous lisez d'anciens tutoriels ou préparez une migration.
- Créez un compte sur la plateforme OctoAI et générez un jeton d'API depuis la console.
- Choisissez un modèle du catalogue, comme Llama, Mistral ou Stable Diffusion XL, ou téléversez un modèle que vous avez vous-même affiné.
- Faites pointer votre code vers le point de terminaison compatible OpenAI, qui permettait de réutiliser presque n'importe quelle bibliothèque cliente en changeant l'URL de base.
- Envoyez une requête et lisez la réponse, qu'il s'agisse de texte généré, d'une image ou d'un JSON.
- Pour un déploiement privé, exécutez OctoStack dans votre propre compte cloud ou sur vos serveurs, afin que le trafic ne passe pas par une infrastructure partagée.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de OctoAI.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs qui construisent sur des modèles ouverts
- Équipes qui quittent OctoAI
- Entreprises de secteurs régulés
Tâches
- Servir de la génération de texte à l'échelle de la production
- Générer des images avec Stable Diffusion XL
- Héberger un modèle affiné
- Auditer une dépendance ancienne
Cas d'usage
- Un prototype qui reposait sur OctoAI
- Une revue de fournisseurs d'inférence
- Lire un tutoriel de 2024
Fonctionnalités clés
Génération de texte compatible OpenAI
OctoAI servait Llama 2 en tailles 7B, 13B et 70B, avec les variantes conversationnelles, Code Llama et Mistral 7B. L'API suivait le format de requête d'OpenAI, de sorte qu'une équipe déjà habituée à ce standard changeait de fournisseur en modifiant l'URL de base. Cette compatibilité ramenait l'essai d'un nouvel hébergeur à quelques lignes de configuration.
API d'images avec Stable Diffusion XL
Le volet image faisait tourner Stable Diffusion XL et permettait d'ajouter vos propres adaptateurs LoRA directement dans l'appel. Un studio de jeux ou une équipe marketing produisait des visuels au style maison sans entraîner un modèle de base. Les requêtes renvoyaient l'image finie, et non un numéro de file à interroger ensuite.
Optimisation indépendante du matériel
L'avantage de l'entreprise venait d'Apache TVM, un compilateur qui traduit un modèle en code réglé pour une puce précise. OctoAI appliquait ce réglage sur ses propres serveurs, si bien que le gain apparaissait dans le temps de réponse de l'API et non dans un paquet à installer. La prise en charge couvrait les GPU NVIDIA, le matériel AMD, les processeurs Intel et les puces Inferentia d'AWS. Cette portabilité a perdu de son poids quand le marché s'est concentré sur NVIDIA.
OctoStack pour le déploiement privé
Lancé en avril 2024, OctoStack laissait les entreprises exécuter la même pile d'inférence dans leur propre environnement, que ce soit AWS, Google Cloud, Azure, CoreWeave, Lambda Labs ou leur propre centre de données. L'argument tenait à la confidentialité et au contrôle : les équipes de la santé, de la finance et du secteur public utilisaient les modèles sans envoyer de données vers les serveurs d'OctoAI. La société annonçait une utilisation des GPU quatre fois meilleure et 50 % de coûts d'exploitation en moins par rapport à un montage artisanal.
Apportez votre propre modèle
Au-delà du catalogue, il était possible d'héberger une variante affinée de Llama 2 sur la plateforme et de l'appeler comme n'importe quel autre point de terminaison. Cela évitait de construire une couche de service pour un modèle personnalisé, encore fallait-il produire et tester l'affinage ailleurs.
Tarification à l'usage
OctoAI facturait à la consommation, sans abonnement fixe, avec un palier d'essai gratuit, un tarif par jeton pour le texte, par image pour SDXL et par heure de calcul pour les points de terminaison personnalisés. L'économie la plus nette venait des modèles réglés, que la société annonçait jusqu'à dix fois plus rapides qu'un déploiement non optimisé.
Avantages et inconvénients
Avantages
- L'API parlait le format d'OpenAI, donc déplacer une application existante revenait à changer l'URL de base et la clé
- Les modèles réglés répondaient plus vite et coûtaient moins par jeton qu'un déploiement brut sur GPU cloud
- Les adaptateurs LoRA personnels donnaient à la génération d'images un style de marque cohérent sans entraîner un modèle
- OctoStack offrait aux secteurs régulés un moyen de garder les données dans leur propre compte cloud
- Un palier d'essai gratuit permettait de mesurer latence et qualité avant d'engager un budget
Inconvénients
- Toute la plateforme s'est arrêtée le 31 octobre 2024, environ cinq semaines après l'annonce du rachat par NVIDIA
- Aucun produit NVIDIA n'a repris cette charge, les clients ont donc dû reconstruire leur application sur un service d'inférence concurrent
- La couverture des modèles traînait derrière les concurrents les plus réactifs, et les nouvelles sorties ouvertes restaient des semaines ou des mois chez les rivaux
- L'argument d'indépendance au matériel a perdu sa valeur à mesure que le marché se concentrait sur les GPU NVIDIA, ce qui a réduit la raison de choisir OctoAI
- Le prix des points de terminaison personnalisés était plus difficile à prévoir qu'un tarif fixe par jeton, ce qui compliquait la budgétisation des équipes à trafic irrégulier
Questions fréquentes
NVIDIA a racheté OctoAI en septembre 2024 et l'entreprise a fermé tous ses services commerciaux le 31 octobre 2024. L'équipe, dirigée par le PDG Luis Ceze, a rejoint NVIDIA, et l'API comme la plateforme n'acceptent plus de trafic.
Contenus associés
Découvrez des outils, des compétences et des articles liés à OctoAI.
Alternatives à OctoAI

Udon
Udon · Programmation · ProductivitéUdon transforme un Mac Apple Silicon en serveur personnel piloté depuis le navigateur, avec conteneurs, partages de fichiers et un administrateur système IA en option.

offstage
offstage cloud · Programmation · Productivitéoffstage confie aux agents IA et aux jobs de CI un vrai Mac : un compte macOS 27 sur Apple silicon, piloté par API et facturé à la seconde.

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · Programmation · ProductivitéBotBus permet de contrôler des agents IA depuis son téléphone ou sa montre, même quand ils tournent sur l’ordinateur resté au bureau : vous validez les commandes, lancez des tâches et lisez les résultats.