

OpenAI WebSocket Mode for Responses API
OpenAI · Programmation
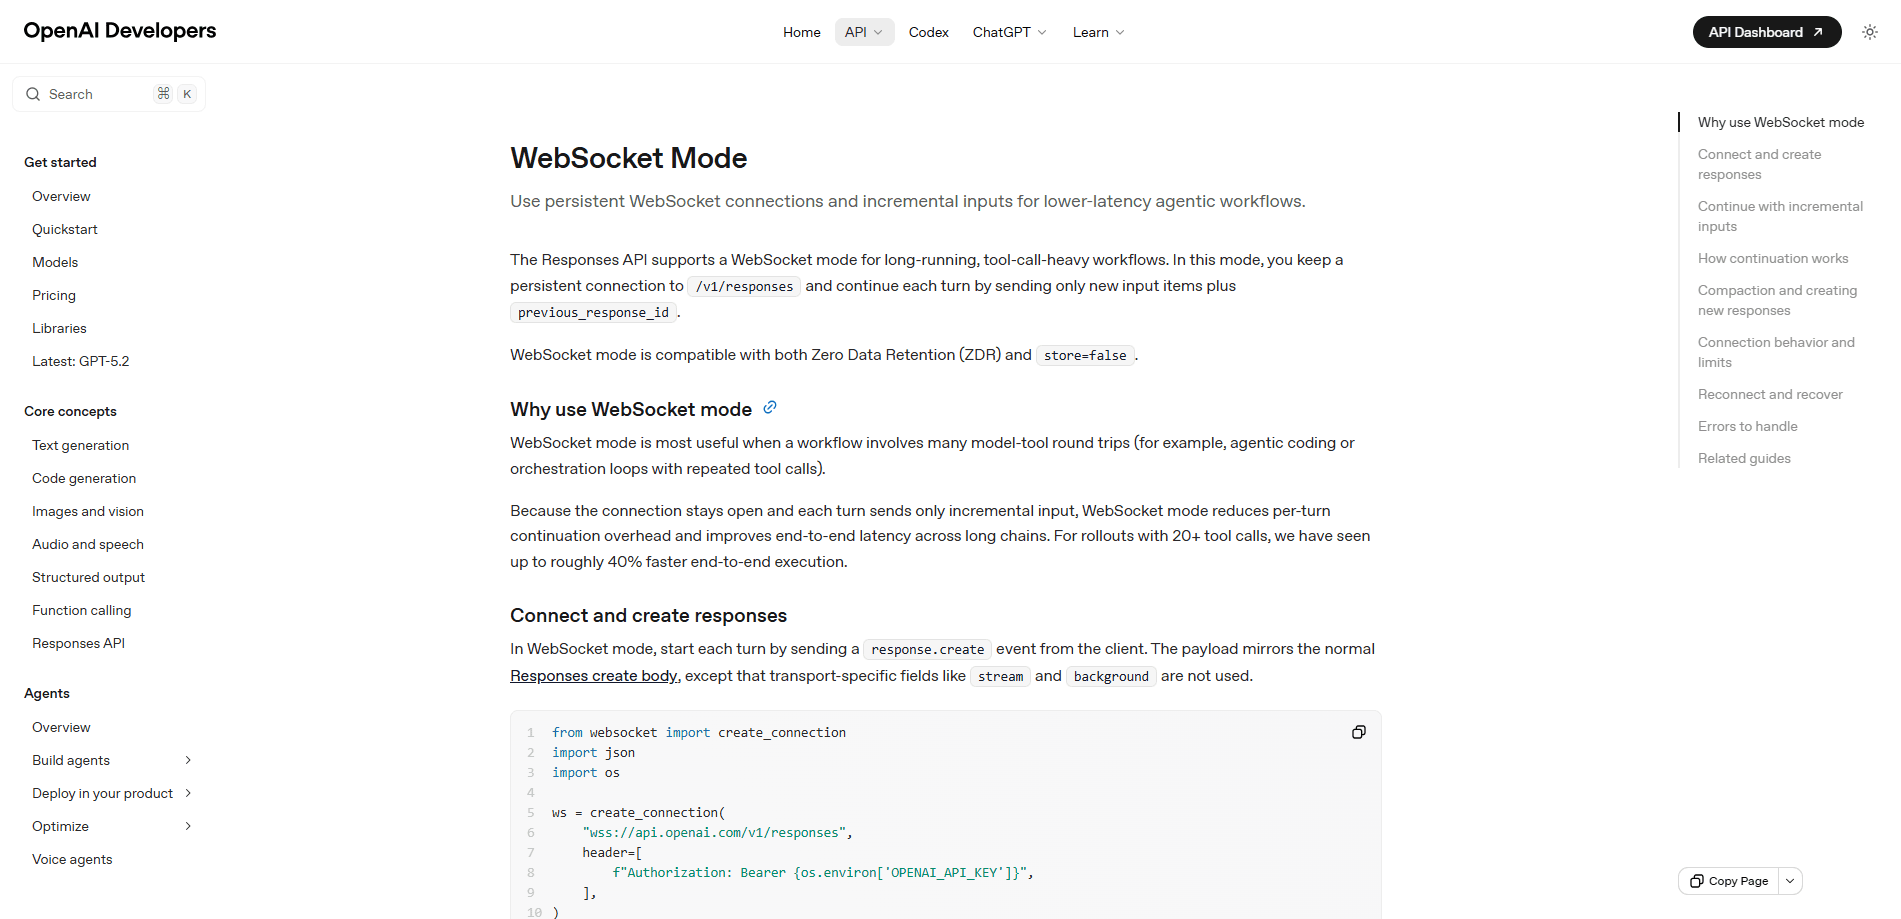
Le mode WebSocket d'OpenAI pour l'API Responses est un mode de connexion persistante qui vous permet d'exécuter de longs workflows d'agents chargés en outils sur un seul WebSocket au lieu de requêtes HTTP répétées. Vous ouvrez une connexion au point d'accès Responses et gardez chaque tour léger en n'envoyant que les nouveaux éléments d'entrée plus un previous_response_id. Il est conçu pour les boucles de codage agentique et d'orchestration où la même tâche déclenche des dizaines d'appels d'outils, et il fonctionne avec store=false dans les environnements sensibles à la vie privée.
À propos de OpenAI WebSocket Mode for Responses API
Qu'est-ce que le mode WebSocket d'OpenAI pour l'API Responses
Le mode WebSocket d'OpenAI est une option de transport pour l'API Responses, pas un produit à part. L'API Responses est la primitive à état d'OpenAI pour construire des applications de type agent, et c'est le point d'accès sur lequel démarrent la plupart des nouveaux projets. Ce qui change, c'est le tuyau en dessous. C'est tout. Le reste, vos prompts et vos outils, reste identique.
Le problème qu'il résout, c'est la surcharge de continuation. En mode HTTP standard, chaque tour rouvre une connexion, et vous renvoyez le contexte qui ne cesse de grossir. Cela fonctionne bien pour une question unique. Pour un agent qui appelle des outils vingt ou trente fois d'affilée, tous ces allers-retours s'accumulent. Le mode WebSocket garde la connexion ouverte vers le point d'accès Responses et laisse chaque suite n'envoyer que le delta, enchaîné via un previous_response_id. Rien de sorcier. Juste un meilleur tuyau.
La plus grosse limite, c'est la portée. Ce mode vise les workflows longs et chargés en outils, pas tout. Les recommandations d'OpenAI indiquent que les requêtes uniques et les conversations courtes doivent rester sur l'API Responses en HTTP standard, où l'optimisation apporte peu. La connexion a aussi une limite de temps, donc vous devrez gérer les reconnexions lors d'une longue exécution. Un peu pénible, mais gérable.
Premiers pas
- Obtenez une clé d'API OpenAI et installez un client WebSocket comme le paquet websocket-client pour Python.
- Ouvrez un socket vers le point d'accès WebSocket de Responses et passez votre clé dans l'en-tête Authorization.
- Envoyez votre premier tour avec un événement response.create, en incluant le modèle, les outils et l'entrée initiale.
- Poursuivez la conversation en envoyant un nouveau response.create qui référence le previous_response_id du tour précédent et n'inclut que les nouveaux éléments d'entrée, comme function_call_output.
- Lisez les événements du serveur au fil de leur arrivée en streaming, puis fermez le socket ou reconnectez-vous si vous atteignez la limite de temps de la connexion.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de OpenAI WebSocket Mode for Responses API.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Ingénieurs backend et IA qui construisent des agents ayant besoin de boucles d'outils à faible latence, car le mode cible le trafic serveur à serveur.
- Équipes plateforme qui font tourner des charges d'orchestration où la même tâche appelle des outils des dizaines de fois par déploiement.
- Développeurs soumis à des contraintes de confidentialité qui ont besoin d'un transport compatible avec store=false et la rétention zéro des données.
Tâches
- Codage agentique
- Traitement des appels d'outils
- Orchestration multi-tours
Cas d'usage
- Un agent de code qui enchaîne analyse de fichiers, génération de patchs et exécution de tests sur un socket actif.
- Un service backend qui coordonne plusieurs appels d'outils par requête utilisateur, où la latence par tour compte.
- Une équipe qui veut réduire la surcharge sur un trafic d'agents à fort volume sans changer son modèle ni ses prompts.
Fonctionnalités clés
Connexion persistante au point d'accès Responses
Le mode WebSocket garde une connexion ouverte vers l'API Responses pendant de nombreux tours. Vous le pilotez avec des événements response.create, et le premier démarre un nouveau tour comme une requête normale. Comme le socket reste ouvert, vous évitez la configuration de connexion que l'API de streaming standard paie à chaque tour. Cette surcharge est faible une fois. Sur une longue exécution d'agent, elle ne l'est plus.
Entrée incrémentale avec previous_response_id
Chaque tour de suite n'envoie que les nouveaux éléments d'entrée, plus un previous_response_id qui renvoie au tour précédent. Vous ne réexpédiez pas tout le contexte, et c'est là que se trouve l'essentiel de l'économie dans les longues chaînes. La charge utile du premier tour reprend le corps create standard, moins les champs propres au transport comme stream et background, qui ne s'appliquent pas ici. La requête reste donc légère même quand la conversation grandit.
Continuation plus rapide pour les workflows chargés en outils
Le bénéfice phare apparaît dès qu'un workflow implique beaucoup d'allers-retours entre modèle et outil. C'est le monde des workflows d'agents à faible latence, et ce transport a été conçu pour eux. Les recommandations d'OpenAI évoquent un gain de vitesse notable sur les déploiements à nombreux appels d'outils, le gain venant du chemin de continuation et pas seulement du premier token, précisément la partie qui fait perdre le plus de temps quand un agent repasse sans cesse par les mêmes outils. Tous les workflows ne le ressentent pas. Si votre agent appelle à peine des outils, vous ne verrez pas grand-chose. S'il les appelle en permanence, c'est tout l'intérêt.
Fonctionne avec store=false et la rétention zéro des données
Le mode WebSocket fonctionne avec store=false et les configurations de rétention zéro des données, ce qui compte si vous ne pouvez pas laisser OpenAI conserver l'état des réponses. Le serveur garde l'état récent de la réponse en mémoire pendant la durée de vie de la connexion, donc vous obtenez des continuations rapides sans persister les tours entre les requêtes, ce qui laisserait sinon des données derrière sur le serveur. Pour les équipes en environnement réglementé ou sensible à la vie privée, cette combinaison est la raison de choisir ce transport.
Événements en streaming et ordre identiques au modèle HTTP
Les événements du serveur et leur ordre correspondent au modèle de streaming existant de Responses. Si vous gérez déjà des événements de streaming en HTTP, les formes des événements vous sembleront familières, donc vous n'avez pas à réécrire la logique de votre client de zéro. La différence tient au canal de livraison, pas au format du message. Alors pourquoi changer ? Pour la vitesse, dans les cas où elle compte. Cela garde le coût de migration bas.
Avantages et inconvénients
Avantages
- Latence de continuation plus faible dans les workflows à nombreux appels d'outils, là où le mode HTTP fait le plus mal.
- N'envoyer que l'entrée incrémentale réduit la transmission répétée et la surcharge de configuration de connexion.
- Prend en charge store=false et la rétention zéro des données, donc les équipes sensibles à la vie privée peuvent l'utiliser.
- Les événements du serveur et leur ordre correspondent au modèle de streaming HTTP, donc le code client existant s'adapte facilement.
- Un seul socket ouvert convient mieux aux boucles de codage agentique et d'orchestration que des requêtes HTTP empilées.
Inconvénients
- Cela ne vaut le coup que pour les workflows longs et chargés en outils ; les conversations courtes et les appels uniques gagnent peu.
- La connexion a une limite de temps, donc il faut prévoir une logique de reconnexion pour les agents de longue durée.
- Le transport demande plus de code à gérer qu'un simple appel HTTP, ce qui augmente la complexité du client.
- Vous payez toujours les tarifs d'usage standard de l'API ; le mode réduit la latence, pas le coût par token.
Questions fréquentes
C'est un mode de transport qui garde une connexion WebSocket persistante vers l'API Responses au lieu de faire une nouvelle requête HTTP à chaque tour. Vous envoyez uniquement les nouveaux éléments d'entrée et un previous_response_id, ce qui réduit la surcharge par tour sur les longues exécutions d'agent. Voyez cela comme rester en ligne au lieu de raccrocher et de recomposer.
Contenus associés
Découvrez des outils, des compétences et des articles liés à OpenAI WebSocket Mode for Responses API.
Alternatives à OpenAI WebSocket Mode for Responses API
Codeflying
Kuafu Technology (Codeflying) · Programmation · Marketing · ChatbotCodeflying est un créateur d'apps par IA qui transforme une description en langage naturel en un site web, une app mobile ou une mini app fonctionnels. Il fonctionne comme un créateur d'apps sans code : vous tapez ce que vous voulez et une série d'agents IA prennent en charge les besoins, l'architecture, les écrans front-end, la logique back-end et le déploiement. L'objectif est simple : créer une app à partir d'un prompt, même sans aucune base en programmation. Des outils marketing et un agent de chat pour la clientèle sont aussi inclus, donc le résultat est plus qu'un prototype oublié sur un disque dur.
Runware
Runware, Inc. · Image · Vidéo · ProgrammationRunware est une plateforme d'inférence d'IA générative qui donne aux développeurs une seule API pour les modèles d'image, de vidéo, d'audio, de 3D et de langage. Au lieu de s'inscrire chez une dizaine de fournisseurs, vous appelez un unique endpoint, vous changez de modèle avec une ligne de code et vous payez seulement les requêtes que vous envoyez. Aucun serveur à gérer. L'outil vise les équipes qui veulent livrer des fonctions d'IA vite, sans monter ni surveiller leur propre infrastructure GPU.

Aider
Aider AI LLC · ProgrammationAider est un outil de programmation en binôme avec IA open source qui vit dans votre terminal. Vous le pointez vers un dépôt git local, vous décrivez ce que vous voulez en langage naturel et il modifie les fichiers, écrit les diffs et enregistre les modifications à votre place. Il se connecte à Claude, GPT, DeepSeek et Gemini via vos propres clés d'API, et il fait aussi tourner des modèles locaux par Ollama ou n'importe quel point de terminaison compatible avec OpenAI. Les développeurs qui travaillent déjà en ligne de commande l'adoptent vite. Il ne gêne pas. Tout son attrait est là.