

OrioSearch: Your AI Agent need WebSearch
vkfolio · Programmation
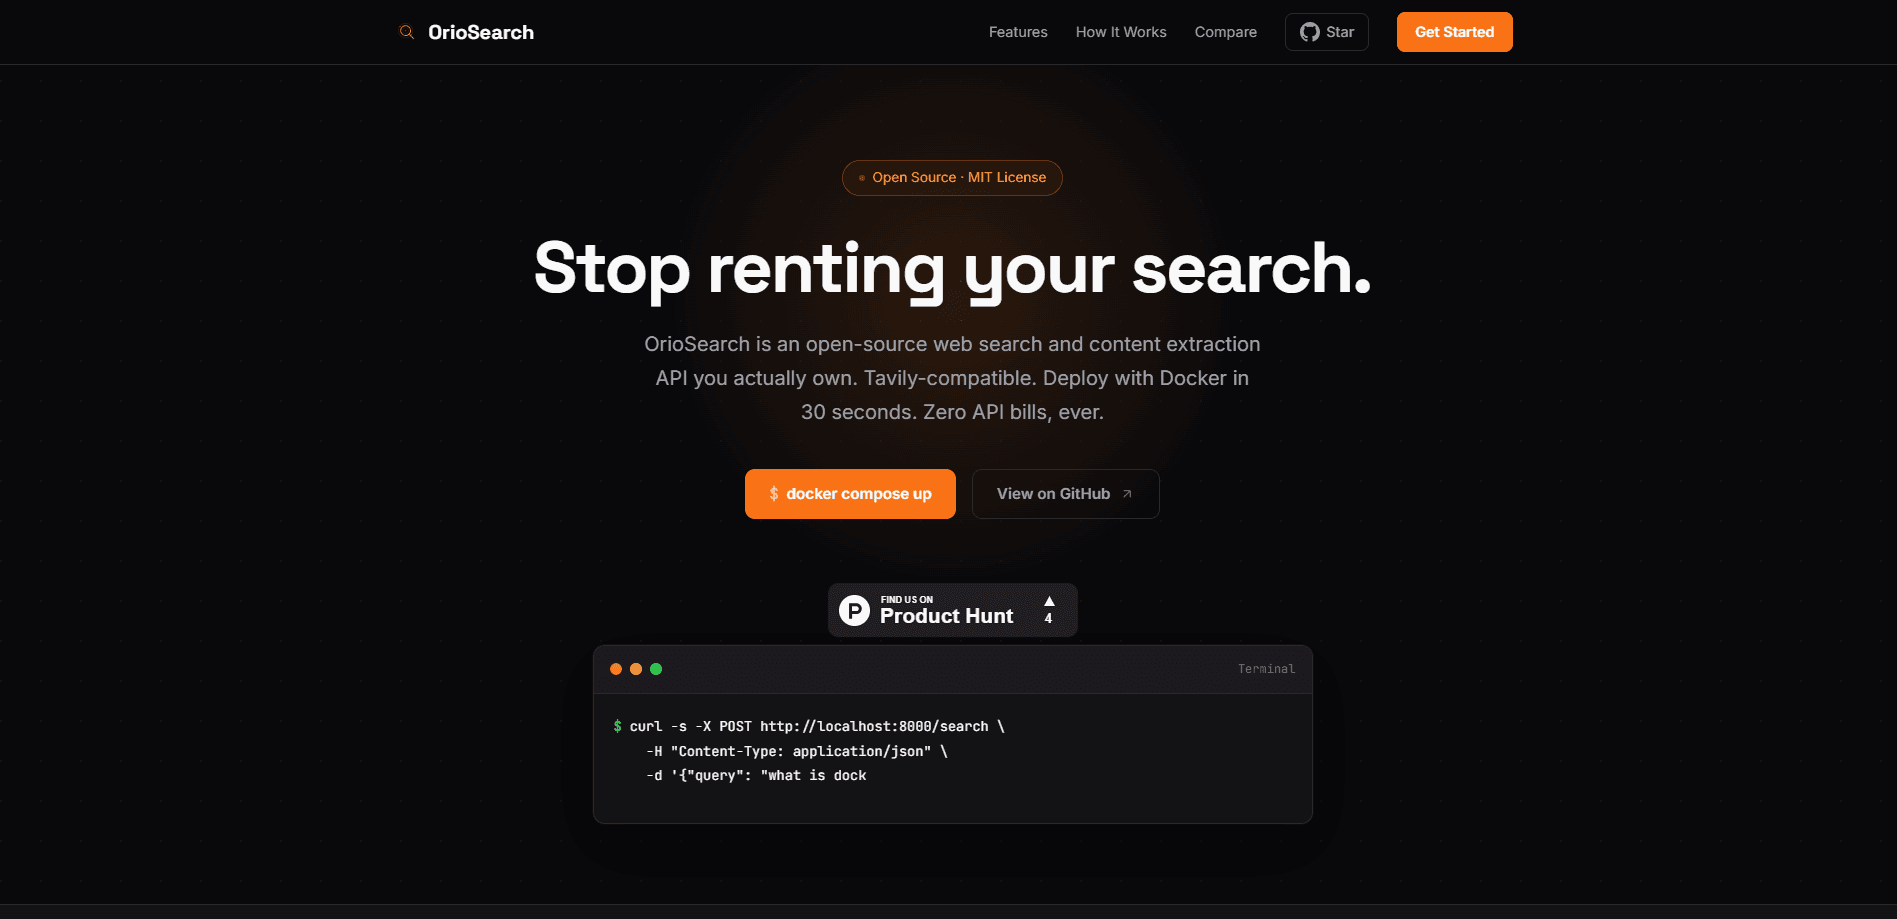
OrioSearch est une API de recherche web et d'extraction de contenu open source et auto-hébergée, conçue pour les agents d'IA. Elle imite l'interface de Tavily. Vous changez une URL et votre code continue de tourner. Le piège ? C'est vous qui l'hébergez et vous ne payez rien par requête. Voilà l'échange. Elle réunit SearXNG, FastAPI et Redis dans un seul déploiement Docker que vous contrôlez, donc votre moteur de recherche tourne là où vous décidez de l'installer.
À propos de OrioSearch: Your AI Agent need WebSearch
Qu'est-ce qu'OrioSearch
OrioSearch est un backend de recherche que vous exécutez sur votre propre machine ou serveur. Il répond aux mêmes appels /search et /extract que Tavily, tire ses résultats d'une couche de méta-recherche SearXNG et peut aussi renvoyer le texte propre d'une page ou des réponses rédigées par IA. La promesse est simple : vos agents accèdent à la recherche web sans facture à l'usage et sans envoyer chaque requête sur les serveurs d'un tiers.
Le projet vise les développeurs qui construisent des agents d'IA, des pipelines RAG ou des outils de recherche et qui ne veulent pas voir le coût par requête grimper avec l'usage. Tout est publié sous licence MIT, donc vous pouvez lire le code, le modifier et le déployer à des fins commerciales. Cette liberté est rare. La plupart des API de recherche hébergées gardent l'intérieur fermé, et vous acceptez le prix qu'elles fixent, lequel grimpe en général avec votre usage et vous laisse peu de marge quand les conditions changent.
Le principal bémol, c'est que l'hébergement devient votre affaire. Il vous faut Docker, un endroit où faire tourner trois services et quelqu'un pour gérer les mises à jour et les pannes. Si un moteur de recherche tombe, cela relève de votre infrastructure, pas du support d'un fournisseur. L'équipe ne propose pas d'option cloud managé, donc vous échangez du confort contre du contrôle. Autant le dire. Qui doit passer son chemin ? Quiconque n'a pas de serveur où l'exécuter.
Pour commencer
- Installez Docker et Docker Compose sur la machine qui hébergera le service.
- Clonez le dépôt depuis GitHub, puis lancez
docker compose up --buildpour démarrer l'API, SearXNG et Redis d'un coup. - Vérifiez que l'API répond avec une requête vers
/health, qui doit renvoyer un statut ok. - Envoyez un appel de test
POST /searchavec une requête etmax_results, et confirmez que vous recevez des titres, des URL et des extraits. - Pointez le code Tavily déjà utilisé dans votre agent vers
http://localhost:8000et supprimez la clé d'API.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de OrioSearch: Your AI Agent need WebSearch.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Les développeurs d'agents d'IA
- Les créateurs amateurs et indés
- Les équipes soumises à des règles de confidentialité
Tâches
- Recherche web pour agents d'IA
- Extraction de contenu
- Génération de réponses par IA
Cas d'usage
- Les longs travaux de recherche qui lancent des centaines de requêtes
- Les pipelines sensibles à la confidentialité
- Les piles d'agents auto-hébergées
Fonctionnalités clés
Remplacement direct compatible avec Tavily
L'API reproduit les points d'accès /search, /extract et /tool-schema de Tavily, donc basculer revient souvent à changer une URL de base et à effacer la clé d'API. Le code de votre agent et l'analyse des réponses continuent de fonctionner. Cette compatibilité est la raison pour laquelle la migration ne fait pas mal, car un changement d'API classique oblige à réécrire les constructeurs de requêtes, les gestionnaires de réponses et les chemins d'erreur avant de pouvoir livrer quoi que ce soit. Pas de réécriture. Pas de nouveau SDK à apprendre non plus.
Plus de 70 moteurs de recherche via SearXNG
OrioSearch s'appuie sur SearXNG pour agréger les résultats de Google, Bing, DuckDuckGo et des dizaines d'autres, avec un repli automatique sur DuckDuckGo si SearXNG est injoignable. Plus de sources, c'est plus de chances de capter un résultat qu'un moteur unique laisserait filer. Le moteur qui gagne dépend de la requête, et c'est justement l'intérêt de les regrouper.
Extraction de contenu à plusieurs niveaux
Quand vous pointez une URL, le pipeline d'extraction utilise d'abord trafilatura et se rabat sur readability-lxml en cas d'échec. Il renvoie un markdown ou un texte brut propre plutôt que du HTML brut. Cela vous évite une étape d'analyse avant que le contenu n'entre dans un modèle. Petit détail. Cela s'accumule sur des milliers de pages.
Réponses IA avec citations
Activez include_answer: true et OrioSearch synthétise une réponse à partir des résultats obtenus avec un modèle compatible OpenAI, puis y joint les sources. Vous pouvez l'exécuter avec Ollama en local, ou le diriger vers OpenAI ou Groq si vous préférez un modèle hébergé. À vous de choisir. La qualité de la réponse suit le modèle que vous branchez, donc un petit modèle local et un modèle de pointe ne se lisent pas pareil.
Résultats en streaming via SSE
Le point d'accès /search/stream pousse les résultats via Server-Sent Events à mesure qu'ils arrivent, au lieu d'attendre la réponse complète. Pour les agents qui agissent dès le premier résultat utile, cela retire du temps réel à chaque tour. Ce n'est pas un petit gain quand votre agent lance des dizaines de recherches par tâche.
Cache et reclassement avec Redis
Redis regroupe les requêtes avec des TTL configurables et un repli élégant sur le cache périmé, donc les recherches répétées reviennent vite. Par-dessus, un petit modèle FlashRank ONNX reclasse les résultats selon leur pertinence sémantique, le tout sur CPU sans dépendance à PyTorch. Pas besoin de GPU. Cela garde une empreinte assez légère pour tourner à côté de votre application sur une machine modeste.
Avantages et inconvénients
Avantages
- Coût nul par requête, donc un usage intensif de l'agent ne se transforme pas en facture croissante.
- La compatibilité directe avec Tavily réduit la migration à un changement d'URL d'une ligne.
- Les requêtes et les données restent sur votre propre infrastructure, ce qui compte pour les travaux sensibles à la confidentialité.
- La licence MIT vous laisse inspecter, modifier et utiliser le code commercialement sans condition.
Inconvénients
- Hébergement, mises à jour et pannes sont à votre charge, et il n'existe aucun repli cloud managé si votre machine tombe au mauvais moment.
- L'installation demande une certaine aisance avec Docker et un peu de savoir-faire en exploitation, ce qui écarte les utilisateurs non techniques.
- Les réponses IA dépendent d'un LLM séparé que vous fournissez, donc c'est une pièce de plus à configurer et à payer.
- Pas d'application mobile officielle ni de boutique de plugins, donc tout passe par l'API.
Questions fréquentes
Oui. Il est open source sous licence MIT et ne coûte rien par requête, quelle que soit l'intensité des recherches de vos agents. Vos seuls coûts sont ce que vous payez pour faire tourner l'hôte Docker.
Contenus associés
Découvrez des outils, des compétences et des articles liés à OrioSearch: Your AI Agent need WebSearch.
Alternatives à OrioSearch: Your AI Agent need WebSearch
Forefront
Forefront · ProgrammationForefront est une plateforme web pour construire avec de l'IA open source. Elle vous laisse affiner les principaux modèles de langage open source sur vos propres données, évaluer leurs performances et les exécuter via une API ou les exporter pour les héberger vous-même. Les développeurs qui veulent le confort d'une plateforme fermée mais tiennent à rester propriétaires de leurs modèles et de leurs données sont le public visé ici.

Startkit
StartKit.AI · ProgrammationStartkit est un boilerplate pour créer des produits SaaS d'IA et des wrappers d'IA. Voyez-le comme un boilerplate de startup IA avec les parties ennuyeuses déjà branchées : authentification, paiements Stripe et Lemon Squeezy, limites d'usage, e-mail transactionnel et un kit de démarrage d'API IA qui parle à OpenAI, Anthropic, Groq ou Llama. Vous clonez le dépôt, fixez votre prix et attaquez la partie du produit pour laquelle les gens paient vraiment. Il repose sur Next.js au-dessus de React et Tailwind, donc une bonne partie du code boilerplate vous semble déjà familière.
Testim
Tricentis · ProgrammationTestim est une plateforme d'automatisation des tests dopée à l'IA, qui sert à créer et exécuter des tests de bout en bout sur des applications web, mobiles et Salesforce. Elle s'appuie sur l'apprentissage automatique pour garder les tests stables quand une interface change, alors les équipes passent moins de temps à réparer des sélecteurs cassés. Pas mal pour un outil de tests automatisés que vous pouvez utiliser dès aujourd'hui. Vous créez des tests en enregistrant des actions dans un navigateur, puis vous ajoutez du JavaScript quand vous avez besoin de plus de contrôle. C'est un choix solide pour une équipe QA bien occupée.