
Orpheus TTS
Canopy Labs · Voix et langage
Orpheus TTS est un modèle de synthèse vocale open source de Canopy Labs, bâti sur un socle Llama 3B, qui clone des voix sans entraînement, ajoute des balises d'émotion et diffuse l'audio à faible latence.
À propos de Orpheus TTS
About
Qu'est-ce qu'Orpheus TTS
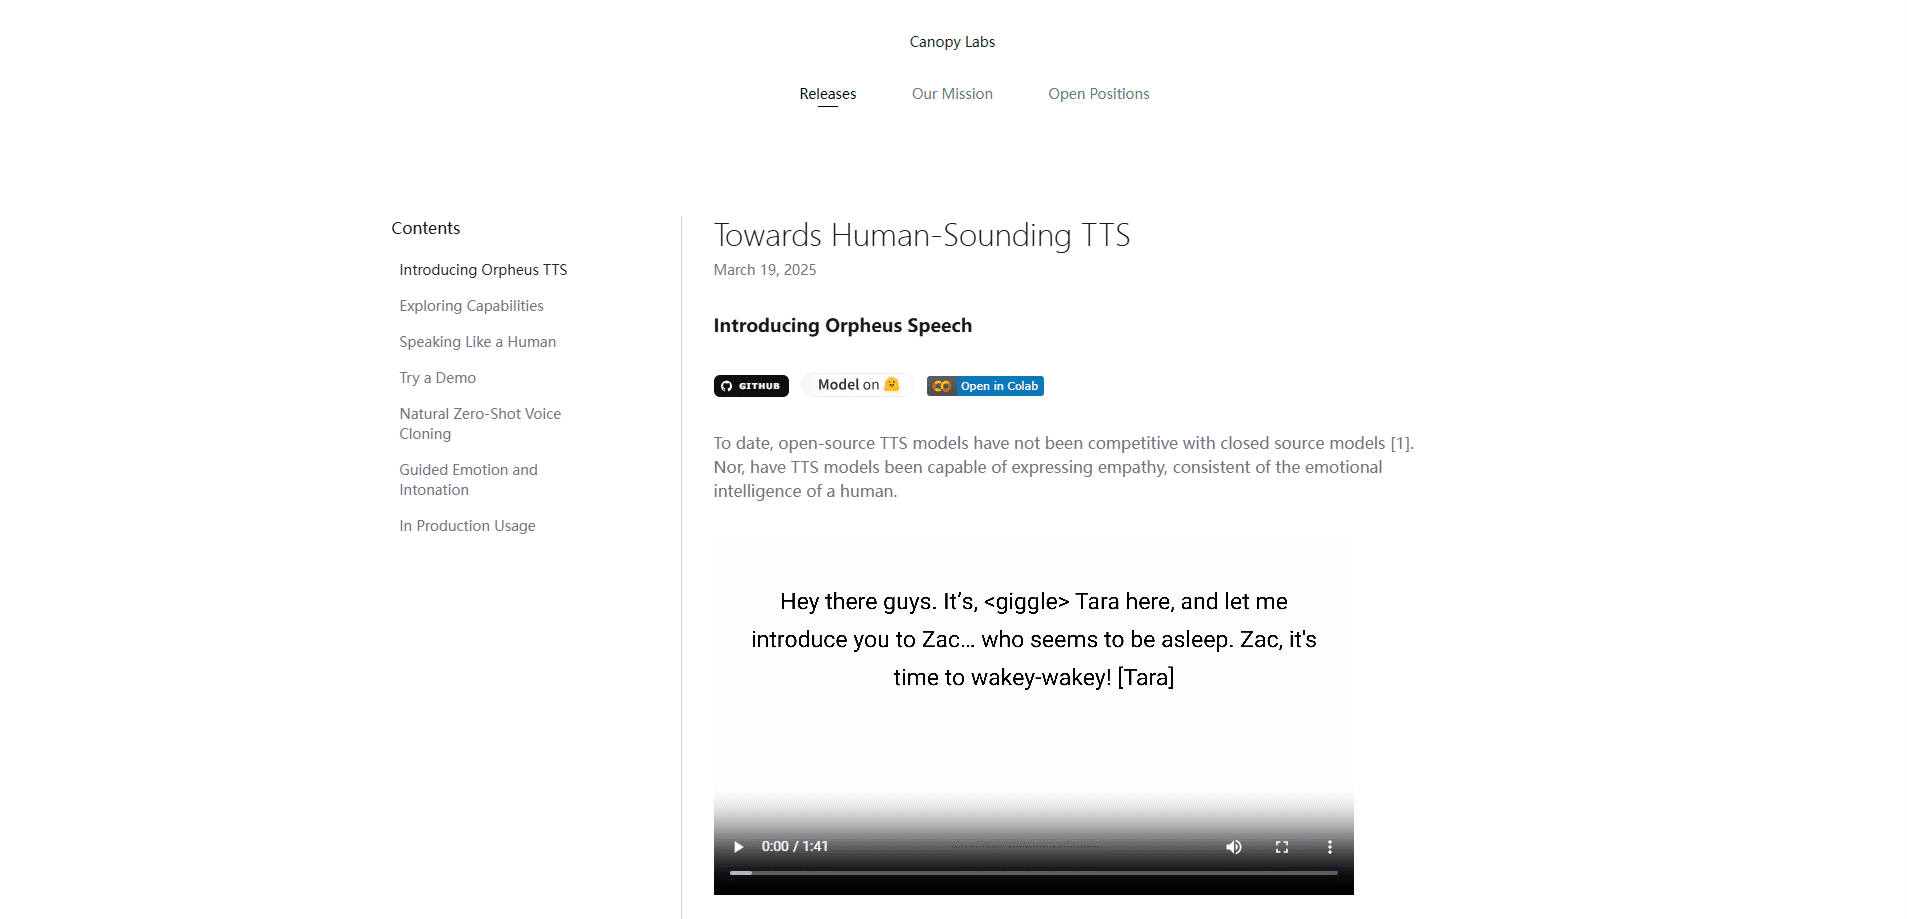
Orpheus TTS est un modèle de synthèse vocale open source créé par Canopy Labs. Il repose sur un socle Llama 3B, ce qui signifie que l'équipe applique des techniques de grands modèles de langage à la synthèse de la parole plutôt qu'une chaîne acoustique classique. Le résultat est une voix au rythme, à l'intonation et à l'émotion naturels, et le projet publie son code et ses poids pour que tout le monde puisse l'exécuter.
L'idée est simple. Les anciens systèmes vocaux traitaient chaque étape, l'analyse du texte, le rythme et la génération audio, avec des briques séparées. Orpheus aborde le problème comme une tâche de génération qu'un modèle de langage sait déjà faire. Le modèle a appris à produire des unités de parole comme un modèle de langage produit des mots, et ce cadrage a donné naissance à un comportement émergent qui, selon ses auteurs, égale ou dépasse certaines options propriétaires.
Vous obtenez un outil pour développeurs, pas une application finie. Il n'existe pas de site où vous tapez une phrase et téléchargez un fichier. Vous installez le paquet, hébergez le modèle et le branchez sur votre propre produit. Cette souplesse compte si vous voulez de la voix sans payer à la requête, et elle implique aussi que vous gérez le matériel et la configuration.
Premiers pas
- Clonez le dépôt ou installez le paquet avec pip install orpheus-speech, qui utilise vllm en interne pour une inférence rapide.
- Chargez un modèle tel que canopylabs/orpheus-tts-0.1-finetune-prod via la classe OrpheusModel.
- Écrivez votre texte avec un nom de voix optionnel et des balises d'émotion, puis appelez generate_speech avec une voix de la liste disponible.
- Diffusez les segments audio renvoyés vers un fichier WAV ou directement dans votre app pour une lecture en temps réel.
- Pour votre propre voix, préparez un jeu de données Hugging Face et lancez les scripts d'ajustement, en visant environ 300 exemples par voix.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Orpheus TTS.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs qui ajoutent de la voix à une app
- Créateurs qui veulent une voix précise
- Ceux qui construisent de la conversation en temps réel
Tâches
- Cloner une voix à partir d'un court échantillon
- Ajouter de l'émotion à une narration
- Générer de la parole dans plusieurs langues
- Exécuter la voix en local pour la confidentialité
Cas d'usage
- Alimenter une boucle d'assistant vocal
- Narrer des livres audio et de longs scripts
- Doubler une vidéo dans une autre langue
Fonctionnalités clés
Une voix au son humain
Orpheus TTS produit une intonation, une émotion et un rythme qui, selon ses auteurs, rivalisent avec les meilleurs systèmes propriétaires, voire les dépassent. Il capte les signaux du texte et peut glisser un soupir ou un rire là où l'écriture le suggère. C'est sa promesse principale, et c'est ce qui a mis le projet au centre des discussions sur l'open source. Un texte propre et bien balisé donne les meilleurs résultats.
Clonage de voix sans entraînement
Le modèle pré-entraîné copie une voix sans aucun ajustement. Donnez-lui une ou plusieurs paires texte-parole dans le prompt et il imite la personne sur un texte nouveau. Plus vous passez de paires, plus il tombe sûrement sur la bonne voix. C'est ce qui le distingue des anciens systèmes qui exigeaient des heures d'enregistrement.
Émotion et intonation guidées
Vous orientez l'interprétation avec des balises simples, comme rire, petit rire, soupir, toux, reniflement, gémissement, bâillement et halètement. Le modèle les lit comme du texte et façonne l'audio autour. Pour des dialogues, des livres audio ou un chatbot qui doit sonner humain, ce contrôle change beaucoup. Les balises prises en charge varient selon la langue dans la version multilingue.
Streaming à faible latence
La latence en streaming tourne autour de 200 millisecondes, et la documentation indique qu'elle peut descendre vers 100 avec une entrée en streaming. Pour des usages en temps réel comme les assistants vocaux, cet écart décide si la conversation paraît naturelle. Le paquet émet les segments audio au fil de leur génération, donc vous pouvez lancer la lecture avant que le clip entier soit prêt.
Plusieurs tailles de modèle
Au-delà des modèles anglais ajusté et pré-entraîné, le projet prévoit plusieurs versions plus petites de 1B, 400M et 150M paramètres. Les petits modèles échangent un peu de qualité contre de la vitesse et un matériel plus léger, ce qui compte si vous déployez sur des machines modestes. La feuille de route les liste comme prochaines sorties.
Ajustement sur votre propre voix
Le dépôt fournit des scripts d'entraînement et de traitement des données pour adapter le modèle de base à votre propre locuteur. Les résultats deviennent bons après une cinquantaine d'exemples, et l'équipe conseille de viser 300 par locuteur pour le meilleur rendu. La démarche ressemble à l'ajustement d'un modèle de langage avec Trainer et Transformers, donc un bagage en ML aide.
Plusieurs façons de l'exécuter
Vous pouvez lancer Orpheus TTS via le paquet Python, une voie sans GPU avec llama.cpp ou un déploiement dédié chez Baseten, le partenaire d'inférence privilégié du projet. Des builds communautaires ajoutent une API compatible OpenAI et une interface web Gradio. Choisissez la voie qui colle à votre façon de livrer.
Avantages et inconvénients
Avantages
- Parle avec une émotion et un rythme naturels qui rivalisent avec les modèles propriétaires
- Clone une voix sans entraînement à partir d'un court échantillon
- Diffuse l'audio avec une latence d'environ 200 ms pour les apps temps réel
- Poids et code ouverts, donc vous pouvez l'exécuter vous-même
- Les balises d'émotion donnent un contrôle fin de l'interprétation
Inconvénients
- Pas d'API officielle hébergée, donc vous hébergez et maintenez vous-même
- Nécessite un GPU pour une inférence rapide, et le fichier du modèle de base est volumineux
- La qualité dépend du clip de référence, donc un audio bruité dégrade le résultat
- La famille multilingue complète reste une préversion de recherche
Questions fréquentes
Orpheus TTS transforme du texte en une voix naturelle et peut imiter une voix choisie. Les développeurs l'emploient pour des assistants vocaux, de la narration, du doublage et de la recherche sur les modèles vocaux. C'est une brique à brancher sur un projet plus vaste, pas un produit autonome.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Orpheus TTS.
Alternatives à Orpheus TTS

Foley
Hanamori Labs, LLC · Voix et langage · Productivité · Assistant d’IAFoley est une liste de tâches vocale qui transforme une phrase prononcée en tâche classée, projet, date et heure compris, puis vous aide à organiser la journée à partir de ce qui est déjà noté.

HireKey
HireKey · Voix et langage · Productivité · ApprentissageHireKey est un copilote de recherche d'emploi IA conçu par une ancienne recruteuse tech. Il évalue l'adéquation au poste, adapte le CV, entraîne aux entretiens et suit chaque candidature.

Fluence
Yay Software (Yannick Huchard) · Rédaction · Voix et langage · ProductivitéFluence est une application Android qui lit à voix haute vos PDF, EPUB, fichiers Word et articles web, suit la phrase prononcée et répond aux questions sur le texte sans quitter le téléphone.