
Parallax by Gradient
Gradient · Autres
Parallax by Gradient est un moteur d'inférence totalement décentralisé qui vous permet de monter votre propre cluster IA pour exécuter de grands modèles de langage sur plusieurs appareils, aussi différents soient leurs composants et où qu'ils se trouvent physiquement. Au lieu de louer des GPU dans le cloud, vous réunissez les machines que vous possédez déjà et servez des modèles comme Qwen, DeepSeek et GLM depuis un seul endpoint local.
À propos de Parallax by Gradient
Qu'est-ce que Parallax by Gradient
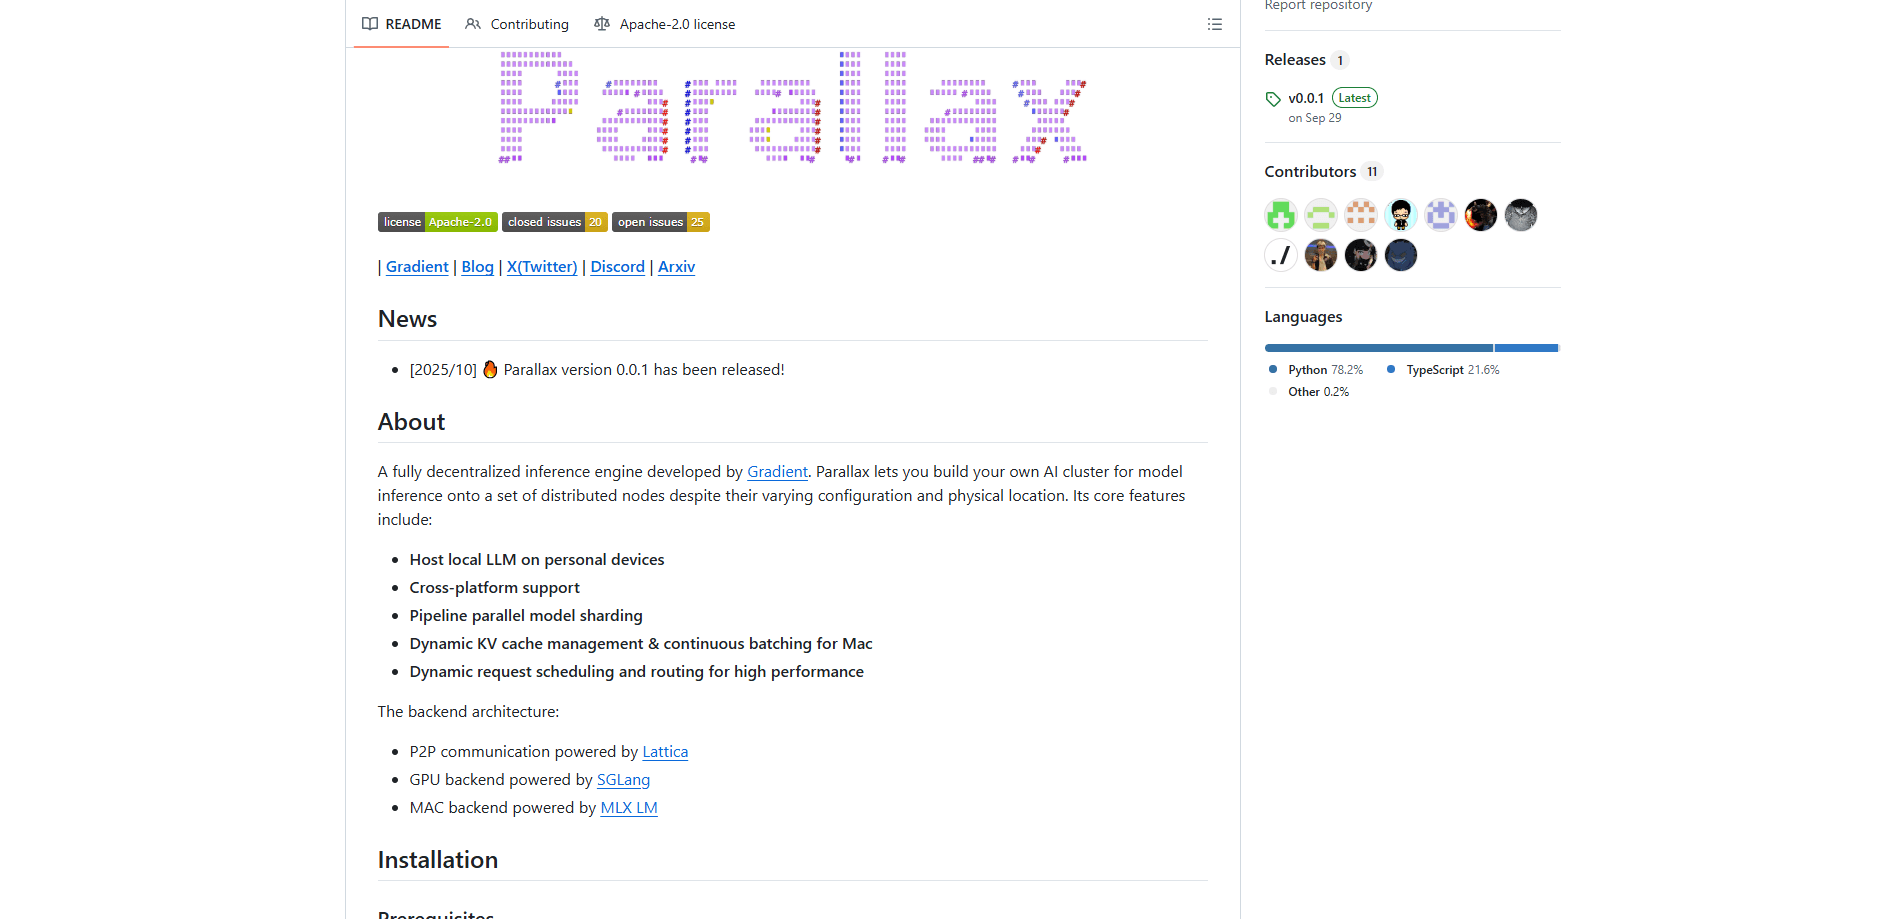
Parallax est un framework open source de cluster IA distribué, créé par Gradient. Il répartit un grand modèle de langage sur plusieurs machines et exécute l'inférence sur toutes en même temps, si bien qu'un ordinateur portable, un bureau équipé d'un GPU et un petit serveur de l'autre côté de votre réseau domestique agissent comme une seule machine plus grande. Le tout parle un protocole pair à pair, ce qui signifie qu'aucun serveur central n'a besoin de rester en ligne. Voilà la promesse.
Le problème qu'il résout est simple à énoncer et pénible à vivre. Faire tourner un LLM performant suppose en général soit de payer au token auprès d'un fournisseur cloud, soit d'acheter un GPU très coûteux capable d'accueillir le modèle entier. Parallax emprunte une troisième voie. Il découpe le modèle couche par couche et fait circuler les requêtes sur le matériel dont vous disposez, si bien que vous tirez davantage des appareils déjà posés sur votre bureau. Vos prompts et vos résultats restent sur vos propres machines, ce qui compte si vous traitez des éléments que vous préférez ne pas confier à un tiers.
La principale limite, c'est qu'il s'agit d'un outil de développeur, pas d'une application à installer en un clic. Il faut être à l'aise avec le terminal et, sous Linux, vous pouvez vous attendre à toucher à Docker ou à configurer des pilotes GPU. Le projet est jeune. La version 0.0.1 est arrivée en octobre 2025, donc des aspérités sont à prévoir et la prise en charge des modèles évolue sans cesse. Si vous voulez quelque chose qui fonctionne dès la sortie de la boîte, sans aucune configuration, une API hébergée vous traitera mieux.
Premiers pas
- Installez le client en clonant le dépôt et en exécutant
./install.sh, qui prépare un environnement virtuel Python et compile les binaires nécessaires. Les utilisateurs de Windows peuvent récupérer un installateur autonome. - Activez l'environnement avec
source .venv/bin/activateet vérifiez que les extras de votre matériel ont bien été détectés, car les builds GPU pour macOS et Linux installent des composants backend différents. - Démarrez le nœud local avec une commande comme
parallax serve -m Qwen/Qwen3.5-0.8B, en choisissant un modèle qui tient dans votre mémoire combinée. - Rejoignez d'autres machines au même cluster pour que les fragments du modèle couvrent chaque appareil ajouté.
- Pointez votre application ou votre script vers l'endpoint local et envoyez des requêtes comme vous le feriez vers n'importe quelle API compatible OpenAI.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Parallax by Gradient.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Les développeurs qui possèdent déjà quelques machines et veulent faire tourner des charges LLM auto-hébergées sans factures cloud, à condition d'accepter de travailler depuis le terminal.
- Les équipes soucieuses de la confidentialité qui traitent du texte sensible et préfèrent garder l'inférence sur du matériel local plutôt que d'envoyer des prompts à une API hébergée.
- Les amateurs curieux de montages de cluster IA distribué, prêts à consacrer un après-midi à la configuration.
Tâches
- Héberger un endpoint LLM partagé pour un laboratoire domestique ou un petit bureau où plusieurs personnes pointent leurs outils vers un même serveur local.
- Tester et comparer des modèles ouverts comme Qwen, DeepSeek ou GLM sur du matériel réel au lieu de payer chaque exécution de benchmark.
- Construire des agents et des outils internes qui ont besoin d'un backend d'inférence IA local, sans dépendance à un fournisseur ni plafond d'usage.
Cas d'usage
- Un projet du week-end pour tirer un modèle plus gros d'un ordinateur portable et d'un bureau de rechange doté d'un GPU.
- Exécuter un assistant de code sur les machines du bureau pour qu'aucun code source ne quitte les locaux.
- Expérimenter le découpage de modèle par parallélisme de pipeline pour voir jusqu'où va du matériel grand public mis en commun.
- Toute personne qui veut exécuter un LLM en local sur quelques machines hétérogènes et se passer entièrement du cloud.
Fonctionnalités clés
Découpage distribué du modèle
Parallax répartit un modèle entre les appareils via le parallélisme de pipeline, si bien que chaque machine ne détient qu'une tranche du réseau plutôt que l'ensemble. C'est ce qui permet à du matériel aux caractéristiques très différentes de coopérer sur un même modèle. Vous pouvez faire grandir le cluster en ajoutant des nœuds, et le framework ajuste la répartition du travail.
Cluster indépendant du matériel
Le moteur n'exige pas des machines identiques. Il gère la partie délicate du routage des requêtes entre des nœuds de configuration et de localisation physique variées, ce qui est tout l'intérêt d'un montage décentralisé. Un Mac, une machine Linux avec GPU et un ordinateur Windows peuvent tous participer au même cluster.
Communication pair à pair
Les nœuds dialoguent entre eux via Lattica, une couche P2P, donc il n'y a pas de point de défaillance unique dans le réseau. Si un nœud tombe, le cluster ne s'effondre pas avec lui. Cette conception fait de l'exécution du cluster « n'importe où » autre chose qu'un slogan marketing.
Prise en charge multiplateforme
Vous pouvez installer Parallax sur Windows, Linux et macOS. Le backend GPU s'appuie sur SGLang et vLLM, tandis que les Mac passent par MLX LM. Les chemins d'installation diffèrent selon le système, et le projet livre un installateur Windows plus des images Docker pour les machines à GPU. Le bénéfice est un véritable hébergement de LLM multiplateforme : un cluster, plusieurs systèmes d'exploitation, sans toucher au code.
Traitement optimisé des requêtes
Sur Mac, Parallax ajoute une gestion paginée du cache KV et le batching continu, des techniques qui contiennent l'usage de la mémoire tout en servant de nombreuses requêtes. L'ordonnancement des requêtes s'ajuste à la volée pour décider quel nœud traite quoi, dans le but de maintenir un débit élevé sur tout le cluster.
Service compatible OpenAI
Une fois un nœud lancé, il expose un endpoint que vos outils actuels peuvent appeler presque comme une API hébergée. Vos applications, scripts et agents déjà construits n'ont donc pas besoin d'être réécrits. Le projet documente aussi une voie d'intégration pour OpenClaw.
Avantages et inconvénients
Avantages
- Gratuit et open source, donc pas de facture au token et vous pouvez lire exactement comment l'inférence fonctionne.
- Transforme le matériel que vous possédez déjà en un cluster LLM opérationnel, y compris des machines hétérogènes.
- Garde les prompts et les résultats sur vos propres appareils, ce qui aide pour la confidentialité et la conformité.
- La prise en charge multiplateforme permet de partager un même déploiement entre des Mac et des machines Linux à GPU.
- L'architecture P2P évite un serveur central, donc pas de point de défaillance unique.
Inconvénients
- La configuration est de niveau développeur. Ce n'est pas une application en un clic, et les installations GPU sous Linux peuvent impliquer Docker ou du travail sur les pilotes.
- Le projet est à un stade précoce. Attendez-vous à une prise en charge des modèles mouvante et à des casses occasionnelles.
- Les performances dépendent entièrement de votre matériel ; des appareils grand public mis en commun n'égaleront pas un cluster GPU cloud.
- La documentation est encore en cours de rédaction, donc une partie du dépannage passe par la lecture du dépôt ou une question sur Discord.
Questions fréquentes
Oui. Parallax by Gradient est open source et gratuit, sans abonnement. Vous ne payez que l'électricité et le matériel sur lesquels vous l'exécutez déjà. Il n'y a pas d'offre payante, donc le prix « $0 » couvre le produit entier.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Parallax by Gradient.
Alternatives à Parallax by Gradient
BinkBink
BinkBink · AutresBinkBink est une plateforme de jeux en ligne gratuite et un créateur de jeux par IA qui permet à n'importe qui de transformer une courte description textuelle en un jeu de navigateur jouable. Vous pouvez plonger dans des centaines de jeux créés par la communauté. Ou décrivez votre propre idée, jouez-y en quelques secondes, puis partagez-la avec vos amis. Vous voulez créer votre propre jeu ? Pas besoin de coder. Aucun moteur à installer, aucun téléchargement, aucune prise de tête.

Audiogen
Audiogen Inc. · AutresAudiogen est un générateur de musique par IA conçu par Audiogen Inc., une petite équipe de recherche qui a passé environ deux ans et demi à entraîner son propre modèle de musique générative et à bâtir une interface web autour. Au lieu d'une simple zone de texte, cet outil de musique par IA transforme la timeline en une Station de Travail Audio Générative (GAW), pensée pour les débutants, où l'inpainting, l'extension, le remix et l'édition de pistes fonctionnent davantage comme de la peinture sur une toile. Le produit est encore en bêta, l'accès passe donc par une liste d'attente ou une invitation. Les formules payantes ne sont pas encore publiées.

Aiml API
AIMLAPI OÜ · AutresAiml API est une API unifiée de modèles d'IA qui place plus de 1000 modèles d'OpenAI, Google, Anthropic et d'autres derrière un seul point d'accès et une seule facture. Vous écrivez du code contre un unique schéma compatible OpenAI, puis vous passez d'un modèle de chat, d'image, de vidéo ou d'audio à un autre en changeant une chaîne de modèle. Elle convient aux développeurs et aux petites équipes qui veulent un accès multimodèle sans jongler avec une douzaine de comptes de fournisseurs distincts, et elle supprime le casse-tête habituel de la facturation quand on teste plusieurs prestataires. Une seule clé couvre tout.