
PDFMerse
PDFMerse · Programmation · Productivité
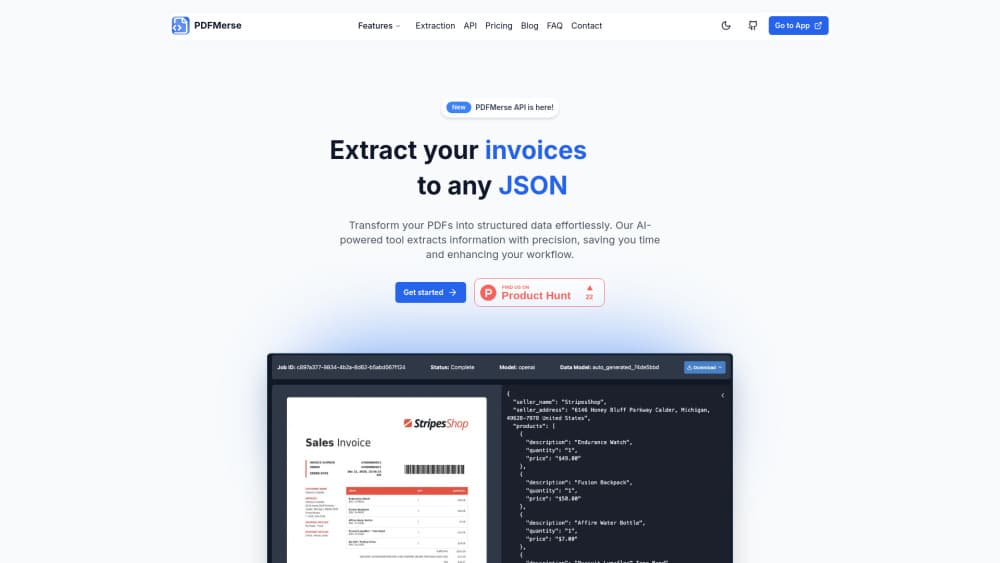
PDFMerse est un outil d'IA qui extrait des données de n'importe quel PDF et les transforme en données structurées comme du JSON ou du CSV, conçu pour les équipes qui ont besoin de documents convertis en lignes exploitables.
À propos de PDFMerse
Qu'est-ce que PDFMerse
PDFMerse est un outil d'extraction de données PDF propulsé par l'IA. Vous lui donnez un document, il lit la mise en page comme le ferait une personne, et il vous rend des données structurées que vous pouvez trier, filtrer ou charger dans une base de données. La promesse est simple : arrêter de recopier à la main les chiffres des factures, des rapports et des relevés. Toute l'idée est là.
Beaucoup de gens cherchent d'abord comment extraire des données de fichiers PDF quand la méthode manuelle finit par les épuiser. PDFMerse répond directement à ce besoin.
L'outil vise une douleur précise. La plupart des PDF sont faits pour l'impression, pas pour l'analyse. Le texte tombe dans des colonnes bizarres, les tableaux se coupent d'une page à l'autre et les pages scannées ne sont que des images. Sortir des données de ces fichiers avec un convertisseur classique vous laisse un tas de texte illisible qu'il faut encore nettoyer pendant des heures avant de pouvoir s'en servir. PDFMerse traite l'extraction comme un problème de compréhension avant tout, donc le résultat garde sa structure.
Le hic, c'est qu'aucun outil d'extraction n'est parfait, et PDFMerse ne prétend pas le contraire. La précision dépend de la propreté de vos fichiers sources. Une facture numérique nette s'analyse bien mieux que la photo de travers d'un reçu prise au téléphone. Si vous attendez 100 % de précision sur chaque page, vous serez déçu. Prévoyez de vérifier le résultat par échantillonnage, surtout au premier passage sur un nouveau type de document.
Pour commencer
- Créez un compte sur le site de PDFMerse et connectez-vous à votre tableau de bord.
- Importez un PDF ou connectez la source d'où viennent vos documents.
- Définissez les champs que vous voulez récupérer, comme le numéro de facture, la date, le total ou le fournisseur.
- Lancez l'extraction et laissez l'IA lire chaque page.
- Vérifiez la sortie structurée, puis exportez-la en JSON ou CSV pour votre tableur, votre base de données ou votre API.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de PDFMerse.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Équipes finance et comptabilité
- Personnel des opérations et de l'administration
- Ingénieurs données et opérations
Tâches
- Extraction de données de factures
- Numérisation de rapports
- Traitement de formulaires
Cas d'usage
- Comptabilité de fin de mois
- Travail de recherche et d'enquête
- Migration de dossiers papier
Fonctionnalités clés
PDF vers données structurées
Le cœur du travail, c'est de transformer un PDF en données structurées réutilisables ailleurs. PDFMerse lit le document, identifie les champs qui vous intéressent et les renvoie dans un format organisé plutôt qu'en mur de texte. La différence compte quand vous injectez le résultat dans un tableur ou une base de données, où une colonne propre bat un copier-coller tous les jours.
Définition de champs personnalisés
C'est vous qui décidez quoi extraire. Au lieu d'espérer que l'outil devine juste, vous fixez les noms de champs voulus, comme le numéro de facture, la date d'échéance ou le montant total. La sortie reste ainsi alignée sur le système dans lequel vous chargez les données, et vous passez moins de temps à tout remodeler après coup.
Export JSON et CSV
Les données extraites sortent dans des formats que vos autres outils parlent déjà. Besoin de PDF vers JSON pour un flux de développeur ? C'est fait. Besoin de PDF vers CSV pour un tableur ? Ça marche aussi. Le JSON convient aux développeurs et aux flux avec API, tandis que le CSV tombe directement dans Excel ou Google Sheets pour qui vit dans les tableurs. Avoir les deux évite une étape de conversion au milieu.
Gestion des mises en page complexes
Les vrais PDF ne sont pas bien rangés. Les tableaux s'étalent sur plusieurs pages, les colonnes courent côte à côte et les en-têtes se répètent. Alors que se passe-t-il quand un tableau se coupe sur trois pages avec un en-tête répété que vous ne voulez pas copier deux fois ? L'IA est conçue pour lire ces mises en page dans un ordre sensé au lieu de saisir le texte par position et de le massacrer. C'est là qu'un outil d'extraction utile se distingue d'un simple vidage de texte.
Précision sur les documents en désordre
Les documents varient énormément, et l'extraction doit tenir sur toute cette plage. Un fichier numérique bien formé s'extrait proprement ; une page scannée ou une capture de mauvaise qualité est plus difficile et peut demander un coup d'œil. Un scan net d'une facture standard d'un fournisseur connu revient souvent presque parfait, alors qu'un reçu froissé photographié sur un vieux téléphone dans une mauvaise lumière mettra à l'épreuve le modèle et votre patience. Savoir dans quel camp tombent vos fichiers vous dit combien de relecture prévoir.
Traitement par lots
Quand vous travaillez sur plus d'un fichier, le traitement par lots est ce qui fait gagner du temps pour de bon. Le but n'est pas une extraction unique et parfaite, c'est de vider une file de factures ou de formulaires en une seule passe. C'est là qu'un extracteur de données PDF justifie son coût face au même travail fait à la main. Vous lui donnez cinquante relevés et vous partez. Vous revenez sur un tableau.
Avantages et inconvénients
Avantages
- Transforme les PDF en JSON ou CSV structuré au lieu de vous laisser avec du texte brut.
- Les définitions de champs personnalisés gardent une sortie ajustée à votre flux de travail.
- Lit les mises en page complexes, y compris les pages multicolonnes et les tableaux.
- Gère raisonnablement bien les documents scannés et imparfaits.
- Réduit la saisie manuelle sur les documents répétitifs comme les factures et les formulaires.
Inconvénients
- La précision chute sur les scans de mauvaise qualité, il faudra donc relire ces résultats.
- Uniquement dans le navigateur, sans application de bureau ni version mobile pour un usage hors ligne.
- Les prix et les niveaux de forfait exacts peuvent changer, alors vérifiez les détails actuels sur le site officiel avant de vous engager.
- Les informations publiques sur l'accès à l'API sont minces, ce qui pose problème si vous voulez automatiser à grande échelle.
Questions fréquentes
Il extrait des données de documents PDF et les renvoie sous forme de sortie structurée comme du JSON ou du CSV. Vous importez un fichier, vous indiquez les champs voulus, et il lit le document pour en tirer ces valeurs.
Contenus associés
Découvrez des outils, des compétences et des articles liés à PDFMerse.
Alternatives à PDFMerse
Forefront
Forefront · ProgrammationForefront est une plateforme web pour construire avec de l'IA open source. Elle vous laisse affiner les principaux modèles de langage open source sur vos propres données, évaluer leurs performances et les exécuter via une API ou les exporter pour les héberger vous-même. Les développeurs qui veulent le confort d'une plateforme fermée mais tiennent à rester propriétaires de leurs modèles et de leurs données sont le public visé ici.

Startkit
StartKit.AI · ProgrammationStartkit est un boilerplate pour créer des produits SaaS d'IA et des wrappers d'IA. Voyez-le comme un boilerplate de startup IA avec les parties ennuyeuses déjà branchées : authentification, paiements Stripe et Lemon Squeezy, limites d'usage, e-mail transactionnel et un kit de démarrage d'API IA qui parle à OpenAI, Anthropic, Groq ou Llama. Vous clonez le dépôt, fixez votre prix et attaquez la partie du produit pour laquelle les gens paient vraiment. Il repose sur Next.js au-dessus de React et Tailwind, donc une bonne partie du code boilerplate vous semble déjà familière.
Testim
Tricentis · ProgrammationTestim est une plateforme d'automatisation des tests dopée à l'IA, qui sert à créer et exécuter des tests de bout en bout sur des applications web, mobiles et Salesforce. Elle s'appuie sur l'apprentissage automatique pour garder les tests stables quand une interface change, alors les équipes passent moins de temps à réparer des sélecteurs cassés. Pas mal pour un outil de tests automatisés que vous pouvez utiliser dès aujourd'hui. Vous créez des tests en enregistrant des actions dans un navigateur, puis vous ajoutez du JavaScript quand vous avez besoin de plus de contrôle. C'est un choix solide pour une équipe QA bien occupée.