
Plexe
Plexe · Programmation
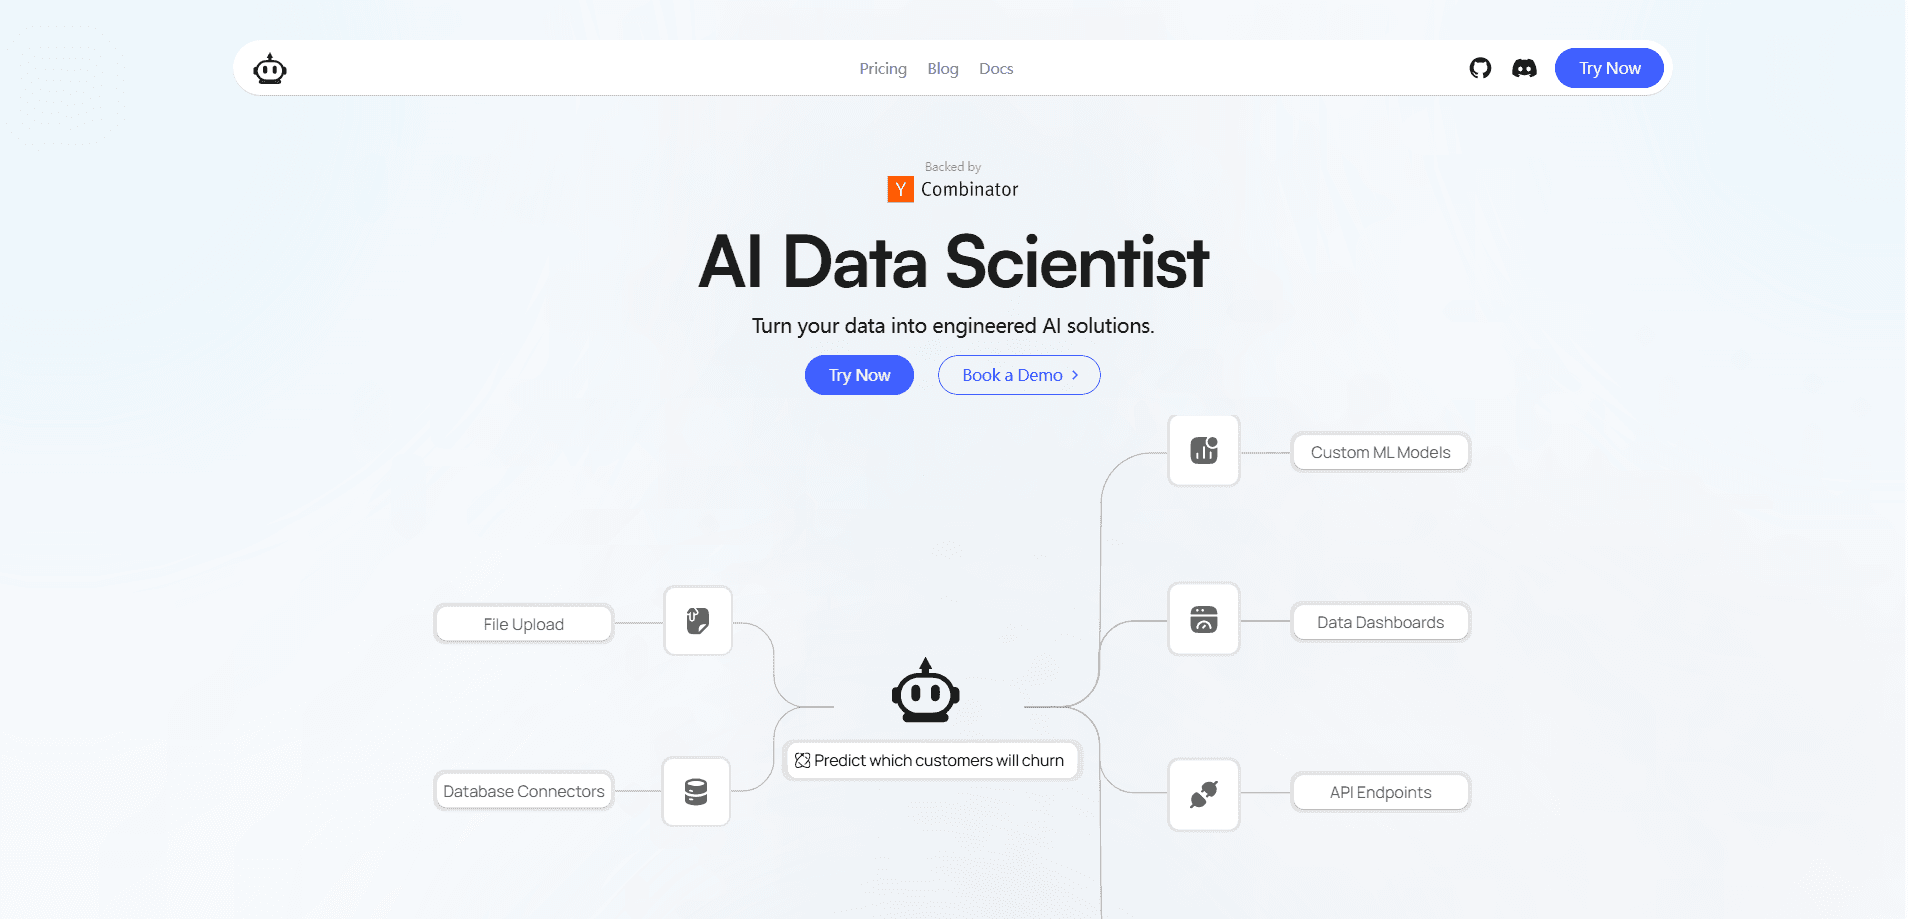
Plexe est une plateforme AutoML open source qui vous laisse créer des modèles de ML à partir du langage naturel. Vous dites ce que vous voulez avec des mots simples et l'agent fait le reste. Au lieu d'écrire le code d'entraînement à la main, vous donnez à l'agent un jeu de données et un objectif, et il gère la préparation des données, la génération de code, l'entraînement et le déploiement. Les équipes l'utilisent comme créateur de modèles d'IA pour livrer des résultats prédictifs en semaines plutôt qu'en trimestres, sans avoir d'ingénieur ML dédié dans l'équipe.
À propos de Plexe
Qu'est-ce que Plexe
Plexe est un outil piloté par agents pour ceux qui ont besoin de modèles de machine learning qui fonctionnent mais qui ne veulent pas passer des mois à apprendre toute la chaîne d'outils. C'est aussi un point d'entrée accessible pour les débutants. Vous connectez un jeu de données, vous décrivez la prédiction souhaitée, et un système multi-agents planifie l'approche, génère le code d'entraînement, l'exécute et affine le résultat jusqu'à ce qu'il soit performant. Il s'appuie sur des bibliothèques courantes comme scikit-learn, PyTorch et TensorFlow, donc la sortie reste lisible et facile à transmettre à un ingénieur qui veut aller plus loin.
Le principal problème qu'il résout est l'écart entre avoir des données et avoir un modèle déployé. Les flux traditionnels calent sur l'ingénierie des variables, le choix des frameworks et l'infrastructure, et chacune de ces étapes peut engloutir des jours avant que quiconque voie une seule prédiction. Plexe condense ces étapes en une seule boucle et garde chaque ligne du code généré visible, pour que vous puissiez l'inspecter, la modifier ou la remettre à vos propres ingénieurs plus tard.
La plus grande limite est qu'il vous faut quand même des données correctes et un objectif clair. Une instruction vague sur un jeu de données désordonné ne produira pas un modèle prédictif utile, aussi bon soit l'agent. C'est aussi un produit à un stade précoce. Attendez-vous à quelques aspérités sur des types de problèmes très volumineux ou inhabituels.
Pour les équipes sans spécialiste ML en interne, Plexe fonctionne comme un outil de modèles prédictifs qui prend en charge le gros du travail, mais il ne sauvera pas un projet où le vrai problème, ce sont les données elles-mêmes.
Pour commencer
- Installez la bibliothèque open source avec
pip install plexe, ou inscrivez-vous sur la plateforme hébergée sur console.plexe.ai si vous préférez éviter toute configuration d'infrastructure. - Connectez un jeu de données sous forme de DataFrame Pandas (bibliothèque) ou importez-le via l'interface et l'API de la plateforme.
- Décrivez votre objectif en langage naturel et, si vous le souhaitez, définissez les schémas d'entrée et de sortie pour que le modèle sache exactement à quoi s'attendre.
- Indiquez à Plexe votre fournisseur de LLM préféré pour que le système d'agents puisse planifier et générer du code.
- Laissez l'agent construire et évaluer le modèle, puis exportez-le pour l'inférence ou déployez-le dans votre propre produit.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Plexe.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Les développeurs et les data scientists qui veulent éviter le code d'entraînement répétitif et arriver plus vite à un modèle qui fonctionne.
- Les équipes produit et les analystes qui ont besoin de prédictions dans une application mais qui n'ont pas d'ingénieur ML dédié.
- Les fondateurs qui mènent des expériences précoces et veulent tester une idée de modélisation avant d'engager de vraies ressources.
Tâches
- Construire des modèles prédictifs tabulaires comme des scores de résiliation, des prévisions de prix ou du scoring de prospects à partir d'un jeu de données existant.
- Prototyper rapidement une idée de classification ou de régression pour voir si les données la soutiennent ou non.
- Générer un code d'entraînement propre et documenté que vous pouvez relire et remettre à votre propre équipe d'ingénierie. Fini les scripts mystérieux.
Cas d'usage
- Une petite startup avec un tableur d'historique client qui veut un modèle de résiliation sans recruter un spécialiste ML.
- Une équipe d'outils internes qui a besoin d'un point d'accès de prédiction léger intégré à un produit pour le prochain sprint.
- Une recherche précoce où vous voulez comparer plusieurs approches en un après-midi plutôt qu'en une semaine. Résultats rapides. Risque faible.
Fonctionnalités clés
Création de modèles en langage naturel
Vous décrivez le résultat souhaité en mots simples et le système d'agents de Plexe détermine la stratégie de modélisation. Aucun algorithme à choisir. Aucune boucle d'entraînement à écrire. L'agent lit votre intention et vos données, puis construit dans cette direction.
Pipeline multi-agents
Sous le capot, une séquence d'agents gère la planification, la génération de code, l'exécution et l'affinage. Chaque étape alimente la suivante et le système itère sur les résultats jusqu'à ce que les performances cessent de s'améliorer. Vous obtenez un modèle qui fonctionne sans toucher à presque rien en interne. C'est dans cette boucle que se trouve le gain de temps.
Bibliothèque Python open source
La bibliothèque plexe s'installe avec une seule commande pip et s'intègre directement à du code Python existant. Vous contrôlez votre propre puissance de calcul et vos données, et vous apportez les identifiants de votre fournisseur de LLM. C'est la voie pour les équipes qui veulent un contrôle maximal. Simple comme ça.
Plateforme hébergée gérée
Si vous préférez ne pas gérer d'infrastructure, la plateforme hébergée sur console.plexe.ai propose une interface web et une REST API avec mise à l'échelle intégrée et facturation simplifiée. Elle convient aux équipes produit qui veulent du ML de niveau entreprise sans la charge des opérations, et elle vous permet de passer d'une idée à un point d'accès en production sans provisionner le moindre serveur vous-même.
Contrôle des schémas et des jeux de données
Vous pouvez définir les entrées et sorties attendues avec des modèles Pydantic ou de simples dictionnaires, et alimenter les données d'entraînement via des DataFrames Pandas ou un générateur de jeux de données. Des schémas précis gardent le modèle généré aligné sur ce dont votre application a réellement besoin. Cet alignement compte plus qu'on ne l'imagine.
Transparence totale du code
Chaque modèle produit par Plexe est propre, documenté et lisible. Vous pouvez ouvrir le code généré, le comprendre et le personnaliser. Rien ne se cache derrière une boîte noire, ce qui compte quand un modèle doit passer une revue interne.
Déploiement et inférence
Plexe empaquette le modèle entraîné pour l'inférence ou le déploie dans votre infrastructure de production. Les modèles peuvent être enregistrés sur disque et rechargés plus tard, donc vous n'êtes pas obligé de tout reconstruire à chaque fois. Cela transforme un prototype en quelque chose que vous pouvez réellement livrer.
Avantages et inconvénients
Avantages
- L'entrée en langage naturel élimine la partie la plus raide de la courbe d'apprentissage du ML, donc les non-spécialistes peuvent produire de vrais modèles.
- Le cœur open source signifie que le code vous appartient et que vous pouvez inspecter ou modifier tout ce que l'agent génère.
- Deux voies de déploiement (bibliothèque Python et plateforme gérée) vous laissent échanger du contrôle contre de la commodité.
- Compatible avec des frameworks courants, donc la sortie s'intègre aux outils que votre équipe utilise déjà.
Inconvénients
- La tarification de la plateforme hébergée n'est pas publiée, donc vous devez contacter l'équipe pour des devis entreprise. Ennuyeux si vous voulez un chiffre tout de suite.
- Les résultats dépendent fortement de la qualité des données ; des entrées désordonnées produisent toujours des modèles faibles, et il ne corrigera pas ça pour vous.
- C'est un produit à un stade précoce, donc des problèmes de niche ou particulièrement complexes peuvent rencontrer des aspérités.
Questions fréquentes
Il crée des modèles de machine learning à partir de descriptions en langage naturel. Vous fournissez des données et un objectif, et son système d'agents planifie, écrit, entraîne et déploie le modèle pour vous. Voilà tout le produit en une phrase.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Plexe.
Alternatives à Plexe
Forefront
Forefront · ProgrammationForefront est une plateforme web pour construire avec de l'IA open source. Elle vous laisse affiner les principaux modèles de langage open source sur vos propres données, évaluer leurs performances et les exécuter via une API ou les exporter pour les héberger vous-même. Les développeurs qui veulent le confort d'une plateforme fermée mais tiennent à rester propriétaires de leurs modèles et de leurs données sont le public visé ici.

Startkit
StartKit.AI · ProgrammationStartkit est un boilerplate pour créer des produits SaaS d'IA et des wrappers d'IA. Voyez-le comme un boilerplate de startup IA avec les parties ennuyeuses déjà branchées : authentification, paiements Stripe et Lemon Squeezy, limites d'usage, e-mail transactionnel et un kit de démarrage d'API IA qui parle à OpenAI, Anthropic, Groq ou Llama. Vous clonez le dépôt, fixez votre prix et attaquez la partie du produit pour laquelle les gens paient vraiment. Il repose sur Next.js au-dessus de React et Tailwind, donc une bonne partie du code boilerplate vous semble déjà familière.
Testim
Tricentis · ProgrammationTestim est une plateforme d'automatisation des tests dopée à l'IA, qui sert à créer et exécuter des tests de bout en bout sur des applications web, mobiles et Salesforce. Elle s'appuie sur l'apprentissage automatique pour garder les tests stables quand une interface change, alors les équipes passent moins de temps à réparer des sélecteurs cassés. Pas mal pour un outil de tests automatisés que vous pouvez utiliser dès aujourd'hui. Vous créez des tests en enregistrant des actions dans un navigateur, puis vous ajoutez du JavaScript quand vous avez besoin de plus de contrôle. C'est un choix solide pour une équipe QA bien occupée.