
Polarity
Polarity · Programmation
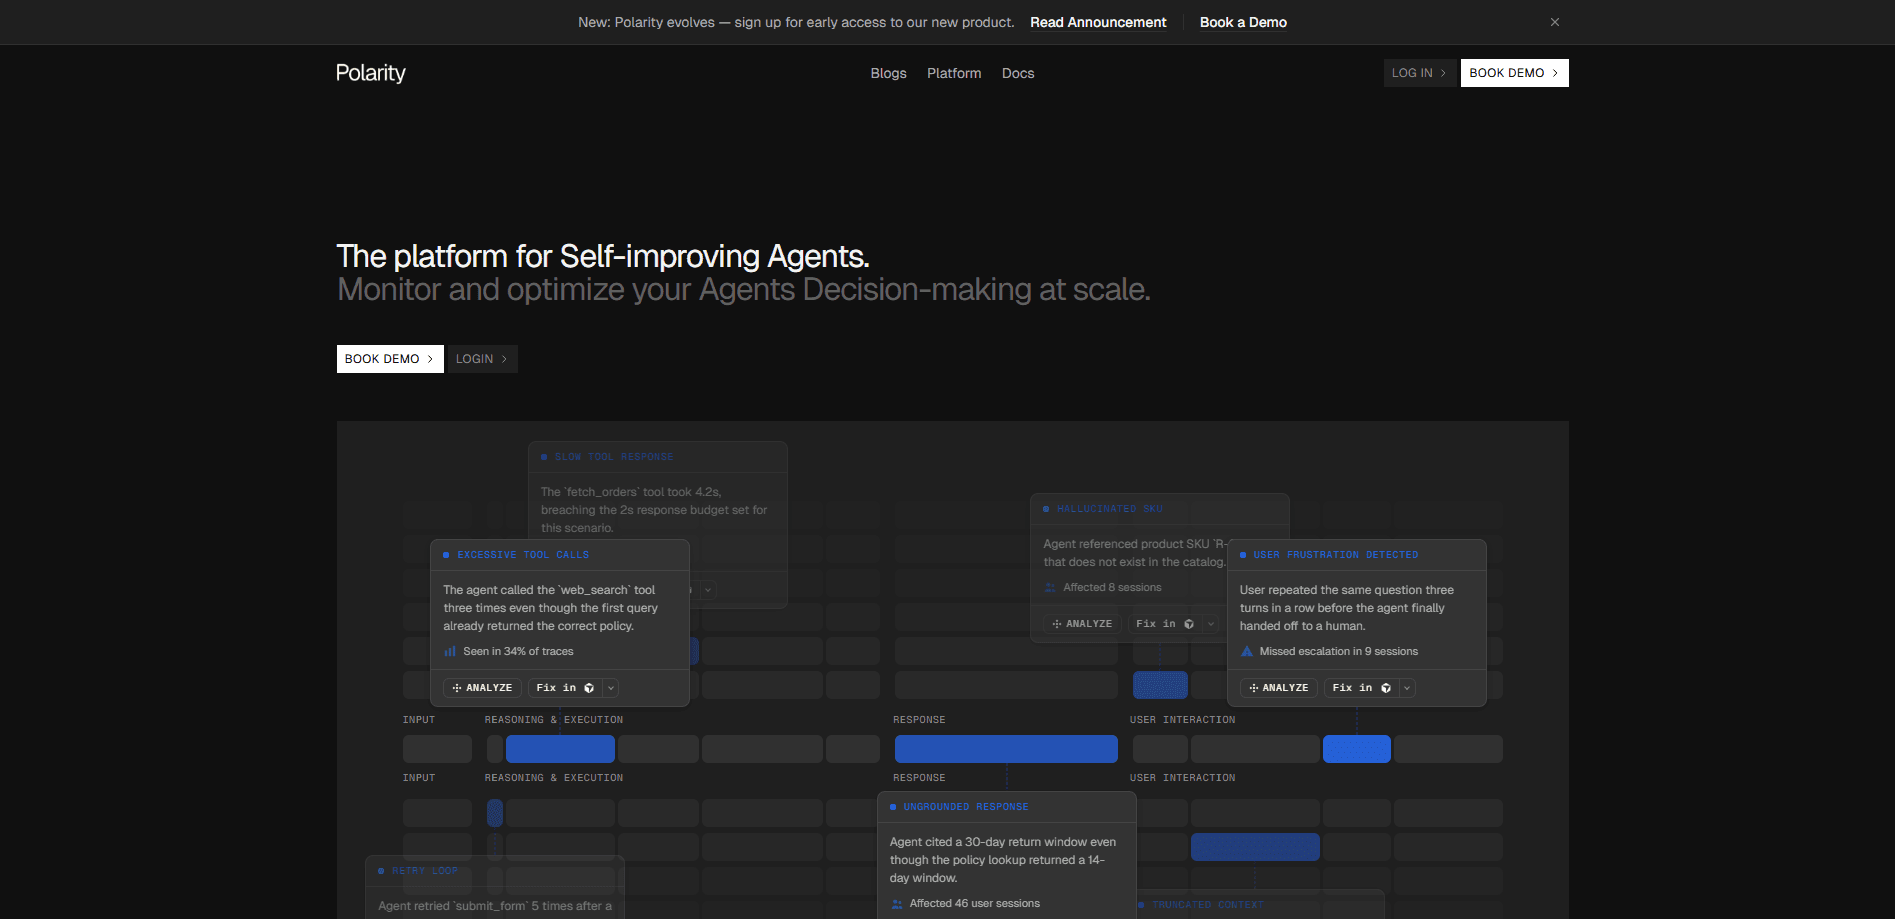
Polarity est une plateforme d'évaluation et de suivi en bac à sable pour les agents IA. Elle exécute votre agent dans des environnements Docker isolés reliés à de vrais services de support, note ce que l'agent fait par rapport à des invariants et des règles interdites, et mesure à quel point son comportement varie d'une exécution à l'autre. Voyez-la comme un outil d'évaluation d'agents qui prend le comportement réel pour le test. Quand une exécution échoue, le rejeu basé sur une graine vous permet de reconstruire les conditions exactes et de déboguer l'échec au lieu de deviner.
À propos de Polarity
Qu'est-ce que Polarity
Polarity est une plateforme d'évaluation conçue pour les équipes qui mettent des agents IA en production. Au lieu de tester les agents contre une maquette scénarisée, elle les exécute dans un environnement Docker en bac à sable relié à de vrais services de support, si bien que l'agent voit les mêmes API, bases de données et outils qu'il toucherait en production. Cette configuration compte, car la plupart des défaillances d'un agent ne viennent pas d'une mauvaise réponse. Elles viennent du fait que l'agent prend une action que personne ne voulait.
La plateforme vérifie deux choses en même temps. D'abord, si chaque exécution respecte les règles que vous avez fixées, que Polarity sépare en invariants qui doivent toujours tenir et en règles interdites qui ne doivent jamais se déclencher. Ensuite, à quel point le comportement est stable. Lancer la même tâche sur plusieurs réplicas fait apparaître la non-détermination qu'une seule passe masquerait complètement. Et cette distinction compte, car un agent qui réussit une exécution et échoue la suivante est du genre à casser la production en silence bien après que tout le monde a cessé de le surveiller.
La principale limite, c'est la portée. Polarity est un outil pour développeurs, pas une application grand public, donc il vous faut un agent empaqueté et des services de support accessibles depuis le bac à sable avant d'en tirer quoi que ce soit. Les équipes sans tests automatisés passeront leurs premiers jours à tout câbler.
Pour commencer
- Connectez-vous sur le site de Polarity et créez un projet pour l'agent que vous voulez évaluer.
- Pointez le projet vers votre agent et définissez les services de support dont il a besoin, pour que le bac à sable démarre avec les mêmes dépendances qu'en production.
- Rédigez vos invariants et vos règles interdites comme les contrôles sur lesquels chaque exécution est notée.
- Lancez une tâche sur un ou plusieurs réplicas pour voir si le comportement reste stable ou dérive entre les tentatives.
- Ouvrez n'importe quel échec, rejouez-le depuis sa graine et corrigez la cause racine avant de livrer.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Polarity.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Équipes d'ingénierie IA
- Ingénieurs plateforme et infrastructure
- Responsables QA et fiabilité
Tâches
- Noter le comportement de l'agent
- Repérer la non-détermination
- Déboguer les échecs
- Tests de régression d'agents avant livraison
Cas d'usage
- Mettre un nouvel agent en production
- Déboguer un échec intermittent de l'agent
- Auditer un agent après un changement de modèle
Fonctionnalités clés
Exécutions en bac à sable avec de vrais services
Polarity exécute chaque tâche de l'agent dans un bac à sable Docker pour agents IA plutôt que dans un banc de test simulé. Le bac à sable est relié à de vrais services de support, donc l'agent interagit avec des API et des bases de données authentiques pendant l'évaluation. Le comportement que vous notez se rapproche donc de ce que les utilisateurs vivront réellement.
Notation par invariants et règles interdites
Chaque exécution est évaluée selon deux types de règles. Les invariants décrivent des conditions qui doivent tenir à chaque exécution, tandis que les règles interdites nomment les actions qui ne doivent jamais se produire. Les écrire oblige une équipe à s'accorder sur ce que signifie « correct », ce qui est souvent le plus difficile.
Mesure de la non-détermination
Les agents ne se comportent pas de façon identique à chaque fois, et une seule exécution réussie prouve bien peu. Polarity lance la même tâche sur plusieurs réplicas et compare les résultats, ce qui montre à quel point l'agent dérive entre les tentatives. Une variance élevée est souvent le premier signe d'un prompt fragile ou d'un outil instable.
Rejeu basé sur une graine
Quand une exécution échoue, Polarity peut la rejouer depuis sa graine d'origine. Le rejeu reconstruit les mêmes conditions qui ont produit l'échec, ce qui transforme un bug intermittent en quelque chose que vous pouvez inspecter, corriger et vérifier. Pour les équipes habituées à traquer les agents instables à la main, c'est la fonctionnalité qui fait gagner le plus de temps.
Suivi pour les agents en production
L'évaluation ne s'arrête pas à la revue de code. Polarity assure aussi le suivi d'agents IA une fois qu'ils tournent, en notant le comportement réel par rapport aux mêmes règles que celles utilisées en test. Vous repérez une violation de règle en production au lieu d'en entendre parler par un utilisateur.
Avantages et inconvénients
Avantages
- De vrais services dans le bac à sable font que les notes reflètent le comportement en production, pas une maquette simplifiée.
- La notation par invariants et règles interdites donne une définition claire et testable du comportement correct.
- Les exécutions sur réplicas rendent la non-détermination visible, ce que la plupart des outils d'évaluation à passe unique manquent.
- Le rejeu basé sur une graine raccourcit la boucle de débogage des échecs intermittents.
- Le suivi étend le même jeu de règles du test jusqu'à la production.
Inconvénients
- Pas d'offre gratuite, et les tarifs ne sont pas publiés, donc il faut parler au service commercial avant de pouvoir juger le coût.
- C'est un outil pour développeurs, donc en tirer de la valeur suppose que votre agent et ses services soient déjà empaquetés pour tourner dans un bac à sable.
- Stocker et exécuter de vrais services de support augmente l'effort de configuration et le coût d'infrastructure par rapport aux outils d'évaluation basés sur des maquettes.
- Pas idéal pour les équipes qui veulent juste une démo rapide. Polarity part du principe que vous testez déjà.
Questions fréquentes
Elle évalue et suit les agents IA. Vous définissez des règles, Polarity exécute votre agent dans un environnement Docker en bac à sable avec de vrais services, note chaque exécution selon ces règles et vous laisse rejouer les échecs. Alors, qu'est-ce que cela vous apporte ? Moins de surprises quand l'agent passe en production.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Polarity.
Alternatives à Polarity
Forefront
Forefront · ProgrammationForefront est une plateforme web pour construire avec de l'IA open source. Elle vous laisse affiner les principaux modèles de langage open source sur vos propres données, évaluer leurs performances et les exécuter via une API ou les exporter pour les héberger vous-même. Les développeurs qui veulent le confort d'une plateforme fermée mais tiennent à rester propriétaires de leurs modèles et de leurs données sont le public visé ici.

Startkit
StartKit.AI · ProgrammationStartkit est un boilerplate pour créer des produits SaaS d'IA et des wrappers d'IA. Voyez-le comme un boilerplate de startup IA avec les parties ennuyeuses déjà branchées : authentification, paiements Stripe et Lemon Squeezy, limites d'usage, e-mail transactionnel et un kit de démarrage d'API IA qui parle à OpenAI, Anthropic, Groq ou Llama. Vous clonez le dépôt, fixez votre prix et attaquez la partie du produit pour laquelle les gens paient vraiment. Il repose sur Next.js au-dessus de React et Tailwind, donc une bonne partie du code boilerplate vous semble déjà familière.
Testim
Tricentis · ProgrammationTestim est une plateforme d'automatisation des tests dopée à l'IA, qui sert à créer et exécuter des tests de bout en bout sur des applications web, mobiles et Salesforce. Elle s'appuie sur l'apprentissage automatique pour garder les tests stables quand une interface change, alors les équipes passent moins de temps à réparer des sélecteurs cassés. Pas mal pour un outil de tests automatisés que vous pouvez utiliser dès aujourd'hui. Vous créez des tests en enregistrant des actions dans un navigateur, puis vous ajoutez du JavaScript quand vous avez besoin de plus de contrôle. C'est un choix solide pour une équipe QA bien occupée.