
Pulse for Elasticsearch and OpenSearch
NeverBlink · Programmation · Autres
Pulse for Elasticsearch and OpenSearch est une plateforme IA de NeverBlink qui surveille vos clusters, signale les requêtes lentes et le gaspillage, et vous remet les correctifs.
À propos de Pulse for Elasticsearch and OpenSearch
About
Qu'est-ce que Pulse for Elasticsearch and OpenSearch
Pulse est un outil de supervision et d'optimisation pour les équipes qui exploitent Elasticsearch ou OpenSearch. Plutôt que de vous laisser lire des tableaux de bord en devinant, il inspecte vos clusters sans relâche et vous dit ce qui est lent, ce qui gaspille et ce qui est sur le point de casser. Chaque recommandation s'accompagne du raisonnement qui la justifie, si bien que votre équipe d'ingénierie garde la main sur ce qui est appliqué.
Le problème qu'il attaque, c'est la taxe silencieuse de l'exploitation de clusters de recherche à grande échelle : requêtes lentes, factures cloud qui s'envolent et alertes à deux heures du matin. Cette expertise est rare et difficile à garder en interne, et la tâche se corse à mesure que les agents IA livrent requêtes et schémas à la vitesse d'une machine. Pulse se branche sur ce que vous exploitez déjà au lieu de le remplacer, et il cohabite avec des outils comme Grafana et Datadog en ajoutant une analyse des causes racines propre aux bases de données que ces outils ne voient pas.
Les limites méritent d'être connues d'emblée. Pulse ne lit que les métriques et les métadonnées, il ne peut donc pas inspecter le contenu de vos documents. Il recommande des changements au lieu de les appliquer tout seul, ce qui suppose qu'une personne de votre équipe agisse dessus. Et la prise en charge complète se concentre aujourd'hui sur Elasticsearch et OpenSearch, ClickHouse et PostgreSQL restant en bêta privée.
Getting Started
- Connectez vos clusters via un collecteur léger qui tourne dans votre environnement, sans rien installer sur les serveurs de base de données eux-mêmes
- Laissez la plateforme lire les métriques, les journaux, les requêtes et la configuration pour dresser un portrait de la santé de chaque cluster
- Passez en revue les recommandations hiérarchisées sur les index, les projections et les réécritures de requêtes, chacune avec son raisonnement
- Décidez ce qu'il faut appliquer et quand, puis suivez les résultats sur le tableau de bord
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Pulse for Elasticsearch and OpenSearch.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Ingénieurs plateforme
- Équipes SRE
- Ingénieurs données
- Responsables d'ingénierie
- Créateurs d'agents IA
Tâches
- Réduire le coût du cluster
- Déboguer les requêtes lentes
- Évaluer la santé du cluster
- Prévenir les incidents
- Revoir les mappings d'index
- Alimenter les agents
Cas d'usage
- Une équipe plateforme avec des dizaines de clusters
- Une équipe face à une facture cloud inattendue
- Une panne de recherche à une heure ingrate
- Un flux de travail IA qui interroge des données réelles
- Une petite startup avec un seul cluster
Fonctionnalités clés
Évaluation continue de la santé du cluster
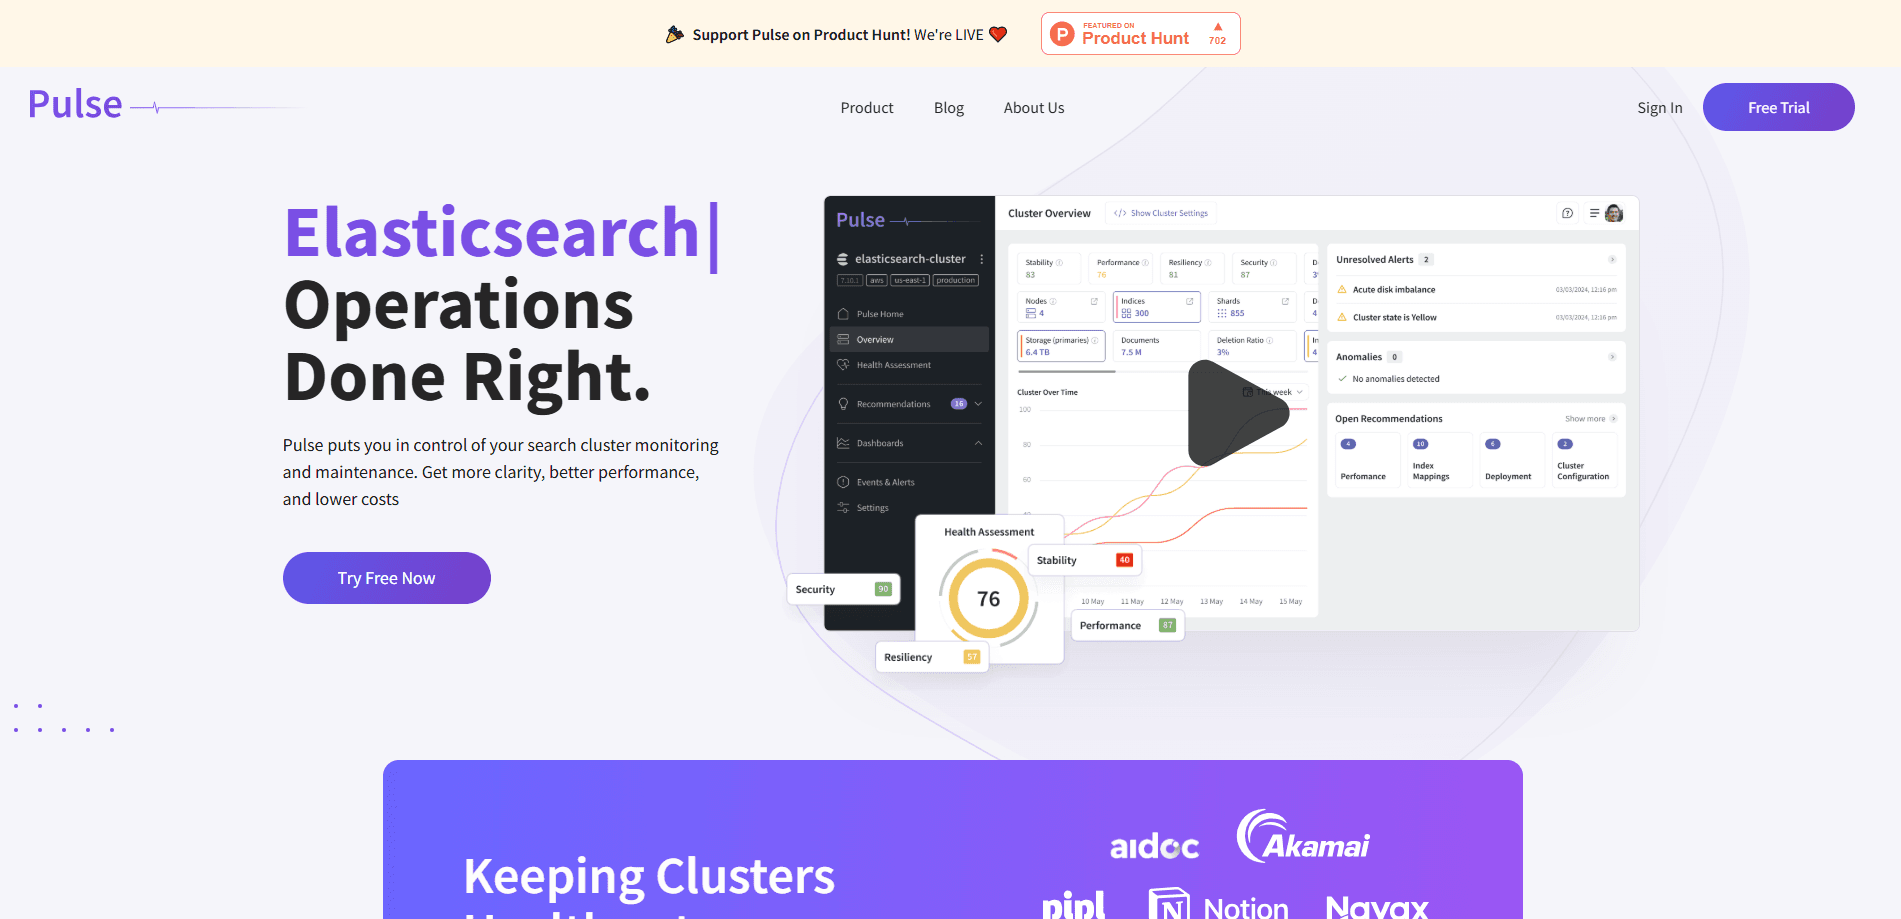
Pulse note la santé de chaque cluster qu'il surveille et garde cette note à jour au fil des changements. C'est par là que commence toute optimisation d'Elasticsearch ou d'OpenSearch en production. Vous voyez ce qui est stable et ce qui demande attention côte à côte, sans ouvrir une dizaine de consoles. C'est la différence entre chercher les problèmes et se les voir indiquer.
Analyse des requêtes qui désigne ce qui coûte cher
La plateforme trace les schémas de requêtes sur chaque cluster et les classe, puis fait remonter les requêtes lentes, coûteuses et redondantes derrière votre latence et votre coût. Vous obtenez la latence par requête, le nombre d'appels et l'usage des ressources, plus des recommandations concrètes sur les index, les projections et les réécritures. De quoi transformer un vague « c'est lent » en une correction précise.
Analyse automatisée des causes racines
Quand une alerte se déclenche, Pulse dépasse le signal brut et explique ce qui l'a probablement provoquée, avec les actions à mener. Il est conçu pour compléter des outils de supervision comme Grafana et Datadog plutôt que pour les remplacer, en ajoutant une analyse des causes racines propre aux bases de données que ces outils n'offrent pas. Le but est de réduire le temps entre un avertissement et un correctif.
Optimiseur de coûts
Pulse signale les choix qui gonflent votre facture cloud sans que vous le remarquiez, comme les nœuds surdimensionnés et les index qui coûtent plus qu'ils ne rapportent. L'optimisation des coûts fonctionne pour l'instant sur les déploiements cloud, donc les équipes sur infrastructure autogérée n'auront pas tous les signaux de coût. Même une revue trimestrielle peut s'autofinancer quand un cluster est surdimensionné.
Vue unique
Chaque base de données que vous exploitez se retrouve dans une seule vue, entre clusters, environnements et clouds, et vous pouvez les regrouper comme votre équipe les pense. La note de santé de chaque cluster et ses alertes actives figurent juste à côté. Pour qui jongle avec plusieurs consoles, cette consolidation est ce qui fait gagner le plus de temps.
API et serveur MCP pour les développeurs
Une API REST complète et un serveur MCP vous laissent brancher Pulse sur vos flux de travail, vos pipelines CI et vos outils. Vous pouvez le relier à Claude Code, Codex et Cursor pour que vos agents IA raisonnent sur la plateforme de données avec de vraies informations plutôt qu'avec des suppositions. Il crée aussi des tickets à partir des recommandations dans des systèmes comme GitHub et Jira.
Avantages et inconvénients
Avantages
- Ne lit que les métriques et les métadonnées, donc vos données réelles ne quittent jamais votre environnement
- Les recommandations viennent avec leur raisonnement, et votre équipe décide ce qu'il faut appliquer
- L'analyse des requêtes nomme les requêtes, les index et les mappings précis derrière la latence et le coût
- Une vue unique couvre tous les clusters entre clouds, environnements et équipes
- L'API REST et le serveur MCP permettent aux agents de code de travailler sur de vrais signaux
- Certification SOC 2 Type II, avec un collecteur qui n'installe rien sur les serveurs de base de données
Inconvénients
- Il recommande les changements au lieu de les appliquer, donc il faut encore quelqu'un pour agir dessus
- La prise en charge complète se concentre sur Elasticsearch et OpenSearch, ClickHouse et PostgreSQL restant en bêta privée
- L'optimiseur de coûts ne couvre que les déploiements cloud, donc les installations auto-hébergées ratent ces signaux
- Le tarif est facturé par cluster et par mois, ce qui s'accumule pour les équipes qui font tourner beaucoup de petits clusters
Questions fréquentes
C'est une plateforme de supervision et d'optimisation par IA pour les clusters Elasticsearch et OpenSearch, conçue par NeverBlink. Elle vérifie la santé du cluster, analyse les requêtes, trouve le gaspillage et vous remet des correctifs hiérarchisés avec le raisonnement de chacun.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Pulse for Elasticsearch and OpenSearch.
Alternatives à Pulse for Elasticsearch and OpenSearch

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.