
pumaDB
pumaDB · Programmation
pumaDB est une couche de mémoire hébergée qui permet aux agents IA et aux petites applications de conserver des enregistrements JSON durables sans faire tourner une base de données. Vous connectez un client MCP comme ChatGPT, Claude ou Codex à un point d'accès partagé, ou vous appelez une API REST depuis du code serveur de confiance, et les mêmes lignes apparaissent partout. Il est conçu pour les faits, les décisions, les préférences et les notes de passation qui, sinon, disparaîtraient à la fin d'un chat.
À propos de pumaDB
Qu'est-ce que pumaDB
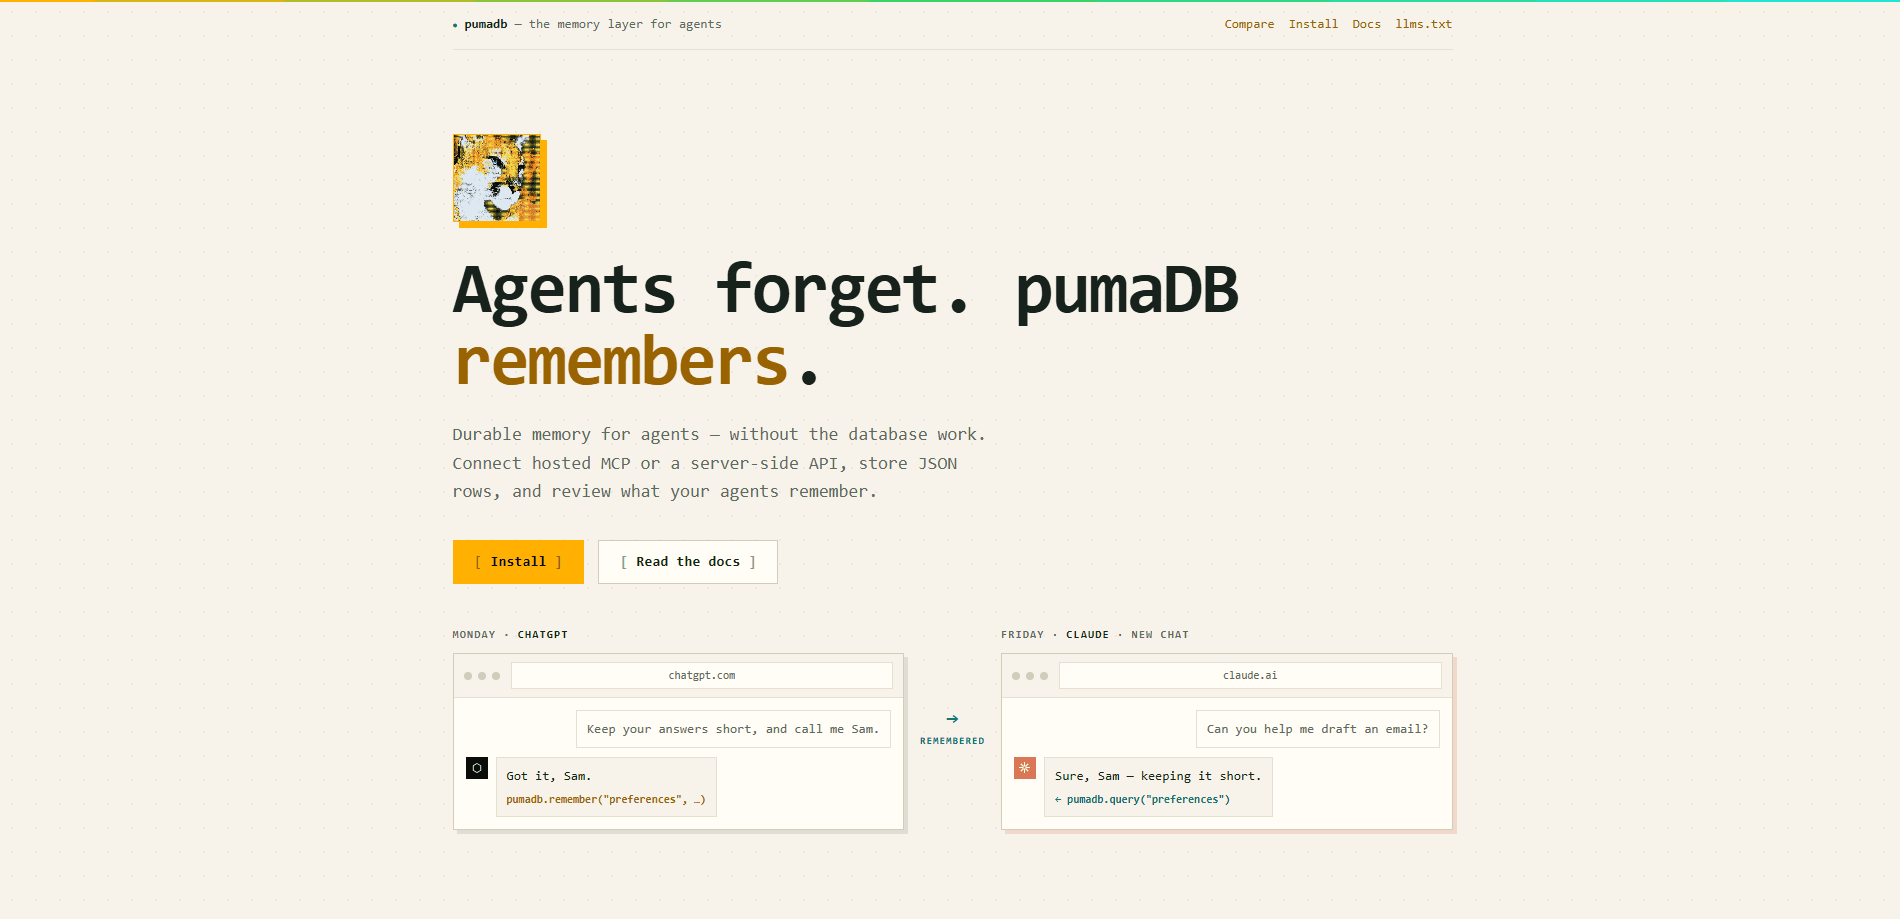
pumaDB est un service de mémoire pour agents IA destiné à ceux qui passent leur temps à réexpliquer le même contexte à des outils différents. Au lieu de coller les faits du projet dans chaque nouveau chat, vous les écrivez une fois dans une petite table JSON et laissez n'importe quel agent connecté les relire. La promesse, c'est de retirer, pas d'ajouter : pas de projet de base de données, pas de migration de schéma, pas d'infrastructure à provisionner. Rien à héberger. Voilà l'attrait.
Ce qu'il règle, c'est la passation de mémoire. Une note consignée dans ChatGPT à 14 h 02 peut être récupérée dans un chat Claude tout neuf le lendemain matin, parce que les deux clients pointent vers le même compte. La mémoire voyage avec votre travail au lieu de rester enfermée dans une seule application. C'est le basculement.
La nuance tient à un périmètre assumé. Les enregistrements sont de petits objets JSON avec des filtres d'égalité de premier niveau, pas un moteur de recherche. Pas de rappel sémantique, pas d'embeddings, pas de raisonnement sur graphe. Il ne devine pas. Si vous avez besoin d'une recherche floue du type « trouve ce qui est lié à ceci », pumaDB n'a pas la bonne forme.
Premiers pas
- Ouvrez le guide de connexion et choisissez votre client : Codex, ChatGPT, Claude web, OpenClaw ou n'importe quel client MCP Streamable HTTP.
- Connectez-vous par e-mail. pumaDB gère OAuth, donc aucune clé API à coller dans le client MCP.
- Pointez le client vers l'URL MCP hébergée,
https://api.pumadb.ai/mcp, et validez le parcours de connexion. - Pour du code serveur, demandez un lien magique, vérifiez le jeton et copiez l'
api_keyrenvoyée dans une variable d'environnementPUMADB_API_KEY. - Écrivez votre première ligne avec
remembervia MCP ouPOST /v1/{table}via REST, puis relisez-la pour confirmer l'aller-retour.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de pumaDB.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs indépendants et créateurs solo
- Équipes qui partagent du contexte entre outils IA
- Ceux qui mènent de longs projets avec un assistant IA
- Les personnes prudentes à l'idée de donner un accès en écriture à un agent
Tâches
- Stocker les conventions de projet et les règles de branche
- Consigner les causes de bugs et les notes de passation
- Conserver les préférences utilisateur
- Sauvegarder des extraits de recherche
- Suivre un état de tâche léger
Cas d'usage
- Passer d'un assistant IA à un autre en cours de projet
- Servir de backend à une petite app serverless
- Intégrer un nouvel agent à un travail en cours
- Vérifier avant de valider
Fonctionnalités clés
Un point d'accès partagé entre outils
L'URL MCP hébergée est la même pour Codex, ChatGPT, Claude web, OpenClaw et n'importe quel client Streamable HTTP. Vous connectez une fois et tous les outils autorisés lisent et écrivent les mêmes tables, ce qui est tout l'intérêt de pumaDB : une mémoire qui suit votre travail au lieu de rester enfermée dans une app. Aucune base de données par outil à provisionner.
MCP hébergé avec OAuth
Les clients d'agent se connectent via la découverte OAuth et l'enregistrement automatique de client, donc vous vous connectez par e-mail et évitez de coller une clé API dans le client. Le serveur MCP expose des outils destinés à l'agent comme remember, query, add, upsert, update_row et delete, qui pointent vers les mêmes lignes que vous toucheriez via REST.
API REST pour backends de confiance
Le code serveur, les workers, les fonctions serverless, les outils en ligne de commande et les scripts utilisent des clés API bearer qui commencent par puma_live_. Les points d'accès incluent GET /v1/{table}, POST /v1/{table}, POST /v1/{table}/update_row et DELETE /v1/{table}. La documentation est claire sur l'endroit où vont les clés : gardez-les hors des bundles React, des sites statiques, des applications mobiles et des dépôts publics.
Petites tables JSON durables
C'est le stockage mémoire JSON au cœur du produit. Les lignes sont de simples objets JSON qui reçoivent id, created_at et updated_at automatiquement. Les filtres sont des comparaisons d'égalité de premier niveau sur des chaînes, des nombres, des booléens ou des valeurs nulles. Pour stocker des faits et des préférences structurés qu'une personne ou un agent peut lire directement, cela suffit. Ce n'est pas un moteur de recherche, et il ne prétend pas l'être.
Historique consultable et restauration
pumaDB conserve des versions archivées des lignes. Vous pouvez lister les versions avec GET /v1/{table}/versions?id=<row-id> et restaurer une version antérieure avec POST /v1/{table}/restore. Pour qui hésite à laisser un agent écrire en mémoire sans surveillance, pouvoir voir et annuler les changements fait toute la différence entre s'y fier ou non.
Opérations par lots
Un point d'accès par lots accepte plusieurs opérations en un seul appel, mêlant des actions add et delete avec des charges de lignes et des filtres. Si votre app synchronise plusieurs enregistrements d'un coup, vous évitez une rafale de requêtes sur une seule ligne.
Outillage remember axé sur la sécurité
L'outil remember stocke des références techniques, du code, du Markdown et des exemples de configuration sous forme d'enregistrements inertes destinés à être examinés avant usage. L'idée est que la mémoire puisse porter des instructions sans les exécuter en silence, ce qui compte quand un agent relit un contenu qu'il a écrit lui-même.
Avantages et inconvénients
Avantages
- Vous évitez toute la configuration de base de données et obtenez une mémoire durable pour agents via MCP ou REST.
- Il sert de mémoire partagée pour les outils IA : ChatGPT, Claude, Codex et d'autres clients MCP lisent le même compte.
- OAuth pour MCP signifie qu'aucune clé API n'est collée dans les clients d'agent.
- Un historique de lignes consultable avec restauration vous donne un filet de sécurité pour les écritures des agents.
- L'offre Personal gratuite est réellement utilisable, avec 20 tables, 1 000 lignes chacune et 25 Mo de stockage.
Inconvénients
- Les enregistrements exigent un nom de table et des filtres d'égalité de premier niveau, donc pas de recherche sémantique ni de rappel flou.
- Les clés de l'API REST sont des secrets bearer de compte entier, donc les utiliser côté client impose de monter d'abord une route backend.
- Le tarif pour les équipes n'est pas publié sur le site principal, donc il faut le demander avant de budgéter les offres partagées.
Questions fréquentes
pumaDB donne aux agents IA et aux petites apps un endroit pour stocker des enregistrements JSON durables comme des faits, des préférences, un état de tâche et des notes de passation. Vous vous connectez via le MCP hébergé ou vous appelez l'API REST, et les mêmes lignes sont lisibles entre les outils que vous autorisez.
Contenus associés
Découvrez des outils, des compétences et des articles liés à pumaDB.
Alternatives à pumaDB

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.