

QAgent
QAgent Inc. · Programmation · Entreprise
QAgent est une plateforme d'assurance qualité automatisée pour les agents IA. Vous la pointez vers l'endpoint de votre agent, vous définissez la vérité de référence qu'il doit suivre, et elle lance des batteries de tests qui notent la qualité des réponses, le taux d'hallucination, le respect des règles et la mémoire multi-tours à chaque version. Elle fonctionne comme un outil d'évaluation de LLM que n'importe qui peut lancer en quelques minutes. Elle est pensée pour les développeurs solo et les petites équipes qui livrent des agents sans département QA dédié.
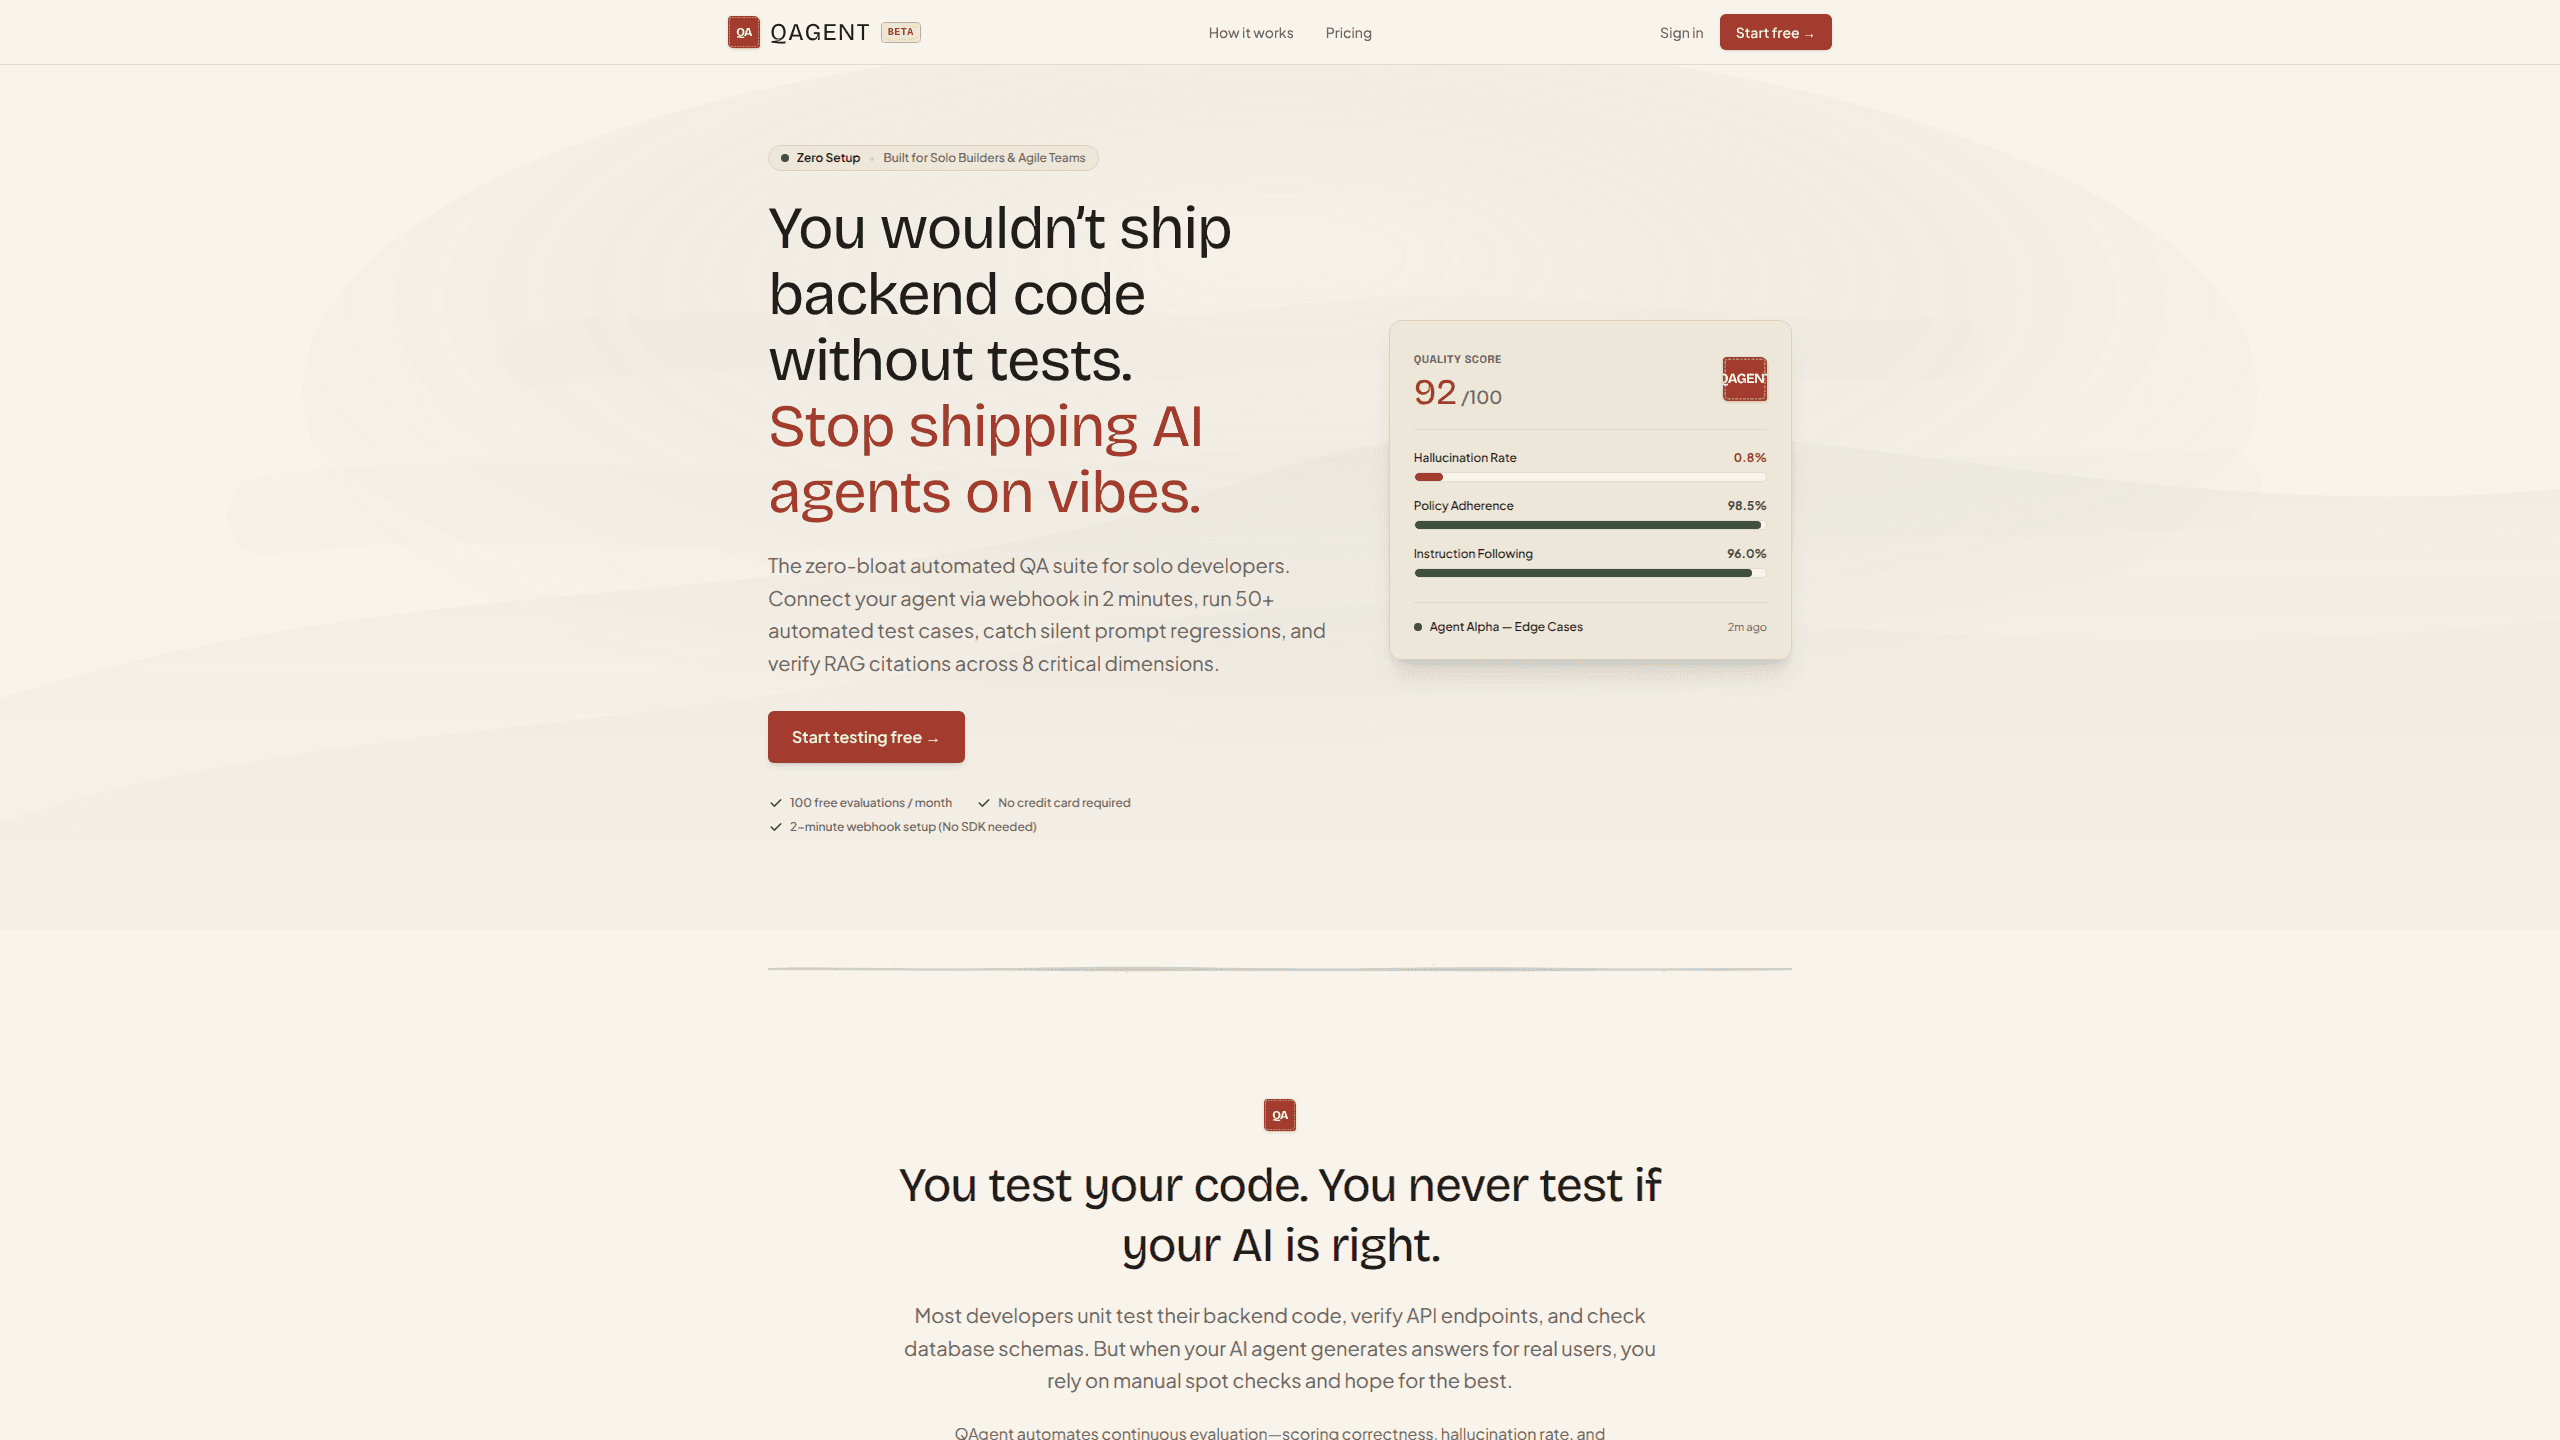
À propos de QAgent
Qu'est-ce que QAgent
QAgent est une plateforme de test basée sur le web qui répond à une question que la plupart des créateurs d'IA évitent : votre agent donne-t-il vraiment des réponses correctes ? Au lieu de lire quelques réponses dans un playground en espérant que tout se passe bien, vous connectez votre agent et laissez QAgent lancer la même série de contrôles après chaque changement de prompt.
Le produit vise un manque précis. Les développeurs testent unitairement le code du backend et vérifient les endpoints d'API, mais dès qu'un LLM génère une réponse pour un vrai utilisateur, les contrôles qualité se transforment en vérifications manuelles ponctuelles. C'est un problème. QAgent traite la sortie de l'agent comme quelque chose de testable et la note selon des règles que vous avez écrites, pas selon ce qui sonne convaincant sur le moment.
La principale limite tient à la portée. QAgent évalue la précision, la sécurité et la cohérence. Il ne corrige pas vos prompts à votre place, et sa notation vaut seulement ce que vaut la vérité de référence que vous lui fournissez. Écrivez de vraies règles. Si votre politique de remboursement ou vos paliers tarifaires ne sont pas définis, le juge n'a rien contre quoi comparer.
Premiers pas
- Créez un compte gratuit et connectez votre agent via un endpoint webhook, un workflow LangChain ou une simple cible HTTP POST.
- Définissez votre vérité de référence : paliers tarifaires, délais de remboursement, sujets interdits et tout document de connaissance que l'agent doit respecter.
- Écrivez des rubriques de test qui associent un prompt au comportement attendu, avec des règles claires de doit et ne doit pas.
- Lancez la batterie et examinez les notes de réussite ou d'échec, ainsi que les causes racines étape par étape de chaque échec.
- Branchez la même batterie sur votre flux de version pour que les modifications de prompt soient re-notées avant le déploiement.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de QAgent.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs solo
- Petites équipes sans recrutement QA
- Freelances et agences
Tâches
- Repérer les hallucinations
- Suivre les régressions de prompt
- Vérifier les citations RAG
- Tester la mémoire multi-tours
Cas d'usage
- Un ajustement de prompt tard le soir pour corriger le cas limite d'un client, suivi d'une exécution de régression complète en une minute environ.
- Livrer un chatbot IA à un client et joindre une carte de scores montrant l'ancrage factuel et le respect des règles.
- Conditionner le déploiement d'une version aux résultats d'une évaluation automatisée plutôt qu'à l'intuition.
- Tester des entrées adverses pour confirmer que l'agent escalade vers un humain au lieu de promettre des remises qu'il ne peut pas accorder.
Fonctionnalités clés
Huit dimensions d'évaluation
QAgent note les agents sur huit mesures distinctes plutôt qu'un seul score vague. Elles couvrent la qualité des réponses, l'ancrage factuel, le respect des règles, la justesse de l'escalade, la fidélité RAG, la pertinence contextuelle, le rappel de contexte et la mémoire multi-tours, et chaque dimension correspond à un vrai mode de défaillance en production. Ce détail compte. Un chiffre bas désigne un problème précis, pas une humeur générale.
Notation déterministe avec LLM comme juge
Au lieu de comparer des chaînes ou des motifs regex, QAgent interroge chaque réponse avec un modèle juge calibré. Il tourne sur des LPU Groq pour la vitesse, ce qui compte quand vous voulez une batterie de régression complète en moins d'une minute. Les verdicts de réussite et d'échec s'accompagnent d'un niveau de confiance, donc vous savez quand un résultat frôle la limite et mérite une relecture manuelle avant de vous y fier.
Système de vérité de référence et de rubriques
Chaque test combine trois ingrédients : vos règles officielles, le prompt de test avec le comportement attendu façon RFC 2119, et la réponse en direct de l'agent. Le juge vérifie strictement selon la rubrique. Une réponse polie mais fausse échoue quand même. C'est ce qui distingue QAgent d'une vérification au feeling dans une fenêtre de chat.
Exemptions intelligentes pour les faux positifs
Le juge fait la différence entre une hallucination et un comportement normal. Les identifiants de ticket qui changent à chaque session, les soldes en direct et les salutations polies ne sont pas signalés comme affirmations non étayées. Bien. Si l'extrait le mieux classé contient la réponse complète, les résultats moins bien classés ne tirent pas le score vers le bas. Les tests de jailbreak ne pénalisent pas le récupérateur pour l'absence de documents d'attaque.
Suivi des régressions de prompt
QAgent enregistre les écarts de score à chaque itération de prompt. Vous voyez immédiatement si un changement qui a corrigé un cas a provoqué une baisse ailleurs. C'est tout l'intérêt. Pour les équipes qui modifient souvent les prompts système, cela transforme une dégradation silencieuse en une ligne visible sur un graphique.
Rapports d'audit qualité
Le forfait Solo exporte des CSV et des rapports d'audit qualité prêts à imprimer. Ils montrent les pourcentages d'ancrage, la fidélité RAG et le respect des règles, ce qui est utile quand un client veut des preuves plutôt qu'une promesse. Envoyez le fichier. Les rapports transforment une exécution de test en quelque chose que vous pouvez joindre à la livraison d'un projet.
Avantages et inconvénients
Avantages
- La configuration par webhook prend environ deux minutes, sans SDK à installer ni code répétitif à écrire.
- Huit dimensions nommées donnent un retour précis plutôt qu'un score mélangé.
- L'offre gratuite de 100 évaluations par mois facilite l'essai avant de payer.
- Une piste d'audit transparente montre la requête, la rubrique, la réponse et les conclusions de l'évaluateur pour chaque test.
- Un prix mensuel fixe, sans engagement annuel ni appel commercial.
Inconvénients
- Un seul endpoint d'agent connecté avec l'offre gratuite, donc tester plusieurs agents exige le forfait payant.
- La notation dépend entièrement de la vérité de référence que vous fournissez ; des règles vagues produisent des résultats vagues.
- La plateforme est encore en bêta, donc les fonctionnalités et les limites peuvent évoluer.
Questions fréquentes
Il teste si votre agent IA donne des réponses correctes et conformes aux règles. Cela couvre la détection d'hallucination, le suivi des instructions, la fidélité RAG, le comportement d'escalade et la mémoire multi-tours, notés sur huit dimensions.
Contenus associés
Découvrez des outils, des compétences et des articles liés à QAgent.
Alternatives à QAgent

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.