
RAGaaS
RAGaaS · Programmation
RAGaaS est une API RAG managée qui privilégie la confidentialité: elle se branche sur votre stockage compatible S3, votre base vectorielle et vos clés de LLM, puis gère le découpage, les embeddings et la recherche.
À propos de RAGaaS
What Is RAGaaS
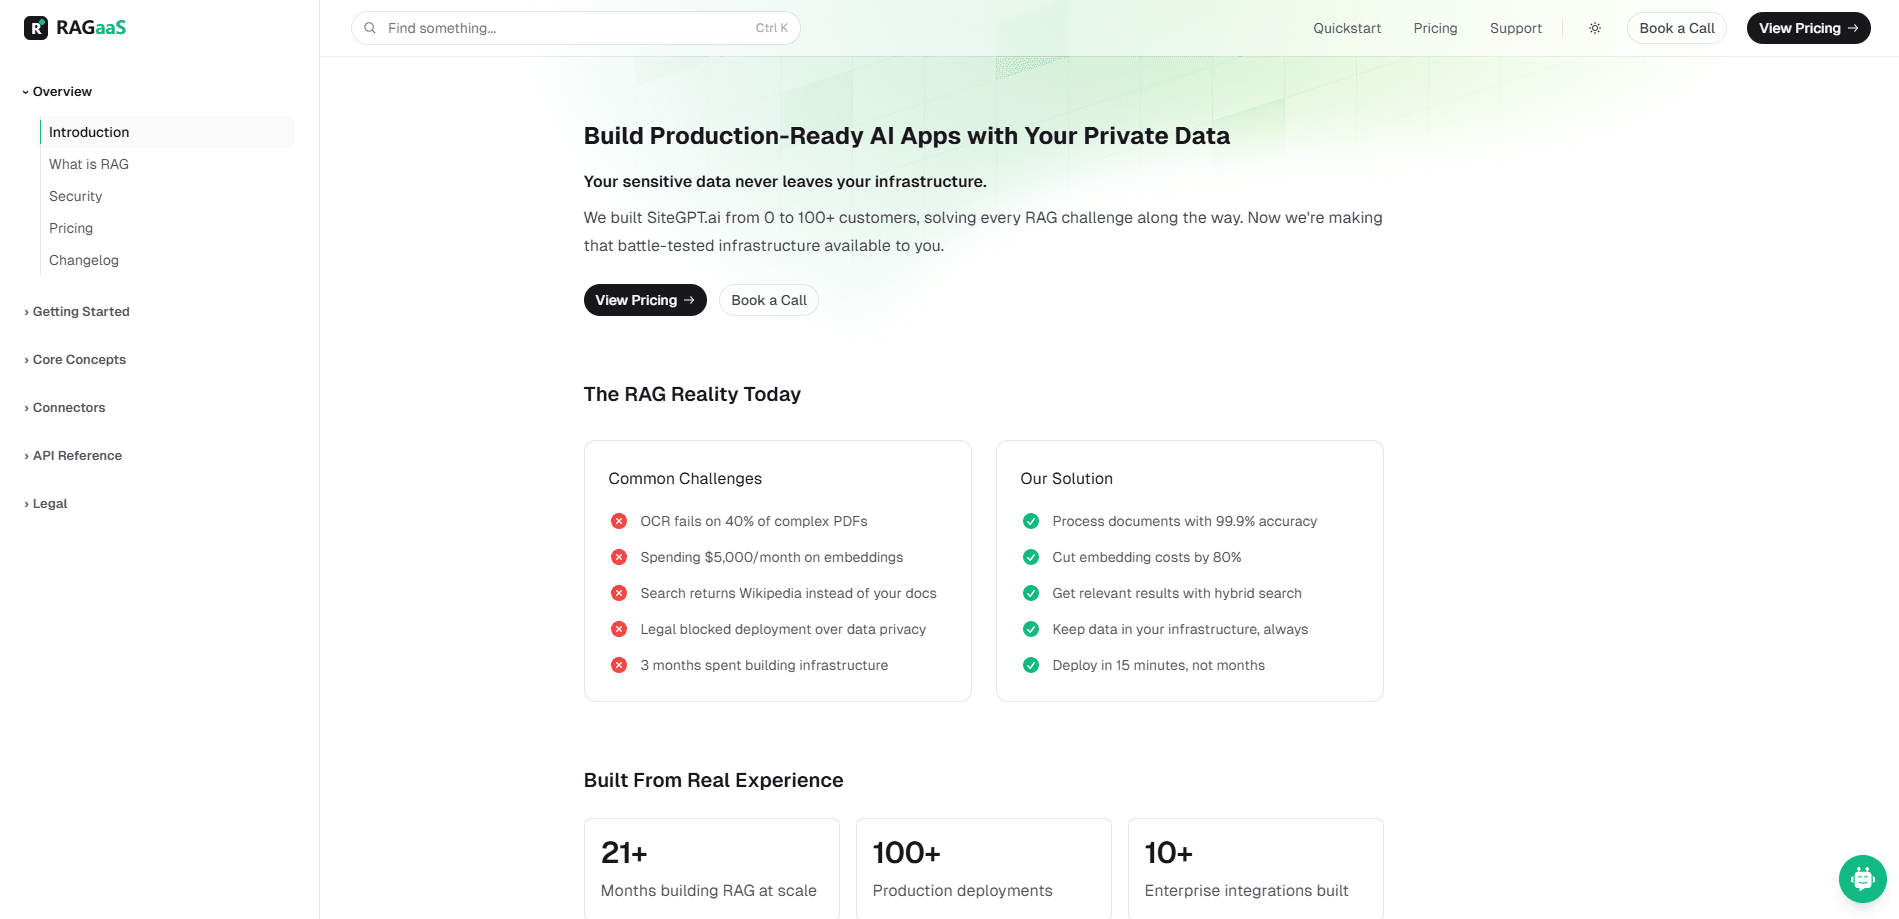
RAGaaS signifie Retrieval Augmented Generation as a Service, soit la génération augmentée par récupération proposée comme service. C'est une API managée avec laquelle une équipe construit une application RAG sans monter la plomberie en dessous. Vous lui indiquez où sont vos documents, et le service fait le gros du travail: il découpe le texte en morceaux, les transforme en embeddings, stocke les vecteurs et renvoie les passages pertinents quand une requête arrive.
Ce qui distingue RAGaaS de la plupart des plateformes de RAG en tant que service, c'est l'endroit où vivent vos données. Au lieu de copier vos documents dans le cloud d'un fournisseur, il s'appuie sur un stockage et des bases que vous contrôlez déjà. Vous apportez un bucket compatible S3, une base vectorielle et la clé de votre fournisseur de LLM, et le service les orchestre via une API réduite. L'éditeur présente cela comme une IA respectueuse de la vie privée: vos fichiers et vos identifiants restent sur votre compte.
Le revers de la médaille, c'est que RAGaaS suppose que vous êtes à l'aise avec l'infrastructure. Avant de lancer quoi que ce soit, il vous faut un bucket opérationnel, un index vectoriel et une clé d'API. Cela exclut les utilisateurs non techniques. La documentation publique reste par ailleurs limitée aujourd'hui, et le domaine d'origine ragaas.dev redirige désormais vers SiteGPT: mieux vaut donc confirmer auprès de l'éditeur que le produit est toujours proposé avant de bâtir dessus.
Getting Started
- Créez un compte et connectez un bucket de stockage compatible S3, l'endroit où vivront vos documents.
- Reliez une base vectorielle et ajoutez la clé d'API de votre fournisseur de LLM pour que le service génère et interroge les embeddings.
- Appelez le point d'accès de traitement pour ingérer des fichiers, ce qui déclenche le découpage et la génération d'embeddings.
- Envoyez vos requêtes de recherche via le second appel d'API pour récupérer des passages étayés à destination de votre LLM.
- Intégrez le contexte renvoyé à votre propre application ou modèle pour produire des réponses avec citations.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de RAGaaS.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Les ingénieurs backend et machine learning qui développent des fonctions RAG
- Les équipes soumises à des exigences strictes de localisation des données
- Les petites équipes produit sans spécialiste de l'infrastructure
Tâches
- Ingérer un ensemble de documents
- Ajouter une recherche sur des documents privés
- Changer le LLM d'une application RAG
Cas d'usage
- Une base de connaissances interne sur des fichiers confidentiels
- Un assistant support tenu de citer ses sources
- Un prototype qui a besoin de récupération rapidement
Fonctionnalités clés
Apportez votre propre stockage et votre base vectorielle
RAGaaS tourne sur une infrastructure qui vous appartient: un bucket compatible S3 pour les documents et une base vectorielle que vous contrôlez. Le service gère la liaison entre les deux plutôt que d'héberger vos données, ce qui constitue le cœur de son argumentaire sur la confidentialité et la raison de son attrait auprès des équipes réglementées.
Une API à deux appels pour traiter et chercher
La surface destinée au développeur est volontairement réduite. Un appel traite les documents, découpage et génération d'embeddings compris, et un second les interroge. Ceux qui décrivent le produit citent souvent ce flux à deux appels comme son principal atout, car il supprime le code de liaison qu'exige une pile RAG montée à la main.
Découpage et génération d'embeddings pris en charge
Le service découpe vos documents entrants en morceaux et les convertit en embeddings à votre place. C'est la partie que l'on sous-estime le plus, car la taille des morceaux et le choix du modèle d'embeddings déterminent la qualité de la récupération bien avant l'écriture du moindre prompt.
Optimisation de la recherche sur votre index
Une fois les documents convertis en embeddings, RAGaaS prend en charge la récupération et ajuste le classement des résultats face à une requête. Vous récupérez des passages pertinents plutôt que des correspondances vectorielles brutes, si bien que votre LLM reçoit un contexte vraiment exploitable.
Vos propres clés de LLM
Vous fournissez la clé du fournisseur du modèle, donc l'étape de génération s'exécute chez un fournisseur que vous avez choisi et que vous payez directement. Les coûts de modèle et les conditions du fournisseur restent sous votre contrôle au lieu d'être intégrés à un abonnement plateforme.
Une infrastructure entretenue
L'éditeur présente RAGaaS comme le responsable de l'entretien courant d'un pipeline RAG, comme garder les embeddings synchronisés avec les documents sources et faire monter la récupération en charge à mesure que le contenu grandit. Pour une petite équipe, cet entretien est souvent la raison de préférer un service managé à une solution auto-hébergée.
Avantages et inconvénients
Avantages
- Conserve les documents dans votre propre stockage compatible S3 et votre base vectorielle, ce qui aide lors des revues de localisation des données et de conformité.
- L'API est réduite, avec un appel pour traiter les documents et un autre pour les chercher, donc moins de travail d'intégration qu'avec un pipeline monté à la main.
- Vous fournissez votre propre clé de LLM, donc le choix du modèle et la dépense associée restent entre vos mains.
- Le découpage et la génération d'embeddings pris en charge vous épargnent la construction et le réglage de ce pipeline.
Inconvénients
- Suppose une configuration technique: il faut un bucket opérationnel, un index vectoriel et des clés de fournisseur avant de lancer quoi que ce soit, ce qui exclut les non-développeurs.
- La documentation publique est mince, ce qui rend difficile de confirmer à l'avance le comportement exact de l'API et ses limites.
- Le domaine d'origine ragaas.dev redirige désormais vers SiteGPT, donc on ne sait pas si le produit est encore maintenu, avec un risque d'enfermement dans un service sans feuille de route visible.
- Le prix n'est pas publié, donc impossible de comparer le coût d'usage à une pile auto-hébergée sans demander directement à l'éditeur.
Questions fréquentes
RAGaaS est une API managée de génération augmentée par récupération. Elle ingère vos documents, prend en charge le découpage et les embeddings, stocke les vecteurs dans une base que vous contrôlez et renvoie les passages pertinents à la recherche, pour que votre application réponde à partir de vos propres contenus.
Contenus associés
Découvrez des outils, des compétences et des articles liés à RAGaaS.
Alternatives à RAGaaS
Forefront
Forefront · ProgrammationForefront est une plateforme web pour construire avec de l'IA open source. Elle vous laisse affiner les principaux modèles de langage open source sur vos propres données, évaluer leurs performances et les exécuter via une API ou les exporter pour les héberger vous-même. Les développeurs qui veulent le confort d'une plateforme fermée mais tiennent à rester propriétaires de leurs modèles et de leurs données sont le public visé ici.

Startkit
StartKit.AI · ProgrammationStartkit est un boilerplate pour créer des produits SaaS d'IA et des wrappers d'IA. Voyez-le comme un boilerplate de startup IA avec les parties ennuyeuses déjà branchées : authentification, paiements Stripe et Lemon Squeezy, limites d'usage, e-mail transactionnel et un kit de démarrage d'API IA qui parle à OpenAI, Anthropic, Groq ou Llama. Vous clonez le dépôt, fixez votre prix et attaquez la partie du produit pour laquelle les gens paient vraiment. Il repose sur Next.js au-dessus de React et Tailwind, donc une bonne partie du code boilerplate vous semble déjà familière.
Testim
Tricentis · ProgrammationTestim est une plateforme d'automatisation des tests dopée à l'IA, qui sert à créer et exécuter des tests de bout en bout sur des applications web, mobiles et Salesforce. Elle s'appuie sur l'apprentissage automatique pour garder les tests stables quand une interface change, alors les équipes passent moins de temps à réparer des sélecteurs cassés. Pas mal pour un outil de tests automatisés que vous pouvez utiliser dès aujourd'hui. Vous créez des tests en enregistrant des actions dans un navigateur, puis vous ajoutez du JavaScript quand vous avez besoin de plus de contrôle. C'est un choix solide pour une équipe QA bien occupée.