
Reflection 70B
HyperWrite · Rédaction · Chatbot
Reflection 70B est un modèle à poids ouverts de HyperWrite. Bâti sur Llama 3.1 70B, ce LLM à autocorrection vérifie son propre raisonnement avant de répondre.
À propos de Reflection 70B
Qu'est-ce que Reflection 70B
Reflection 70B est un modèle de langage axé sur le raisonnement, signé HyperWrite, sorti début septembre 2024 et bâti sur Llama 3.1 70B Instruct de Meta. Son argument de vente est une méthode d'entraînement appelée Reflection-Tuning, qui apprend au modèle à repérer les erreurs dans sa propre chaîne de pensée et à les corriger avant de livrer une réponse finale. Le modèle écrit son raisonnement entre des balises <thinking> et sa réponse finale entre des balises <output>, et ajoute un bloc <reflection> chaque fois qu'il repère une erreur en cours de raisonnement.
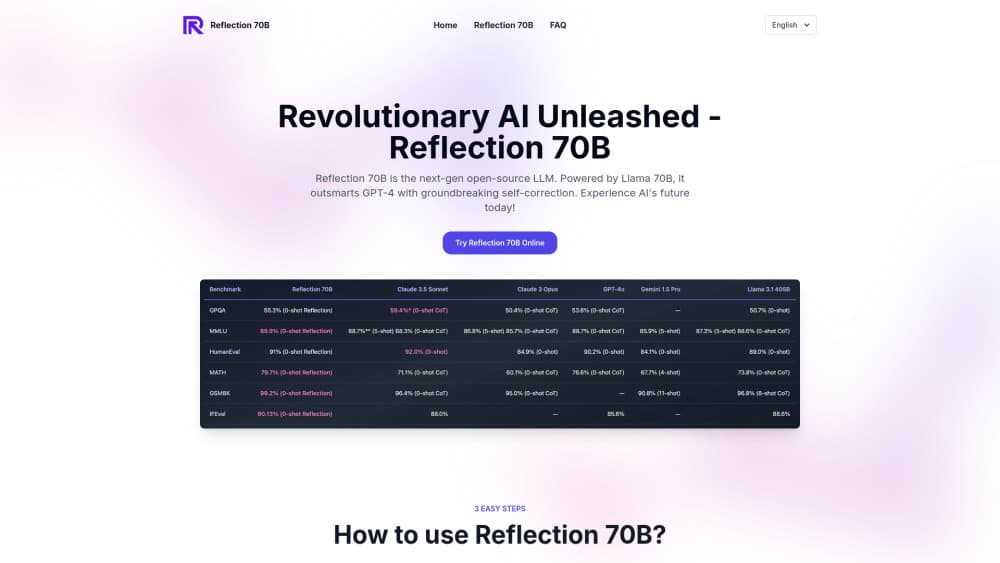
L'idée s'attaque à une frustration bien réelle. Les LLM classiques hallucinent. Ils remarquent rarement qu'ils le font. Reflection 70B a été entraîné à le remarquer. Selon HyperWrite, le modèle a battu GPT-4o et même Llama 3.1 405B sur des benchmarks comme MMLU, MATH, IFEval et GSM8K. Ces chiffres ont attiré une attention énorme au lancement.
Cet engouement initial n'a pas résisté au contact des tiers. Des évaluateurs indépendants, dont Artificial Analysis, n'ont pas pu reproduire les scores vedettes. Des tests ultérieurs ont montré que les versions publiées sur Hugging Face faisaient moins bien que le simple Llama 3.1 70B sur lequel le modèle était bâti. Certains utilisateurs ont aussi accusé l'API hébergée de rediriger discrètement les requêtes vers Claude. Matt Shumer, de HyperWrite, a reconnu que le modèle restait en dessous des benchmarks annoncés.
Le constat honnête est donc partagé. L'approche Reflection-Tuning est réellement intéressante. Le modèle tel qu'il a été livré n'a jamais égalé son propre marketing. Les sorties de modèles à poids ouverts comme celle-ci méritent encore l'étude, même quand le discours de lancement les survend.
Premiers pas
- Ouvrez la page du modèle sur Hugging Face (mattshumer/Reflection-70B) ou un miroir, et acceptez les termes de la licence.
- Téléchargez les poids, ou évitez l'installation locale et exécutez-le via un fournisseur d'inférence hébergé.
- Chargez-le avec le même code que pour n'importe quel modèle Llama, puisqu'il partage le template de chat de Llama.
- Envoyez-lui le message système de raisonnement pour qu'il renvoie, dans l'ordre, les sections de pensée, de réflexion et de réponse.
- Lisez les balises
<reflection>si vous voulez voir où le modèle a changé d'avis.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Reflection 70B.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Chercheurs en IA
- Développeurs qui bâtissent des outils de raisonnement locaux
- Passionnés curieux des prompts de réflexion
Tâches
- Problèmes de mathématiques et de logique
- Prototyper des pipelines d'autovérification
- Études comparatives
Cas d'usage
- Exécuter un modèle de raisonnement sans envoyer de données à une API fermée
- Étudier les pièges de l'évaluation
- Expérimenter des prompts de réflexion à petit budget
Fonctionnalités clés
Reflection-Tuning
Le Reflection-Tuning est la technique qui donne son nom au modèle. Au lieu de s'entraîner uniquement sur les réponses finales, il entraîne le modèle à relire son propre raisonnement et à le réviser en cours de génération. En pratique, le modèle produit un brouillon de sa pensée, le vérifie et réécrit les parties qu'il juge fausses avant de livrer une réponse. Cet ordre est toute l'idée : corriger, puis valider.
Balises structurées de pensée et de sortie
Le modèle sépare son travail interne de sa réponse à l'aide de tokens spéciaux. Le raisonnement se place entre des balises <thinking>, et la réponse finale entre des balises <output>. Cette séparation garde le travail préparatoire visible, ce qui est pratique pour déboguer la façon dont un modèle est arrivé à une conclusion, ou quand vous préférez masquer la pensée et n'afficher que la réponse.
Autocorrection en ligne
Quand le modèle repère une erreur, il émet un bloc <reflection> dans sa pensée. Vous pouvez lire ce bloc pour voir exactement où le raisonnement a tourné. Sur les tâches à réponse unique, ce virage visible est souvent plus utile que la réponse elle-même, car il montre le modèle rattrapant sa propre glissade plutôt que de l'enterrer.
Compatibilité Llama
Comme il s'appuie sur Llama 3.1 70B Instruct et conserve le format de chat standard de Llama, Reflection 70B s'insère dans les outils et pipelines qui prennent déjà en charge Llama. Si vous avez déjà déployé un modèle Llama, le code de chargement et la configuration de service se réutilisent avec peu de changements. Cette compatibilité explique pourquoi le modèle a été si facile à tester dès le départ.
Priorité au raisonnement de haute précision
Le modèle vise les tâches qui récompensent la précision plus que la vitesse, comme les mathématiques et la logique à plusieurs étapes. Il découpe le raisonnement en étapes distinctes et dépense plus de tokens à les revérifier. La contrepartie, c'est la latence. Les réponses arrivent plus tard et le coût en tokens grimpe, car réfléchir signifie écrire plus de texte avant d'obtenir la ligne finale.
Poids ouverts
Les poids sont disponibles publiquement : vous pouvez donc exécuter le modèle sur votre propre matériel, l'affiner ou étudier comment l'entraînement à la réflexion a changé son comportement. Les poids ouverts signifient aussi que vous n'êtes pas prisonnier du tarif ou des limites d'un seul fournisseur, ce qui compte si vous testez le modèle à n'importe quelle échelle.
Avantages et inconvénients
Avantages
- Des poids ouverts que vous pouvez télécharger, inspecter et auto-héberger
- Bâti sur Llama 3.1 70B, donc compatible avec l'outillage et les stacks de service Llama que vous avez déjà
- Une autocorrection visible via les balises de pensée, de réflexion et de sortie
- Gratuit en local, avec une inférence hébergée bon marché quand vous préférez ne pas gérer de GPU
Inconvénients
- Les benchmarks indépendants n'ont jamais confirmé les performances annoncées au lancement
- Certaines versions sur Hugging Face auraient scoré en dessous du simple Llama 3.1 70B
- Les longues étapes de pensée et de réflexion ajoutent de la latence et du coût en tokens
- L'API hébergée a suscité des accusations de redirection du trafic vers Claude, ce qui a nui à la confiance
Questions fréquentes
C'est un modèle de langage open source de HyperWrite, bâti sur Llama 3.1 70B Instruct, qui utilise une méthode d'entraînement appelée Reflection-Tuning pour vérifier et corriger son propre raisonnement avant de répondre.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Reflection 70B.
Alternatives à Reflection 70B

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

MePersona
MePersona, Inc. · Rédaction · Productivité · MarketingMePersona est une boîte de réception unifiée avec IA pensée pour les créateurs. Elle apprend votre style, rédige des réponses aux messages de vos fans sur 12 plateformes et n'envoie que ce que vous validez.

Fluence
Yay Software (Yannick Huchard) · Rédaction · Voix et langage · ProductivitéFluence est une application Android qui lit à voix haute vos PDF, EPUB, fichiers Word et articles web, suit la phrase prononcée et répond aux questions sur le texte sans quitter le téléphone.