
Reworkd AI
Reworkd · Programmation
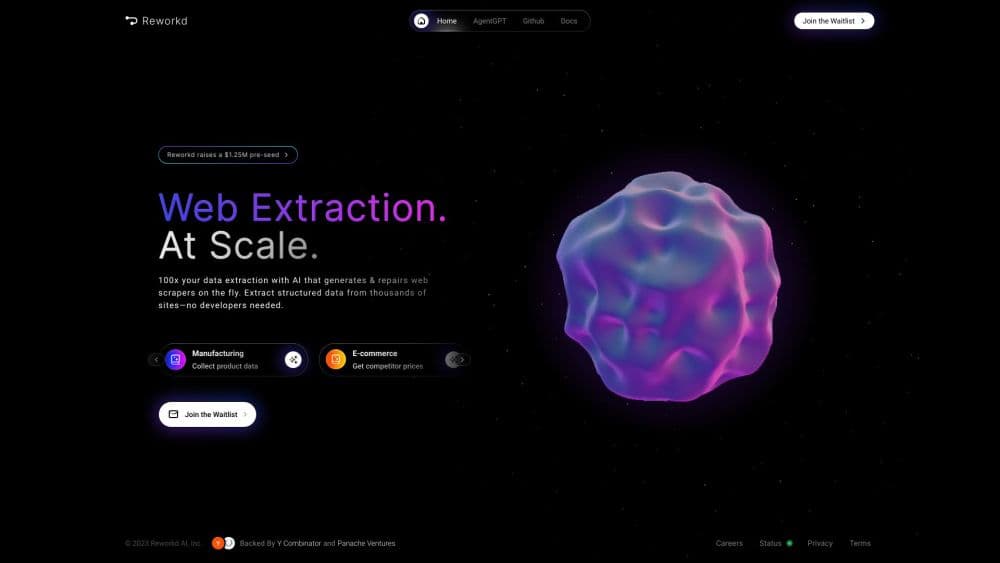
Reworkd AI est une plateforme de scraping web fondée sur des modèles de langage, qui créait et faisait tourner des scrapers à grande échelle et transformait les sites en données structurées. Fermée le 6 février 2025.
À propos de Reworkd AI
What Is Reworkd AI
Reworkd AI est une plateforme d'extraction de données web qui utilisait de grands modèles de langage pour créer des scrapers et sortir des données structurées des sites. Le scraping web par LLM fonctionnait ainsi : vous décriviez les champs voulus dans un schéma, et les agents se débrouillaient pour les collecter sur tout le site et ses sous-pages, sans sélecteurs écrits à la main. L'extraction de données web à cette échelle était justement l'objectif, et l'entreprise visait les équipes qui avaient besoin de données en volume, des catalogues produits aux tableaux de prix en passant par les avis.
Le discours portait sur l'ampleur. Reworkd affirmait que ses clients extrayaient des millions de lignes pour entraîner des modèles spécifiques à un domaine et alimenter des pipelines de données déjà en place, un travail qui demande d'ordinaire une équipe d'ingénieurs à maintenir des scrapers fragiles. Reworkd cherchait à réduire tout cela à un schéma plus une liste de sources.
Le point le plus important à connaître, c'est que le produit n'existe plus. Reworkd a annoncé qu'il arrêtait la plateforme le 6 février 2025 et a renvoyé les utilisateurs vers un contact pour la migration. L'équipe est aussi derrière AgentGPT, un projet d'agent autonome open source sur GitHub, et celui-là tourne encore. Le produit commercial de scraping, non. Cette différence compte si vous arrivez ici en espérant un outil opérationnel.
Getting Started
- Créez un compte et montez un groupe, le conteneur des URL que vous voulez scraper.
- Définissez un schéma, la liste structurée des champs que le scraper doit renvoyer.
- Ajoutez les URL sources au groupe. Chaque URL devient un job qui passe par des pages de catégorie, de liste puis de détail.
- Laissez le modèle construire et lancer le scraper. Les jobs mettent en file des pages filles au fil du crawl, et chaque exécution remonte son statut et ses résultats.
- Exportez les résultats par l'interface, l'API ou un export en masse, puis planifiez le groupe pour qu'il scrape de nouveau à intervalle régulier.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Reworkd AI.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Équipes data en startup
- Ingénieurs en machine learning
- Développeurs qui testent une idée
Tâches
- Constituer un catalogue produit depuis des sites marchands
- Collecter avis et notes en volume
- Alimenter un pipeline de données à intervalle régulier
- Enrichir un jeu de données existant
Cas d'usage
- Un sprint de recherche où il vous faut des centaines de milliers de lignes vite
- Garder un jeu de données interne à jour
- Évaluer le scraping par LLM avant de s'engager
Fonctionnalités clés
Scrapers générés par LLM
L'idée de base : vous décriviez les données voulues dans un schéma, et la plateforme générait le scraper, sans vous obliger à écrire des sélecteurs. Cela abaissait la barrière sur les sites au balisage changeant, où les sélecteurs CSS cassent dès qu'une refonte arrive. Pour une équipe sans ingénieur dédié au scraping, cela remplaçait des semaines de mise en place par un formulaire à remplir.
Groupes et jobs pilotés par schéma
Un groupe réunissait des URL sources qui partageaient un schéma et une fréquence de crawl. À l'intérieur, chaque URL devenait un job que la plateforme découpait en étapes : une page de catégorie, puis les pages de liste, puis celles de détail. Cette structure permettait à une seule définition de couvrir un site entier et ses sous-pages, donc passer de dix URL à dix mille n'obligeait pas à refaire le travail.
Crawl répété et planifié
Les groupes pouvaient être planifiés pour se relancer à intervalle défini, et c'est ce qui distinguait Reworkd d'un crawl unique. Les pipelines de données ont besoin d'enregistrements frais, et la planification transformait un scrape manuel en job récurrent. Les résultats revenaient sous forme de vue déjà dédupliquée, mise à jour à chaque nouvelle exécution du groupe.
Exports et API
Les données collectées sortaient de la plateforme par trois voies : des exports en masse via l'interface, une API pour récupérer les sorties par programme, et la prise en charge du téléchargement de fichiers en cours de scraping. L'API est ce qui rendait Reworkd utilisable dans un pipeline existant, plutôt qu'une destination à visiter. Les sorties étaient dédupliquées et matérialisées par groupe, donc le consommateur recevait une vue propre, pas des doublons bruts.
Gestion des sessions et des cookies
Certains sites cachent du contenu derrière un login ou gardent l'état dans des cookies et le stockage local. Reworkd exposait des points d'API pour lire et écrire ces cookies et ce stockage local, si bien que les scrapers atteignaient des pages qu'un client HTTP ordinaire ne toucherait jamais. Cela comptait pour tout ce qui est derrière un compte, et c'est une lacune fréquente dans les outils de scraping plus simples.
La pile technique sous-jacente
La plateforme reposait sur une architecture de streaming, et l'équipe a écrit publiquement sur la manière dont elle passait à l'échelle l'extraction temps réel avec l'IA agentique et le GenAI. Le cofondateur de Reworkd décrivait un traitement de téraoctets par jour tout en évitant les blocages, ce qui était la cible de conception. Cela vous dit que l'utilisateur visé était une équipe qui poussait un vrai volume, pas quelqu'un qui récupère un tableau une fois.
Avantages et inconvénients
Avantages
- La configuration par schéma évitait d'écrire des sélecteurs, donc des profils non techniques obtenaient un scraper fonctionnel.
- Un seul groupe couvrait de nombreux sites similaires, ce qui réduisait le coût d'extension entre boutiques ou annuaires.
- Le crawl planifié et les sorties dédupliquées convenaient à de vrais pipelines, pas à des crawls uniques.
- Les exports par API et la gestion des cookies permettaient de travailler sur des sites à accès restreint et dans des flux déjà en place.
- La couche gratuite laissait tester la qualité de la sortie avant de payer.
Inconvénients
- Le produit est arrêté. Reworkd a fermé la plateforme le 6 février 2025, donc elle ne sert pas pour un nouveau travail.
- La migration est à votre charge. Reworkd renvoyait vers un contact support pour sortir de l'outil, ce qui signifie que les pipelines existants avaient besoin d'une solution de remplacement.
- Le prix était facturé en sus de l'abonnement, donc la dépense montait avec le volume et le nombre de pages au lieu de rester fixe.
- L'approche par LLM convient à l'extraction large, mais les cas limites demandaient encore une relecture, car le scraping automatisé sur des mises en page inhabituelles peut renvoyer des résultats bruités.
Questions fréquentes
Reworkd AI créait et faisait tourner des scrapers web avec de grands modèles de langage. Vous définissiez un schéma des champs voulus, ajoutiez les URL sources, et la plateforme collectait des données structurées sur tout le site et ses sous-pages. Les équipes s'en servaient pour constituer des catalogues produits, des avis et d'autres jeux de données à grande échelle.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Reworkd AI.
Alternatives à Reworkd AI

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.