
RLAMA
Dontizi · Programmation · Productivité
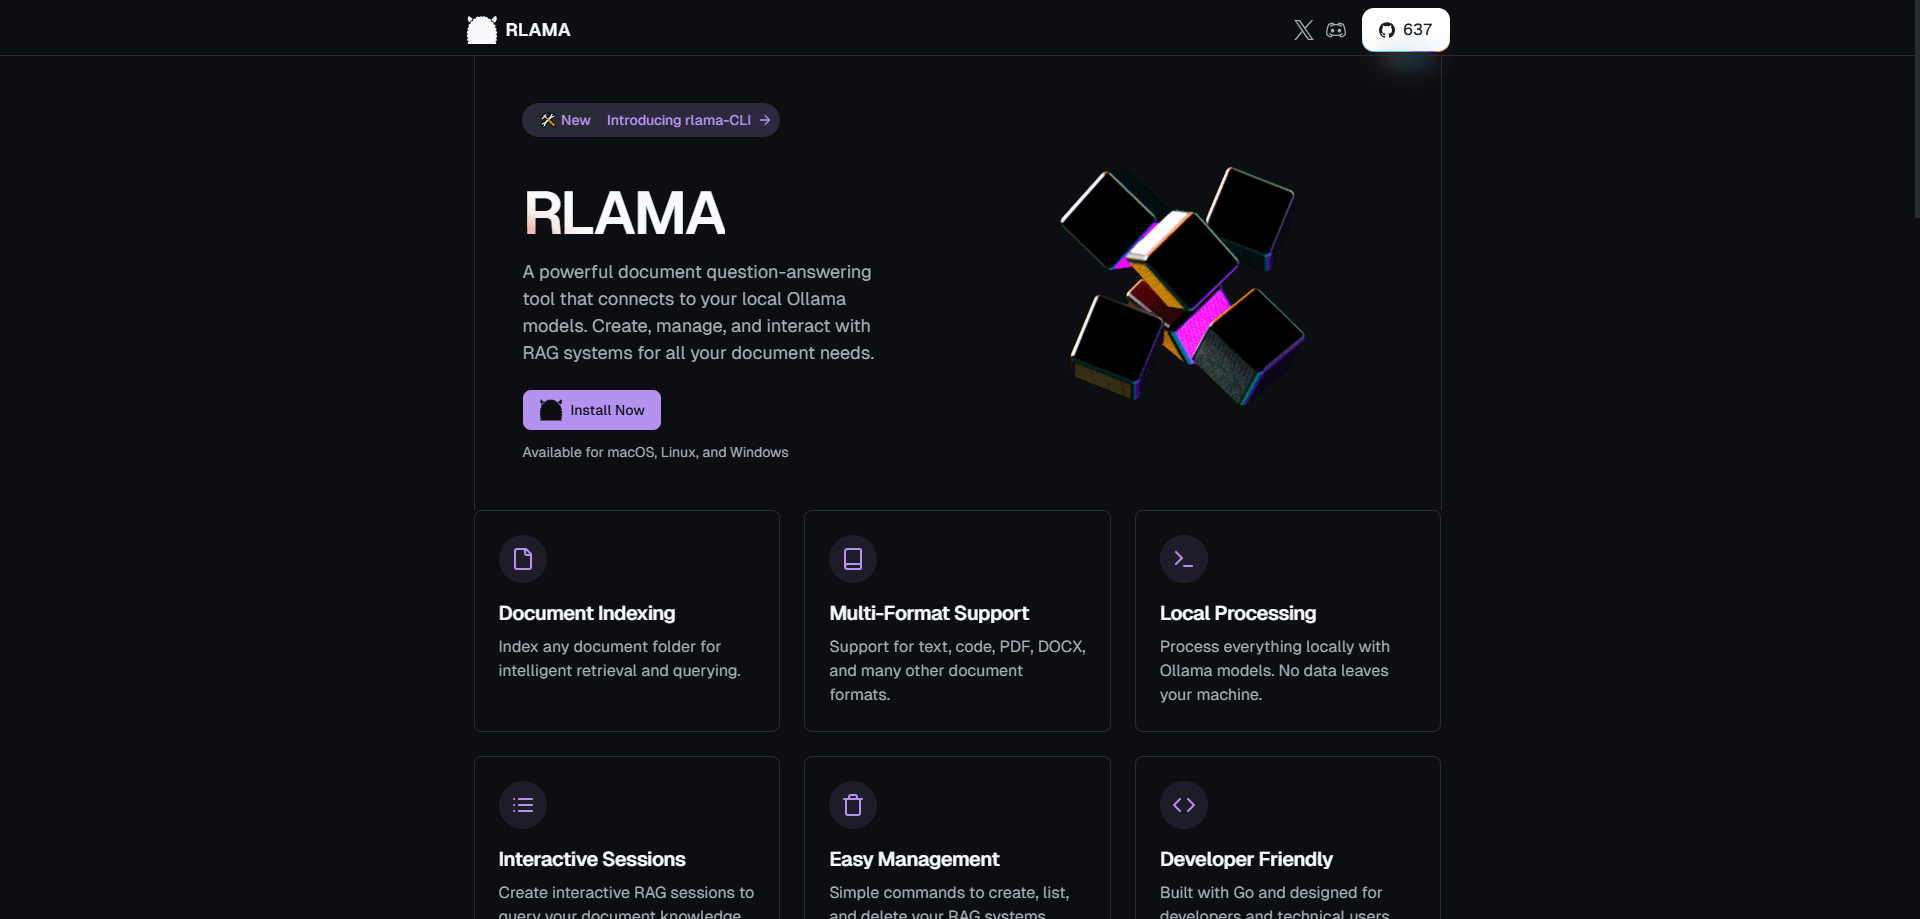
RLAMA est un outil en ligne de commande gratuit et open source qui crée des systèmes RAG privés sur vos documents, avec des modèles Ollama locaux pour que rien ne quitte votre machine.
À propos de RLAMA
What Is RLAMA
RLAMA est un outil de questions-réponses pour vos propres documents, conçu pour tourner entièrement sur votre ordinateur. C'est un outil RAG local en ligne de commande qui s'appuie sur Ollama, l'application qui fait tourner des modèles de langage hors ligne, et transforme un dossier de fichiers en base de connaissances interrogeable. Le développeur le publie sous licence Apache 2.0, donc le code est ouvert et utilisable gratuitement.
Le principe est simple. Vous indiquez un dossier, RLAMA lit les fichiers, les découpe en segments et stocke sur votre disque les vecteurs de chaque segment. Quand vous posez une question, l'outil repère les passages qui correspondent, les transmet à votre modèle local et le modèle répond en prenant vos documents comme contexte. Cette méthode s'appelle la génération augmentée par récupération (RAG), et c'est elle qui garde les réponses liées à de vraies sources au lieu de laisser le modèle inventer de mémoire.
La difficulté se situe à l'installation. RLAMA est une CLI, pas une app en un clic, donc vous travaillez dans un terminal et vous devez avoir Ollama installé et lancé avant que quoi que ce soit fonctionne. Il n'existe pas non plus de version hébergée, ce qui est justement le but d'un RAG auto-hébergé. Les résultats dépendent du modèle choisi et de la qualité de vos documents, et une machine faible ou un petit modèle se voient dans les réponses. Le projet est aussi en pause, donc aucune nouveauté n'arrive pour l'instant.
Getting Started
- Installez Ollama depuis ollama.ai et téléchargez au moins un modèle, par exemple ollama pull llama3.
- Installez RLAMA avec le script en une ligne : curl -fsSL https://raw.githubusercontent.com/dontizi/rlama/main/install.sh | sh.
- Créez un système RAG en pointant vers un dossier : rlama rag llama3 mes-docs ./docs.
- Lancez une session interactive et posez vos questions : rlama run mes-docs.
- Ajoutez des fichiers plus tard avec rlama add-docs, ou activez la surveillance de dossier pour qu'ils entrent seuls dans l'index.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de RLAMA.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs qui veulent une recherche locale de documents
- Équipes attentives à la confidentialité
- Utilisateurs qui ont déjà Ollama
- Curieux qui veulent comprendre le RAG
Tâches
- Interroger un dossier de documentation
- Explorer une base de code
- Construire une base depuis un site
- Garder la base à jour
- Brancher le RAG sur un autre outil
Cas d'usage
- Un indépendant avec des contrats clients qu'il ne peut héberger nulle part
- Un développeur qui cherche dans un gros dépôt
- Un chercheur avec une pile de PDF
- Un amateur qui teste de petits modèles
Fonctionnalités clés
Pipeline RAG local
Utilisez la commande rag pour indexer un dossier, run pour l'interroger et les fichiers locaux dans ~/.rlama pour tout conserver. Les documents sont lus, découpés, transformés en embeddings par Ollama et stockés sur disque. Rien ne touche un serveur externe, et c'est tout l'intérêt de l'outil.
Plusieurs stratégies de découpage
RLAMA découpe les documents de quatre façons : taille fixe, sémantique, hiérarchique et hybride. Le mode hybride choisit la meilleure méthode selon le type de fichier et traite le Markdown par titres, le code par fonctions et classes, et le texte brut par paragraphes. De meilleurs segments donnent une meilleure récupération, et c'est là que beaucoup d'outils RAG restent au niveau de base.
Exploration et suivi de sites
La commande crawl-rag construit un RAG depuis un site plutôt qu'un dossier, avec des réglages de profondeur, de concurrence et de chemins exclus. Web-watch surveille ce site et intègre les nouvelles pages à l'index, donc un site de documentation reste à jour sans réindexation manuelle.
Surveillance de dossiers
Vous pouvez pointer un RAG vers un dossier et demander à RLAMA de le vérifier à intervalle, ou seulement quand le RAG est utilisé. Les nouveaux fichiers s'indexent tout seuls, ce qui supprime l'étape où il faut penser à lancer add-docs après chaque changement.
Serveur API intégré
La commande api démarre un serveur HTTP, et un seul point d'accès POST /rag accepte le nom du RAG, un prompt et une taille de contexte optionnelle. Vous branchez ainsi des questions-réponses sur documents locaux dans un script, une petite app ou un outil qui ne parle pas la CLI.
Modèles Ollama et Hugging Face
RLAMA s'appuie sur Ollama pour les embeddings comme pour la génération, et accepte tout modèle qu'Ollama sait lancer. Les commandes hf-browse et run-hf atteignent le catalogue GGUF de Hugging Face pour chercher et tester un modèle avant de le mettre dans un système RAG.
Avantages et inconvénients
Avantages
- Fonctionne entièrement hors ligne, donc les documents ne quittent pas votre machine et il n'y a aucun coût par requête.
- Gratuit et open source sous Apache 2.0, avec un seul binaire Go qui s'installe en une ligne.
- Quatre stratégies de découpage et un crawler de sites vont plus loin que la plupart des solutions RAG locales.
- Le serveur API intégré transforme la CLI en quelque chose que d'autres outils peuvent appeler.
- Tourne sous Linux, macOS et Windows sans dépendance au cloud.
Inconvénients
- C'est uniquement une CLI, donc qui attend une app de bureau devra travailler dans un terminal.
- L'installation exige Ollama lancé et des modèles téléchargés au préalable, et cette étape bloque les débutants.
- La qualité des réponses suit le modèle choisi, donc un petit modèle sur une machine faible donne des résultats superficiels.
- Le développement est en pause, ce qui veut dire aucune nouveauté pour l'instant et des correctifs plus lents.
Questions fréquentes
RLAMA monte un système privé de questions-réponses sur vos propres fichiers. Vous indexez un dossier ou un site, puis vous posez des questions et recevez des réponses tirées de ce contenu, le tout avec des modèles Ollama locaux.
Contenus associés
Découvrez des outils, des compétences et des articles liés à RLAMA.
Alternatives à RLAMA

Udon
Udon · Programmation · ProductivitéUdon transforme un Mac Apple Silicon en serveur personnel piloté depuis le navigateur, avec conteneurs, partages de fichiers et un administrateur système IA en option.

offstage
offstage cloud · Programmation · Productivitéoffstage confie aux agents IA et aux jobs de CI un vrai Mac : un compte macOS 27 sur Apple silicon, piloté par API et facturé à la seconde.

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · Programmation · ProductivitéBotBus permet de contrôler des agents IA depuis son téléphone ou sa montre, même quand ils tournent sur l’ordinateur resté au bureau : vous validez les commandes, lancez des tâches et lisez les résultats.