

Salad - GPU Cloud
Salad Technologies · Programmation
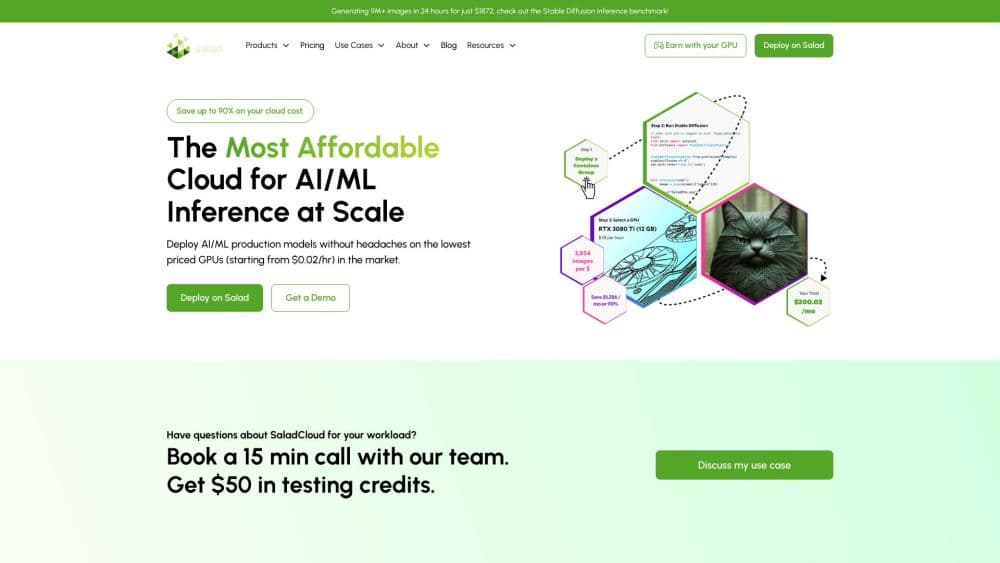
Salad est un cloud de GPU distribué qui exécute des conteneurs d'IA et des modèles à poids ouverts sur environ 16 000 GPU actifs par jour dans plus de 190 pays, à partir d'environ 0,015 dollar par heure de GPU.
À propos de Salad - GPU Cloud
What Is Salad
Salad est un cloud de GPU bâti sur du matériel que l'entreprise ne possède pas. Au lieu de remplir des data centers de baies identiques, il rassemble les GPU grand public et de station de travail laissés inactifs sur des PC de jeu et dans de petits bureaux du monde entier, puis loue cette capacité à des développeurs et à des entreprises qui font tourner des charges d'IA. Le résultat est un pool de calcul bien moins cher que les clouds classiques. Il se comporte aussi différemment sur plusieurs points importants.
La plateforme, pensée comme une plateforme d'inférence IA, couvre trois volets. Vous pouvez déployer des conteneurs Docker sur un réseau distribué de GPU de la gamme RTX, appeler des modèles à poids ouverts via un point d'accès de tokens compatible OpenAI, ou transcrire et synthétiser de l'audio avec des API dédiées. La même couche d'orchestration tourne sur Community Cloud, sur le matériel réservé de Dedicated et sur Private Cloud, en interne.
Le principal compromis porte sur la prévisibilité. Comme les nœuds appartiennent à des particuliers, les instances peuvent être réaffectées ou déconnectées quand une machine s'éteint. Salad gère cela avec des niveaux de priorité et une réaffectation automatique, mais l'offre convient aux charges qui tolèrent l'interruption, pas aux clusters rigides disponibles en permanence.
Getting Started
- Créez un compte SaladCloud et vérifiez vos informations.
- Générez une clé API depuis le portail, ou une clé pour l'AI Gateway si vous ne voulez que des tokens de modèles.
- Empaquetez votre charge en conteneur Docker, ou choisissez un modèle à poids ouverts dans le catalogue de la passerelle.
- Déployez depuis le portail ou en un seul appel API. Réglez un niveau de priorité et un nombre de réplicas.
- Suivez les journaux et vérifiez les résultats. La facturation ne court que tant qu'une instance est en exécution.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Salad - GPU Cloud.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Startups d'IA au budget serré
- Développeurs solo et créateurs indépendants
- Ingénieurs ML qui prototypent des pipelines d'inférence
Tâches
- Génération d'images et de vidéos par lots
- Transcription audio et synthèse vocale
- Servir des LLM à poids ouverts
Cas d'usage
- Faire passer une démo en production sans réserver de capacité de data center
- Faire durer une bourse de recherche
- Garder une inférence sensible sur votre propre matériel
Fonctionnalités clés
Pool de GPU distribué
Salad place des conteneurs sur environ 16 000 GPU actifs par jour, tirés de PC de jeu et de stations de travail dans plus de 190 pays. Le matériel existe déjà, donc la plateforme coordonne l'offre au lieu de financer de nouveaux data centers. C'est ce qui maintient les prix bas.
Salad Container Engine
Cette couche d'orchestration assure le déploiement de conteneurs GPU sur des nœuds qu'elle n'a jamais vus. Elle vérifie chaque machine, l'isole derrière un hyperviseur et réaffecte le travail dès qu'un nœud disparaît. Vous envoyez une image Docker avec quelques réglages de ressources, sans régler des serveurs à la main.
AI Gateway
La passerelle est une API compatible OpenAI pour des modèles à poids ouverts comme Qwen 3.6 et Qwen 3.5. Les versions les plus grandes embarquent une fenêtre de contexte de 262 144 tokens. Pointez n'importe quel SDK OpenAI vers une nouvelle URL de base, et vos agents, assistants de code ou applications paient au token ou via un forfait mensuel fixe.
Niveaux de priorité et facturation à la seconde
Quatre niveaux de priorité vous laissent échanger fiabilité contre coût. La priorité haute n'est jamais préemptée ; le niveau le plus bas est le moins cher et le plus interruptible. La facturation s'arrête dès qu'une instance stoppe, et l'allocation, le téléchargement d'image et le démarrage à froid sont gratuits.
API spécialisées par modalité
Salad publie des points d'accès réglés pour des tâches précises. Son API de transcription a atteint 95,1 % de précision sur CommonVoice, et son service de synthèse vocale est annoncé à jusqu'à 6 millions de mots par dollar. Chaque chiffre renvoie à une méthodologie déclarée, pas à une promesse marketing.
Déploiements privés et dédiés
Au-delà du pool partagé, les serveurs Dedicated réservés tournent sous contrat avec des cartes RTX PRO 6000 Blackwell, et Private Cloud licencie la même pile d'orchestration pour du matériel que vous possédez déjà. En Private Cloud, les données de l'entreprise restent sur les appareils de l'entreprise.
Avantages et inconvénients
Avantages
- Location de GPU bon marché : le tarif horaire démarre autour de 0,015 dollar pour un nœud RTX 4090 dans ce cloud distribué, une fraction de ce que facturent les clouds classiques pour un travail comparable.
- La facturation à la seconde, sans contrat ni minimum, rend les petites expérimentations peu coûteuses.
- Le moteur de conteneurs et l'AI Gateway réutilisent les outils Docker et OpenAI standard, ce qui réduit le travail de migration.
- Les points d'accès dédiés à la transcription et à la synthèse vocale couvrent les tâches audio courantes sans configuration.
- Les options Private Cloud et Dedicated gardent les charges sensibles sur du matériel que vous contrôlez.
Inconvénients
- Les instances peuvent être préemptées ou déconnectées quand les propriétaires des nœuds s'absentent, donc les services toujours actifs ont besoin d'une logique de relance.
- Les nœuds sont des GPU grand public dans des foyers et de petits bureaux, ce qui exclut l'entraînement multi-GPU fortement couplé que permettent les data centers.
- Il n'y a pas d'essai gratuit, donc vous payez dès le premier test. Le coût d'entrée reste faible, mais rien n'est gratuit.
- L'AI Gateway est encore en accès anticipé, et son catalogue de modèles est plus étroit que celui des fournisseurs de tokens dédiés.
Questions fréquentes
Non. Vous n'êtes facturé que pour les secondes où une instance est en exécution. L'allocation, le téléchargement d'image et le démarrage du conteneur sont gratuits.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Salad - GPU Cloud.
Alternatives à Salad - GPU Cloud

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.