
Scrapeless
Scrapeless · Programmation
Scrapeless est une plateforme cloud pour le scraping web et l'automatisation de navigateur. Son API de scraping web réunit navigateur anti-détection, API de déblocage, proxys résidentiels et scrapers structurés dans une boîte à outils pensée pour les agents IA et les équipes data.
À propos de Scrapeless
What Is Scrapeless
Scrapeless est une plateforme gérée de données web. Au lieu de faire tourner vos propres navigateurs headless, pools de proxys et solveurs de CAPTCHA, vous lui envoyez une URL ou ouvrez une session de navigateur cloud via une seule API. Le service se charge de la détection de bots, de la rotation d'IP, du rendu JavaScript et des défis CAPTCHA en coulisses.
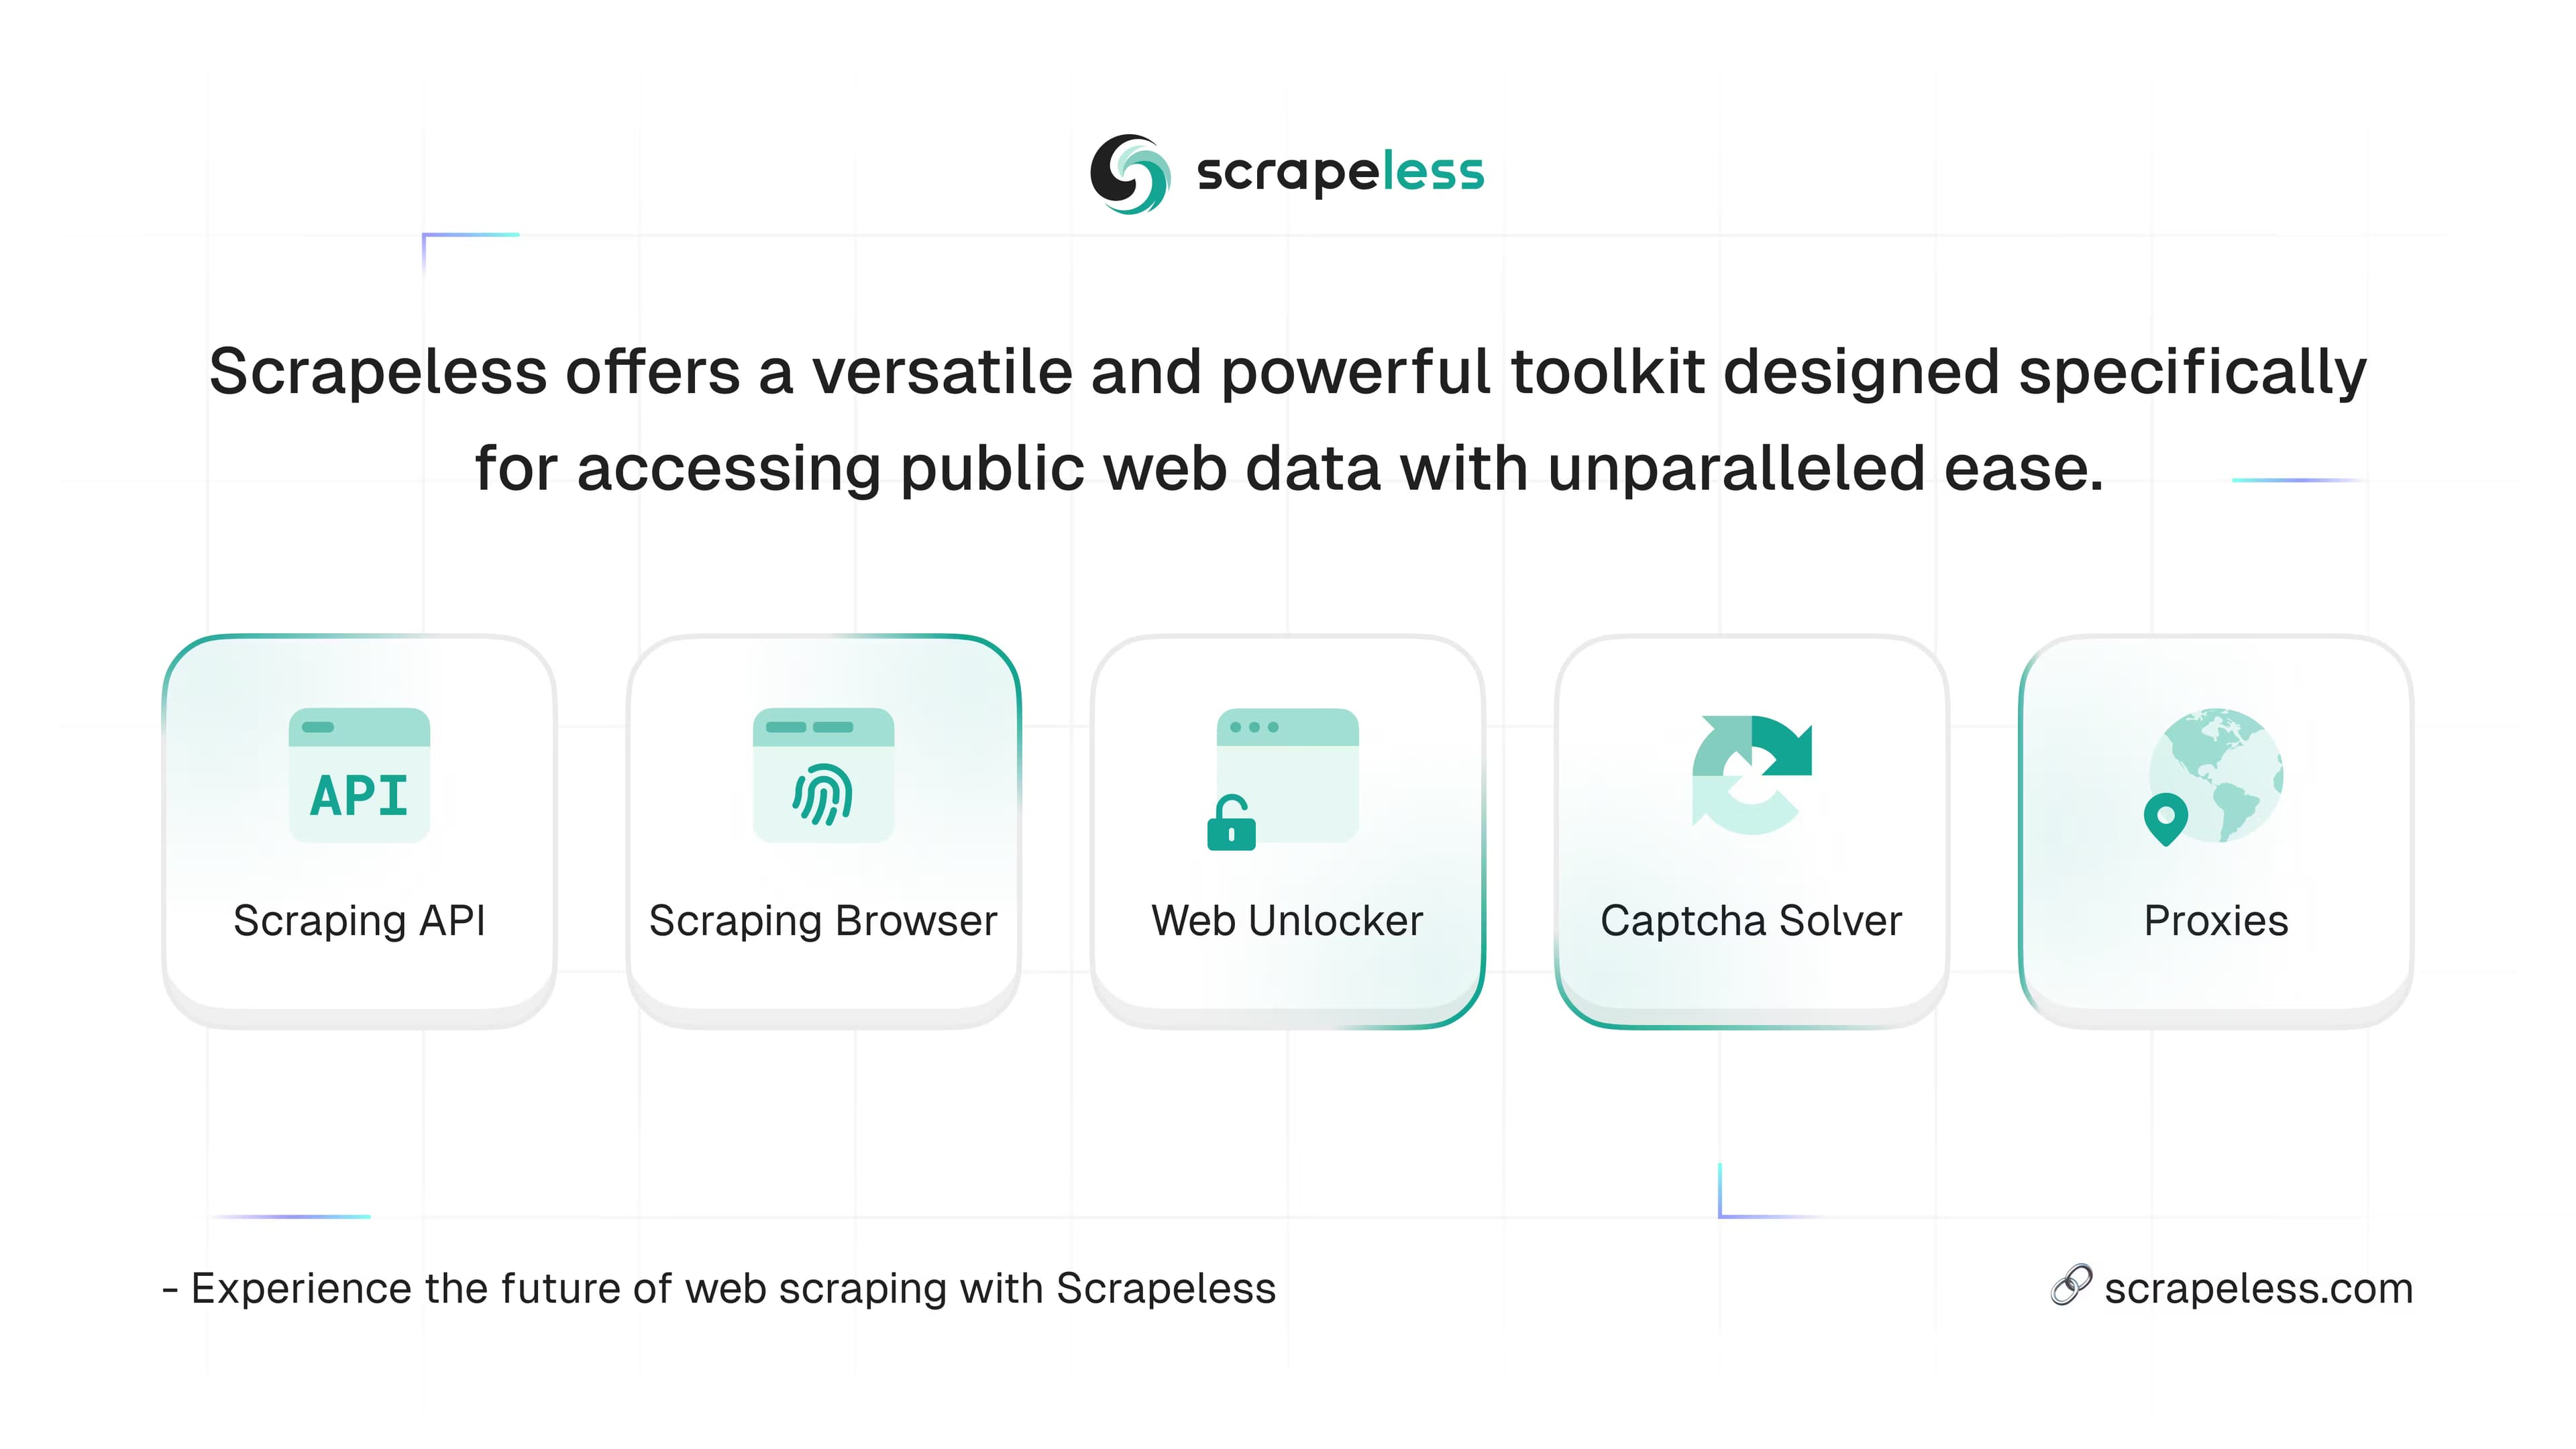
La gamme couvre plusieurs usages. Agent Browser donne aux agents IA un vrai navigateur cloud pour naviguer, cliquer et remplir des formulaires. Web Unlocker récupère le contenu de pages protégées par Cloudflare, DataDome ou AWS WAF. AI Scraper collecte les réponses et les citations de moteurs comme ChatGPT, Perplexity et Gemini. Des scrapers dédiés visent Google Search, Amazon et TikTok. Crawl transforme des sites entiers en Markdown ou HTML pour les pipelines RAG, et Proxies fournit des IP géolocalisées pour votre propre infrastructure.
La principale limite tient à la cible. Scrapeless vise les développeurs et les équipes data, il faut donc un peu de code ou une intégration comme n8n ou Make pour en tirer quelque chose. La tarification se fait à l'usage, ce qui rend les petits travaux peu coûteux, mais une très grosse collecte peut faire grimper la facture.
Getting Started
- Créez un compte sur le tableau de bord Scrapeless. Les nouveaux comptes reçoivent 5 dollars de crédit gratuit, sans carte bancaire.
- Copiez votre clé d'API dans le tableau de bord et gardez-la privée.
- Choisissez le produit adapté à votre tâche, comme Agent Browser, Web Unlocker ou la Scraping API.
- Envoyez une requête de test via l'API REST, un SDK en Python, Node ou Go, ou le serveur MCP.
- Inspectez le HTML, le JSON ou le Markdown renvoyé, puis branchez-le sur votre pipeline.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Scrapeless.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Ingénieurs data
- Créateurs d'agents IA
- Équipes SEO et growth
- Analystes e-commerce
Tâches
- Scraper des sites lourds en JavaScript
- Contourner les défenses anti-bots
- Constituer un corpus pour le RAG
- Surveiller la visibilité d'une marque dans l'IA
Cas d'usage
- Faire tourner de longs workflows d'agents
- Collecte à fort volume
- Recherche ponctuelle
Fonctionnalités clés
Agent Browser avec furtivité au niveau du moteur
Agent Browser est un navigateur cloud qui expose un endpoint CDP en WebSocket, si bien que votre code Puppeteer et Playwright actuel fonctionne en changeant une ligne. L'anti-détection vit dans un moteur de navigateur maison, pas dans un plugin. Cela couvre les empreintes TLS et JA3, le bruit Canvas et WebGL, la randomisation du contexte audio et le blocage des fuites d'IP par WebRTC.
Résolution de CAPTCHA intégrée
Les défis reCAPTCHA, Cloudflare Turnstile et AWS WAF sont résolus automatiquement dans la session. Scrapeless affirme que son solveur franchit les types courants de CAPTCHA avec un taux de 98 % ou plus, en moins de deux secondes en moyenne. Il est fourni gratuitement, sans solveur tiers payant.
API Web Unlocker
Web Unlocker reçoit une URL et renvoie du HTML propre, du JSON, du Markdown ou une capture d'écran, ce qui vous donne une extraction de données structurées sans rien configurer côté parsing. Il détecte le système anti-bot en face, fait tourner l'IP, rend le JavaScript et relance de lui-même. La facturation ne compte que les requêtes réussies, donc les tentatives ratées ne coûtent rien.
Réseau de proxys résidentiels
Chaque produit s'appuie sur un réseau de proxys résidentiels couvrant 195 pays, avec un ciblage par État et par ville et des sessions fixes pour les crawls à état. Scrapeless liste quatre types de proxys : résidentiel, ISP statique, centre de données et IPv6.
Sessions persistantes et Live View
Les profils stockés dans le cloud gardent la connexion entre les exécutions et évitent de répéter l'authentification sur les longs travaux. Live View diffuse le DOM de la session en moins de 100 millisecondes, et Session Replay rejoue les images avec les journaux réseau et console, pour voir exactement ce qu'un agent a trouvé quand il a échoué.
Serveur MCP et SDK multilingues
Un serveur MCP natif expose les actions de navigateur, le scraping et la recherche comme des outils appelables par des clients comme Claude Code, Cursor et Cline. Pour une intégration plus poussée, des SDK officiels couvrent Python, Node avec TypeScript et Go, avec des connecteurs maison pour n8n, Make, LangChain et Dify.
Avantages et inconvénients
Avantages
- Une seule plateforme couvre navigation cloud, déblocage, proxys, crawl et scrapers structurés, ce qui évite d'assembler plusieurs fournisseurs.
- Tarification à l'usage avec 5 dollars de crédit gratuit et sans carte pour démarrer.
- Résolution de CAPTCHA et proxys résidentiels inclus, pas en options payantes à part.
- Votre code Puppeteer et Playwright actuel se connecte via un endpoint CDP standard.
Inconvénients
- C'est un outil de développeur avant tout. Sans code, il faut une intégration comme n8n ou Make pour en faire quelque chose.
- Le coût à l'usage peut grimper vite sur de très gros crawls, mieux vaut suivre la consommation de crédit.
- Certains chiffres de réussite et de vitesse viennent de Scrapeless lui-même et ne sont pas vérifiés par des tiers.
- La gamme est large, ce qui peut brouiller le choix du point de départ pour un nouveau venu.
Questions fréquentes
Scrapeless collecte des données web publiques et exécute de l'automatisation de navigateur dans le cloud. Les équipes s'en servent pour scraper des sites protégés, alimenter des pipelines RAG, surveiller les résultats de recherche IA et fournir aux agents IA un vrai navigateur.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Scrapeless.
Alternatives à Scrapeless
Forefront
Forefront · ProgrammationForefront est une plateforme web pour construire avec de l'IA open source. Elle vous laisse affiner les principaux modèles de langage open source sur vos propres données, évaluer leurs performances et les exécuter via une API ou les exporter pour les héberger vous-même. Les développeurs qui veulent le confort d'une plateforme fermée mais tiennent à rester propriétaires de leurs modèles et de leurs données sont le public visé ici.

Startkit
StartKit.AI · ProgrammationStartkit est un boilerplate pour créer des produits SaaS d'IA et des wrappers d'IA. Voyez-le comme un boilerplate de startup IA avec les parties ennuyeuses déjà branchées : authentification, paiements Stripe et Lemon Squeezy, limites d'usage, e-mail transactionnel et un kit de démarrage d'API IA qui parle à OpenAI, Anthropic, Groq ou Llama. Vous clonez le dépôt, fixez votre prix et attaquez la partie du produit pour laquelle les gens paient vraiment. Il repose sur Next.js au-dessus de React et Tailwind, donc une bonne partie du code boilerplate vous semble déjà familière.
Testim
Tricentis · ProgrammationTestim est une plateforme d'automatisation des tests dopée à l'IA, qui sert à créer et exécuter des tests de bout en bout sur des applications web, mobiles et Salesforce. Elle s'appuie sur l'apprentissage automatique pour garder les tests stables quand une interface change, alors les équipes passent moins de temps à réparer des sélecteurs cassés. Pas mal pour un outil de tests automatisés que vous pouvez utiliser dès aujourd'hui. Vous créez des tests en enregistrant des actions dans un navigateur, puis vous ajoutez du JavaScript quand vous avez besoin de plus de contrôle. C'est un choix solide pour une équipe QA bien occupée.