

Search Candy
SearchCandy Labs · Programmation · Entreprise
Search Candy est une couche de récupération hébergée pour agents IA, éditée par SearchCandy Labs. Son Temporal Graph Memory renvoie des passages exacts avec le fichier et la version, sans appel à un LLM.
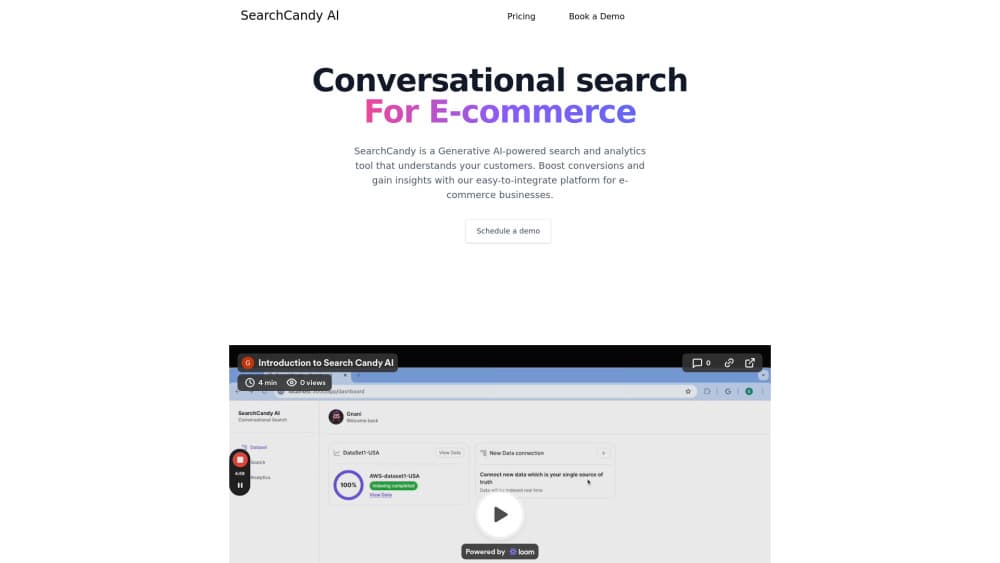
À propos de Search Candy
About
Qu'est-ce que Search Candy
Search Candy est un service de récupération de documents par IA destiné aux agents IA. SearchCandy Labs le présente comme un remplacement de l'étape de découpage dans une chaîne de récupération classique. Vous déposez des fichiers texte et Markdown, le système construit ce que l'éditeur appelle un Temporal Graph Memory (TGM), et votre agent interroge ce graphe.
Le problème visé, c'est la traçabilité. Dans une base vectorielle ordinaire, les documents sont découpés en blocs de taille fixe, un bloc peut commencer au milieu d'une phrase, et la réponse indique rarement de quel fichier il vient. Search Candy garde un groupe par fichier, coupe les passages à la fin des phrases et renvoie le texte d'origine avec le nom du fichier et le numéro de version sur chaque résultat. Demandez d'où vient une réponse, vous obtenez une source et non un score de similarité.
La portée reste étroite. Il s'agit d'infrastructure pour une équipe qui fait déjà tourner un agent, pas d'un produit de conversation. Le moteur de récupération n'héberge aucun modèle génératif, donc Search Candy ne rédige pas la réponse à votre place. Il ne lit par ailleurs que du texte et du Markdown pour l'instant, les autres formats étant convertis pendant la mise en route.
Pour commencer
- Réservez un appel de 30 minutes sur le site de SearchCandy Labs et apportez les questions auxquelles votre IA doit répondre juste.
- L'équipe crée votre compte et vous envoie le lien de connexion par courriel.
- Ajoutez vos fichiers texte ou Markdown et conservez le reçu de chacun.
- Branchez la bibliothèque Python et pointez-la vers votre propre modèle d'embeddings si vous préférez garder le vôtre.
- Interrogez depuis votre agent, puis lisez le passage renvoyé, le nom du fichier et la version.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Search Candy.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs qui construisent des agents IA
- Équipes qui gèrent un gros fonds de politiques ou de contrats
- Responsables support et documentation
Tâches
- Appuyer les réponses sur des citations
- Traiter les questions en deux temps
- Auditer ce qu'une IA a lu le mois dernier
- Remplacer le réglage de la taille des blocs
Cas d'usage
- Un premier prototype de récupération
- Relecture d'un contrat entre deux versions
- Fournir des preuves à un agent de support
Fonctionnalités clés
Un graphe de documents plutôt que des blocs
Search Candy organise chaque fichier déposé comme un groupe à part et conserve entiers les fichiers courts. Les documents longs se découpent en passages qui s'arrêtent à la fin des phrases, et chaque passage reste rattaché à son fichier. C'est cette structure qui rend la citation possible : le résultat sait de quel document il vient parce qu'il n'a jamais perdu le lien.
Une récupération en deux passes
Quand un fait mène à un autre, le moteur relance une recherche avec le passage qu'il vient de trouver. Sur HotpotQA, un jeu public de 7 405 questions à deux étapes, Search Candy annonce que tous les passages nécessaires figuraient dans ses 20 premiers résultats dans 98,4 % des cas, contre 94,8 % pour une recherche simple sur les mêmes documents. Ce sont des chiffres d'éditeur : testez-les sur vos propres questions.
Un historique des versions de documents
L'historique des versions de documents est la partie que presque personne ne mesure au départ. Chaque révision d'un fichier reste dans le graphe, donc vous pouvez interroger une date passée et retrouver les mêmes passages, mot pour mot. Pour une équipe qui répond sur des politiques, des tarifs ou des contrats, la question de ce que l'IA a vu en mars devient une requête.
Des passages littéraux avec leur source
Les résultats arrivent sous forme de texte d'origine, jamais réécrit, chacun étiqueté avec son fichier et sa version. Search Candy signale en plus les questions sans appui par un indicateur not_covered, ce qui compte quand une mauvaise réponse coûte plus cher qu'une absence de réponse.
Aucun LLM dans la boucle de récupération
Le moteur de récupération n'appelle aucun modèle de langage, donc fouiller vos documents n'ajoute pas de facture de tokens. Votre agent continue d'écrire la réponse avec son propre modèle. Dans un assistant interne à fort volume, cette séparation garde le coût de récupération stable quand le nombre de requêtes grimpe.
Service hébergé et embeddings personnels
SearchCandy Labs exploite le service, il n'y a donc rien à déployer. Vous pouvez apporter un modèle d'embeddings existant au lieu d'adopter le sien, et une bibliothèque Python gère la connexion. En contrepartie, l'hébergement, les permissions et le choix du cloud restent chez l'éditeur pour l'instant.
Avantages et inconvénients
Avantages
- Chaque résultat porte le nom du fichier et la version, donc vérifier une citation prend quelques secondes.
- Aucune taille de bloc, aucun chevauchement ni découpeur à régler avant d'obtenir un résultat exploitable.
- L'historique des versions répond sur une date passée, ce que presque aucune base vectorielle ne fait.
- Le moteur n'appelle pas de LLM, donc le volume de documents ne se transforme pas en dépense de tokens.
- La page publique de benchmarks affiche les réserves et les cas où l'éditeur ne fait qu'égaler la référence.
Inconvénients
- Seuls les fichiers texte et Markdown fonctionnent aujourd'hui, donc les PDF et les contrats scannés demandent une conversion à la mise en route.
- Pas encore de rapport SOC 2, de gestion fine des permissions ni d'installation sur votre infrastructure, ce qui exclut les acheteurs régulés.
- L'accès commence par un appel commercial et le tarif reste privé, vous ne pouvez donc pas l'évaluer seul un dimanche soir.
- Sur son propre test BEIR, l'outil égale la configuration standard de LangChain. Le gain réel tient à la traçabilité et aux questions à deux étapes, pas au rappel des dix premiers résultats.
Questions fréquentes
C'est la structure que Search Candy construit à partir de vos fichiers. Chaque document devient un groupe, avec ses versions empilées derrière, et les passages vivent dans ce groupe plutôt que dans un tas commun de blocs. L'objectif est de ne jamais casser le lien entre un passage et son origine.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Search Candy.
Alternatives à Search Candy

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.