
SemanticGuard
SemanticGuard · Programmation
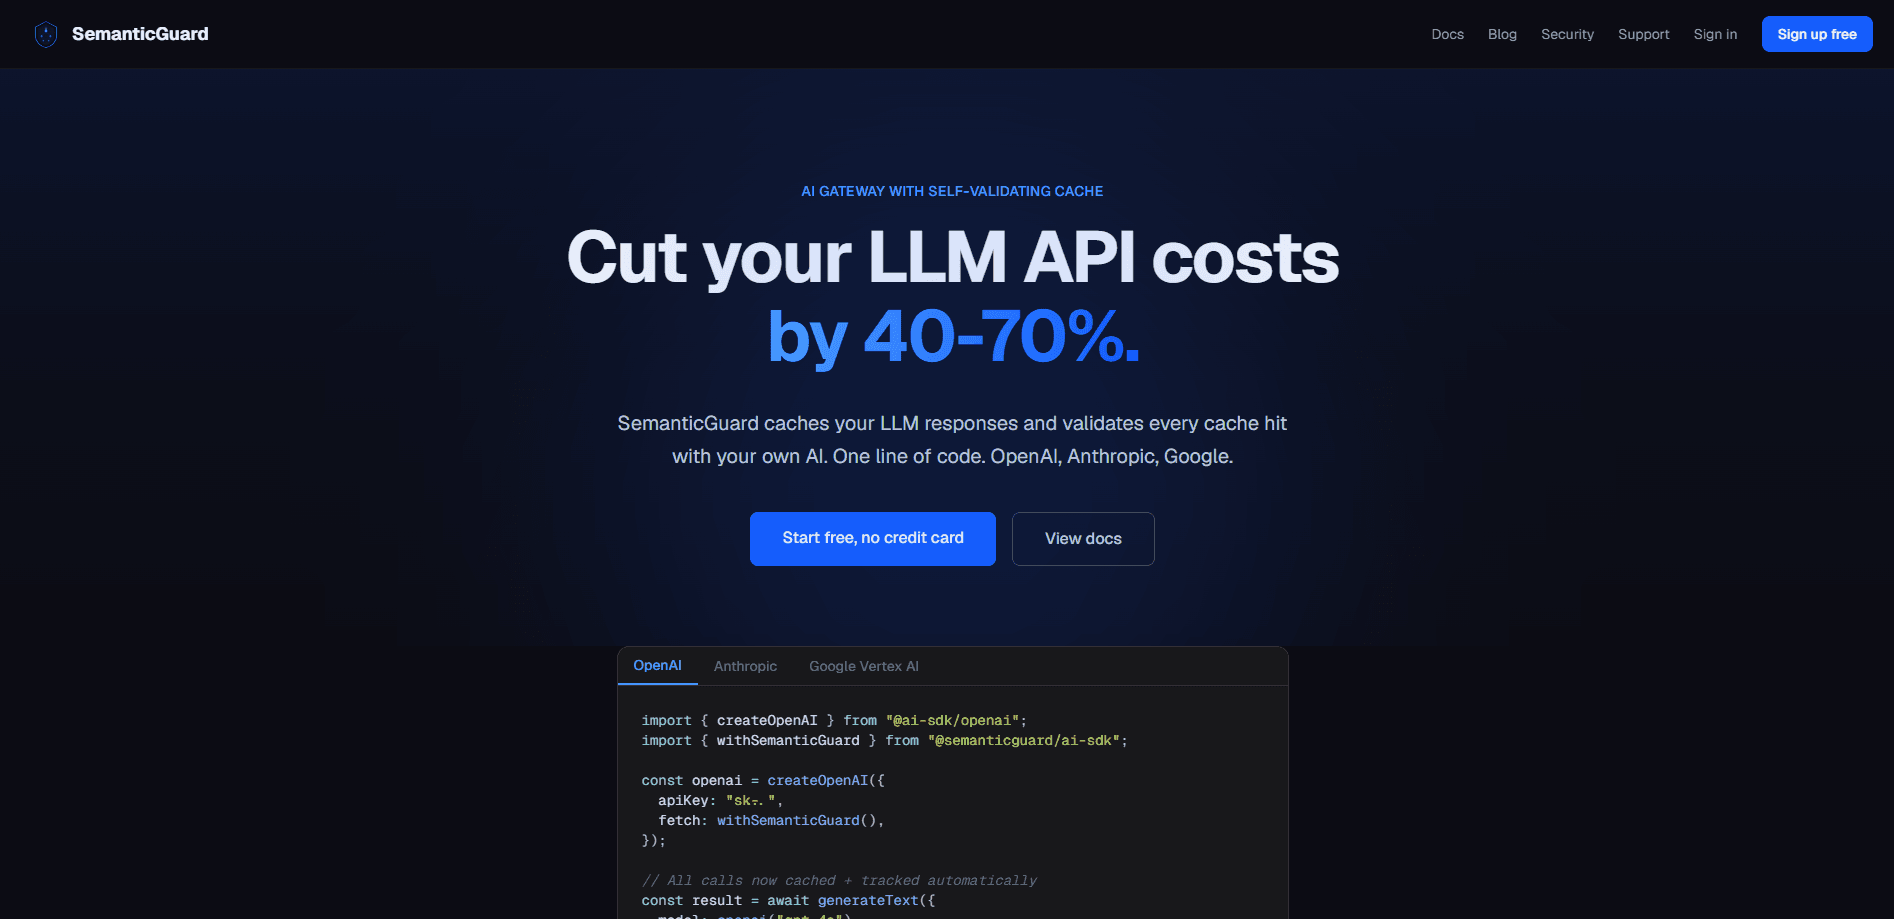
SemanticGuard est une passerelle d'IA qui se place entre votre application et les fournisseurs de LLM que vous utilisez déjà. Elle fait deux choses à la fois : elle met les réponses en cache pour que vous cessiez de payer le prix plein pour des questions répétées, et elle audite et contrôle les appels d'outil que font vos agents d'IA. L'éditeur annonce une économie médiane de 50 % sur les dépenses de LLM dans son propre benchmark, avec un palier gratuit dimensionné pour 10K requêtes par mois et un palier Pro à 49 $/mois.
À propos de SemanticGuard
Qu'est-ce que SemanticGuard
SemanticGuard est un proxy compatible OpenAI doté d'un cache sémantique auto-validé. Pointez votre client vers lui plutôt que vers le fournisseur, insérez une clé d'API SG, et chaque requête est mise en cache, journalisée et suivie. L'argument de vente ? Le cache ne se fait pas confiance. Une seconde couche vérifie les correspondances avec votre propre IA avant de les servir, si bien qu'une paraphrase proche d'une ancienne requête ne renvoie pas discrètement la mauvaise réponse.
L'autre moitié, c'est la gouvernance des agents d'IA. Chaque appel d'outil que votre LLM émet apparaît dans un flux d'activité avec son nom, ses arguments, le modèle et l'attribution de session. Un classifieur note chaque appel comme lecture, écriture ou destructeur. Un moteur de règles l'autorise ensuite, le refuse ou le signale pour approbation. Cela attrape la panne classique où un run_shell d'apparence inoffensive dissimule un rm -rf, ou bien où un agent tente un push directement sur la main.
Le hic, c'est qu'il s'agit d'infrastructure, pas d'une application grand public. Il vous faut un endroit où l'exécuter, des clés d'API à gérer et au moins une idée claire du flux de votre trafic LLM. La mise en cache suppose aussi une vraie répétition dans votre trafic ; une application à faible volume avec des prompts uniques à chaque fois en tirera peu de bénéfice. Le mode Ombre existe pour que vous mesuriez vos propres économies avant de dépenser un dollar.
Premiers pas
- Inscrivez-vous sur semanticguard.dev et créez une clé d'API sur le tableau de bord. Aucune carte bancaire n'est requise pour le palier gratuit.
- Activez d'abord le mode Ombre. Il journalise chaque requête et montre ce que vous économiseriez avant qu'une seule réponse en cache ne soit réellement servie.
- Faites passer votre trafic par le proxy. Définissez
ANTHROPIC_BASE_URLpour Claude Code, ou ajoutez le wrapper fetch du AI SDK avec votre clé SG aux appels OpenAI, Anthropic, Google, Azure, Bedrock ou Mistral. - Consultez le tableau de bord jusqu'à être à l'aise avec les économies projetées, puis activez la mise en cache et fixez vos règles pour les appels d'outil destructeurs.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de SemanticGuard.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Les développeurs en quête d'économies sur les coûts de LLM
- Les équipes d'ingénierie qui utilisent la gouvernance des agents d'IA
Tâches
- Réduire les dépenses d'API de LLM
- Auditer les appels d'outil des agents
- Bloquer les actions destructrices des agents
Cas d'usage
- Les agents en production qui touchent des systèmes en direct
- Les configurations multi-fournisseurs
- Les équipes qui veulent un seul proxy Claude Code
Fonctionnalités clés
Cache sémantique auto-validé
Le cache fait correspondre le sens, pas seulement les mots, si bien qu'une question reformulée peut tout de même trouver une correspondance. Ce qui le distingue, c'est la couche de validation : les correspondances passent par une vérification multicouche et un échantillonnage continu jugé par IA, donc l'exactitude est traitée comme une chose à prouver, non à présumer. L'éditeur revendique 100 % d'exactitude du cache sur son benchmark public, et la mise en cache entre fournisseurs signifie que la réponse d'un modèle peut servir une paraphrase destinée à un autre.
Gouvernance des appels d'outil des agents
Chaque appel d'outil que votre LLM émet atterrit dans un flux d'activité avec le nom de l'outil, les arguments, le modèle et l'attribution complète de la session. Un classifieur déterministe note chaque appel comme lecture, écriture ou destructeur. Si vous passez déjà par SemanticGuard, cela fonctionne sans aucun changement de code.
Moteur de règles avec approbations
Vous définissez ce qui tourne et ce qui ne tourne pas, par motif, niveau de risque, espace de travail ou utilisateur. Des valeurs par défaut sensées sont livrées dès le premier jour : refuser les appels destructeurs en prod, exiger une approbation pour les déploiements, bloquer les PR vers la main. Les modifications de règles apparaissent dans la piste d'audit en quelques secondes.
Intégration du AI SDK en une ligne
Ajoutez un wrapper fetch à n'importe quel fournisseur avec le Vercel AI SDK. Il fonctionne avec OpenAI, Anthropic, Vertex AI et tout ce qui accepte une fonction fetch personnalisée. Pour Claude Code et les autres clients du SDK Anthropic, définir une variable d'environnement fait passer le trafic par la passerelle avec suivi des coûts, audit et masquage des données personnelles inclus.
Mode Ombre
Avant de faire confiance au cache, le mode Ombre journalise tout et indique ce que vous auriez économisé, sans servir une seule réponse en cache. C'est la façon honnête de vérifier si votre trafic se répète assez pour justifier le changement. Le palier gratuit est bâti autour de cela, sans carte bancaire.
Déploiement auto-hébergé dans votre propre tenant
L'installation depuis le Vercel Marketplace déploie le proxy dans votre propre compte Vercel, adossé à votre Neon Postgres, Upstash Redis et Upstash Vector. Les prompts, les réponses, les embeddings et le contenu du cache ne quittent jamais votre tenant ; seuls la licence, la validation de la clé d'API et un signal de santé atteignent le plan de contrôle de SemanticGuard.
Observabilité et contrôles par tenant
Le tableau de bord couvre l'analyse des coûts et la traçabilité par requête, avec un endpoint Prometheus pour les équipes qui envoient leurs métriques vers leur propre stack. Chaque tenant dispose de son propre interrupteur d'arrêt et de son journal d'audit.
Avantages et inconvénients
Avantages
- Finance son propre coût en réduisant les dépenses de LLM qu'il élimine, plutôt qu'en ajoutant une ligne distincte.
- La mise en cache entre fournisseurs est vraiment rare ; les caches natifs d'OpenAI et d'Anthropic restent chacun dans leurs propres modèles.
- La gouvernance arrive via une variable d'environnement ou un wrapper fetch, donc l'adopter n'exige pas de réécrire l'agent.
- L'option auto-hébergée garde les prompts, les réponses et les embeddings dans votre propre VPC.
- La validation de l'exactitude avec un échantillonnage jugé par IA répond à la principale crainte que les gens ont du cache sémantique.
Inconvénients
- Les économies dépendent de la répétition de votre trafic ; des prompts uniques sans recoupement montreront peu de bénéfice, donc le mode Ombre est une première étape obligatoire.
- Le palier Enterprise est facturé à 15 % des économies documentées avec un plancher de 500 $/mois, ce qui est plus difficile à prévoir qu'un tarif fixe.
- Certaines briques de gouvernance, comme la boîte d'approbation avec humain dans la boucle et le proxy de la couche MCP, sont encore sur la feuille de route.
- Les 10K requêtes/mois du palier gratuit s'épuisent vite pour des équipes qui testent à volume réel.
Questions fréquentes
C'est une passerelle d'IA avec deux moitiés. L'une met en cache les réponses des LLM pour réduire le coût des API, et l'autre audite et contrôle les appels d'outil que font vos agents. Vous faites passer votre trafic LLM actuel par elle et les deux fonctions tournent sur les mêmes requêtes.
Contenus associés
Découvrez des outils, des compétences et des articles liés à SemanticGuard.
Alternatives à SemanticGuard
Forefront
Forefront · ProgrammationForefront est une plateforme web pour construire avec de l'IA open source. Elle vous laisse affiner les principaux modèles de langage open source sur vos propres données, évaluer leurs performances et les exécuter via une API ou les exporter pour les héberger vous-même. Les développeurs qui veulent le confort d'une plateforme fermée mais tiennent à rester propriétaires de leurs modèles et de leurs données sont le public visé ici.

Startkit
StartKit.AI · ProgrammationStartkit est un boilerplate pour créer des produits SaaS d'IA et des wrappers d'IA. Voyez-le comme un boilerplate de startup IA avec les parties ennuyeuses déjà branchées : authentification, paiements Stripe et Lemon Squeezy, limites d'usage, e-mail transactionnel et un kit de démarrage d'API IA qui parle à OpenAI, Anthropic, Groq ou Llama. Vous clonez le dépôt, fixez votre prix et attaquez la partie du produit pour laquelle les gens paient vraiment. Il repose sur Next.js au-dessus de React et Tailwind, donc une bonne partie du code boilerplate vous semble déjà familière.
Testim
Tricentis · ProgrammationTestim est une plateforme d'automatisation des tests dopée à l'IA, qui sert à créer et exécuter des tests de bout en bout sur des applications web, mobiles et Salesforce. Elle s'appuie sur l'apprentissage automatique pour garder les tests stables quand une interface change, alors les équipes passent moins de temps à réparer des sélecteurs cassés. Pas mal pour un outil de tests automatisés que vous pouvez utiliser dès aujourd'hui. Vous créez des tests en enregistrant des actions dans un navigateur, puis vous ajoutez du JavaScript quand vous avez besoin de plus de contrôle. C'est un choix solide pour une équipe QA bien occupée.