

Serpex.dev
Serpex.dev · Programmation
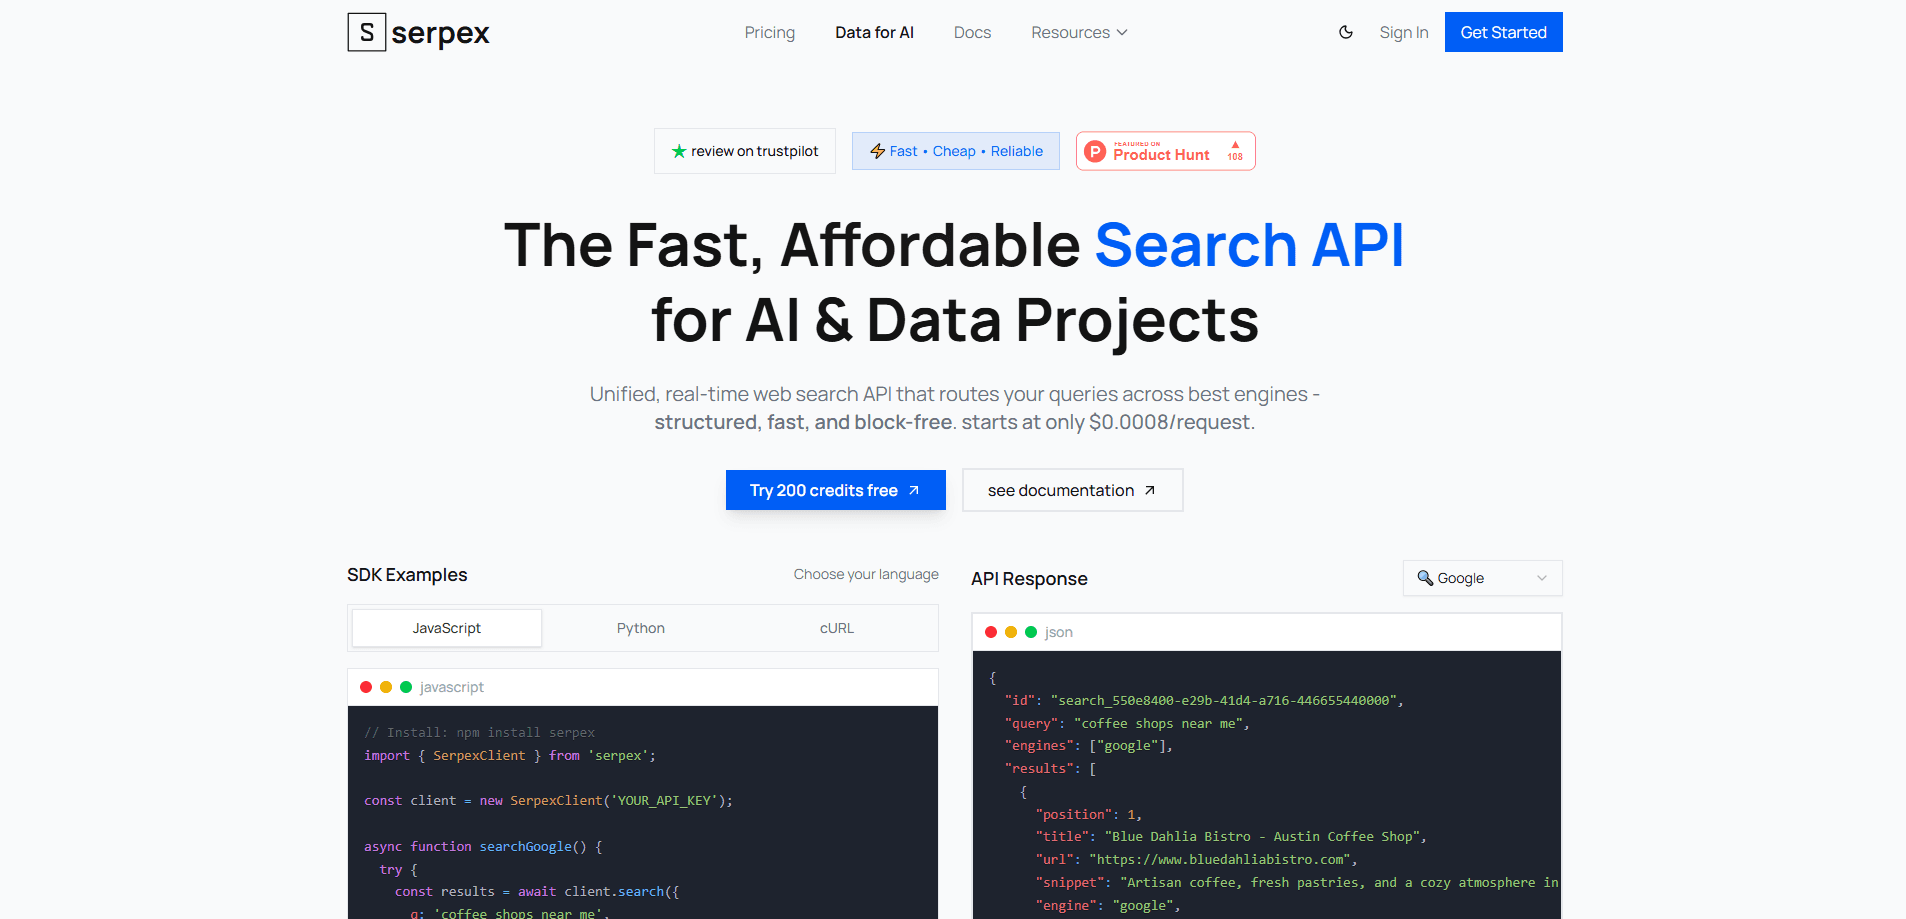
Serpex.dev est une API de recherche et d'extraction pensée pour les développeurs. Elle renvoie des résultats web structurés et le contenu épuré d'une page en un seul appel. Elle vise les agents IA, les pipelines RAG et les projets de données qui ont besoin de données web fraîches sans gérer leurs propres navigateurs ni scrapers. Les requêtes démarrent à environ 0,0008 $ chacune, et vous ne payez que les appels réussis.
À propos de Serpex.dev
Qu'est-ce que Serpex.dev
Serpex.dev est une API de recherche web pour ceux qui branchent des données internet en direct dans un logiciel. Vous envoyez une requête et vous recevez des résultats classés en JSON : titres, URL, extraits, positions et le moteur qui a répondu. Vous envoyez une liste d'URL et vous récupérez le contenu de ces pages en Markdown ou HTML, déjà nettoyé.
Le service existe parce que fonder un système d'IA sur des données d'entraînement périmées est une bataille perdue. Si vous construisez un agent qui a besoin des prix du jour, ou une configuration d'ingestion RAG qui doit citer ce que le web dit réellement, faire ce scraping vous-même est un travail sans fin. Concrètement, pour celui qui branche le tout ? Le navigateur, le pool de proxies et la logique de réessai que vous devriez écrire et maintenir se trouvent derrière l'endpoint de quelqu'un d'autre, et votre tâche se réduit à formater une requête et à lire une liste JSON en retour.
La limite principale tient à la portée. C'est une infrastructure pour développeurs, pas un tableau de bord pour une recherche occasionnelle. Il vous faut une clé d'API, du code et une idée du nombre de requêtes que votre app enverra. L'extraction est aussi plafonnée à 10 URL par requête, donc les crawls massifs demandent du traitement par lots. Les pages derrière une protection anti-bot lourde peuvent encore échouer. Les requêtes stealth échouées sont gratuites, donc une page bloquée ne vous coûte pas votre solde.
Pour commencer
- Inscrivez-vous sur app.serpex.dev et réclamez les 200 crédits gratuits offerts à la création d'un compte.
- Générez une clé d'API dans le tableau de bord et stockez-la sous la forme
sk_...sur votre serveur, jamais dans le code côté client. - Envoyez votre première requête avec un POST vers
https://api.serpex.dev/api/search, en passant une requête comme{"q": "openai gpt-4o"}et votre jeton Bearer dans l'en-tête. - Pour le contenu d'une page, appelez
POST /api/crawlavec une liste d'URL, et ajoutez"stealth": truesi un site bloque les requêtes normales. - Lisez la réponse JSON, puis branchez les résultats dans votre agent, votre base de données vectorielle ou votre pipeline de rapports.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Serpex.dev.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs IA et backend
- Équipes data qui construisent des pipelines RAG
- Chercheurs SEO et marché
Tâches
- Ancrer les réponses d'un LLM
- Ingestion de contenu
- Suivi des concurrents
Cas d'usage
- Vous prototypez un agent de recherche et ne voulez pas gérer de proxies ni de navigateurs sans interface.
- Vous avez besoin d'un moyen bon marché de lancer des milliers de requêtes pour un travail analytique sans contrat entreprise.
- Un site bloque le scraping normal et il vous faut une solution de repli qui contourne la protection anti-bot.
Fonctionnalités clés
Recherche et extraction unifiées
La plupart des API de recherche s'arrêtent à la page de résultats. Serpex pousse le travail un cran plus loin. Vous pouvez demander des résultats, puis tirer le contenu complet derrière chacun d'eux depuis le même service, avec la même clé et le même solde. Cela fait une intégration de moins à construire et une facture de moins à rapprocher en fin de mois. Pour un pipeline RAG, ce gain de configuration est bien réel.
Réponses JSON structurées
Les appels de recherche renvoient des champs de titre, URL, extrait, position et moteur dans une forme JSON prévisible. Ils arrivent sous forme de tableau simple que vous pouvez parcourir, filtrer ou stocker sans écrire une ligne de code pour analyser du HTML ni garder un navigateur sans interface actif sur vos serveurs. Cette structure est ce qui vous permet de classer, filtrer et stocker les résultats sans logique de scraping bricolée.
Mode stealth pour les pages bloquées
Certains sites se défendent contre l'accès automatisé. Ajouter stealth: true à une requête de crawl la fait passer par une configuration conçue pour franchir une protection anti-bot lourde, facturée cinq crédits par URL. Les requêtes stealth échouées ne coûtent rien, donc une page bloquée ne vide pas votre solde. Voyez cela comme une API de scraping web avec un interrupteur de contournement pour les sites tenaces.
Routage multi-moteur
Une couche de routage automatique choisit le moteur pour chaque requête au lieu de vous forcer à en choisir un par appel. Les résultats reviennent étiquetés avec le moteur qui a répondu. Cette étiquette sert quand vous voulez comparer la façon dont différentes sources classent la même requête.
Modèle de crédits compatible crypto
Les crédits n'expirent jamais, et vous pouvez les acheter à l'usage ou en un forfait unique. Aucun abonnement qui vous enferme. Une requête échouée n'est pas facturée, et l'offre gratuite vous démarre à 200 crédits, un moyen simple de tester le service avant de vous engager.
Niveaux tarifaires abordables
Le prix de l'API de recherche baisse à mesure que le volume grimpe : environ 0,80 $ par 1 000 requêtes en Starter, 0,65 $ en Standard et 0,50 $ en Scale. L'extraction stealth tourne autour de 4,00 $, 3,25 $ et 2,50 $ par 1 000 selon le niveau. C'est l'argument principal, et il tient bien face aux options d'API SERP plus chères du marché.
Réseau mondial de proxies et concurrence
Chaque niveau tourne sur un réseau mondial de proxies avec 99,7 % de disponibilité et une protection contre les limites de débit. La concurrence évolue avec votre plan, donc vous pouvez lancer 10 requêtes parallèles en Starter, 50 en Standard et jusqu'à 100 en Scale, avec des plafonds personnalisés pour les comptes entreprise qui ont besoin de milliers d'appels simultanés.
Analytique et support
Le tableau de bord rapporte une analytique d'usage détaillée pour voir où passent les crédits, et le support répond jour et nuit par chat et e-mail. Pour un service facturé à la requête, savoir exactement ce qui a consommé votre solde compte.
Avantages et inconvénients
Avantages
- La recherche et l'extraction de pages vivent dans une seule API, donc vous évitez un second fournisseur de scraping.
- Le prix par requête d'environ 0,0008 $ garde les gros volumes de requêtes bon marché.
- Les requêtes stealth échouées sont gratuites, ce qui adoucit le coût des pages bloquées.
- Les crédits n'expirent jamais et aucun abonnement ne vous enferme.
- 200 crédits gratuits facilitent les tests avant de payer.
Inconvénients
- Pas de tableau de bord navigateur pour une recherche occasionnelle. Il faut du code et une clé d'API pour l'utiliser.
- Les requêtes de crawl sont plafonnées à 10 URL, donc les gros travaux demandent du traitement par lots.
- Le mode stealth coûte cinq fois le tarif normal, ce qui s'accumule sur les sites protégés.
Questions fréquentes
Serpex.dev donne aux développeurs un moyen rapide de faire entrer des résultats de recherche web en direct et du contenu de pages dans une application. On le trouve surtout dans les agents IA, les pipelines RAG et les projets de données qui ont besoin d'informations à jour plutôt que du savoir intégré d'un modèle.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Serpex.dev.
Alternatives à Serpex.dev
Forefront
Forefront · ProgrammationForefront est une plateforme web pour construire avec de l'IA open source. Elle vous laisse affiner les principaux modèles de langage open source sur vos propres données, évaluer leurs performances et les exécuter via une API ou les exporter pour les héberger vous-même. Les développeurs qui veulent le confort d'une plateforme fermée mais tiennent à rester propriétaires de leurs modèles et de leurs données sont le public visé ici.

Startkit
StartKit.AI · ProgrammationStartkit est un boilerplate pour créer des produits SaaS d'IA et des wrappers d'IA. Voyez-le comme un boilerplate de startup IA avec les parties ennuyeuses déjà branchées : authentification, paiements Stripe et Lemon Squeezy, limites d'usage, e-mail transactionnel et un kit de démarrage d'API IA qui parle à OpenAI, Anthropic, Groq ou Llama. Vous clonez le dépôt, fixez votre prix et attaquez la partie du produit pour laquelle les gens paient vraiment. Il repose sur Next.js au-dessus de React et Tailwind, donc une bonne partie du code boilerplate vous semble déjà familière.
Testim
Tricentis · ProgrammationTestim est une plateforme d'automatisation des tests dopée à l'IA, qui sert à créer et exécuter des tests de bout en bout sur des applications web, mobiles et Salesforce. Elle s'appuie sur l'apprentissage automatique pour garder les tests stables quand une interface change, alors les équipes passent moins de temps à réparer des sélecteurs cassés. Pas mal pour un outil de tests automatisés que vous pouvez utiliser dès aujourd'hui. Vous créez des tests en enregistrant des actions dans un navigateur, puis vous ajoutez du JavaScript quand vous avez besoin de plus de contrôle. C'est un choix solide pour une équipe QA bien occupée.