
Soup CLI
MePlay, Inc. · Programmation
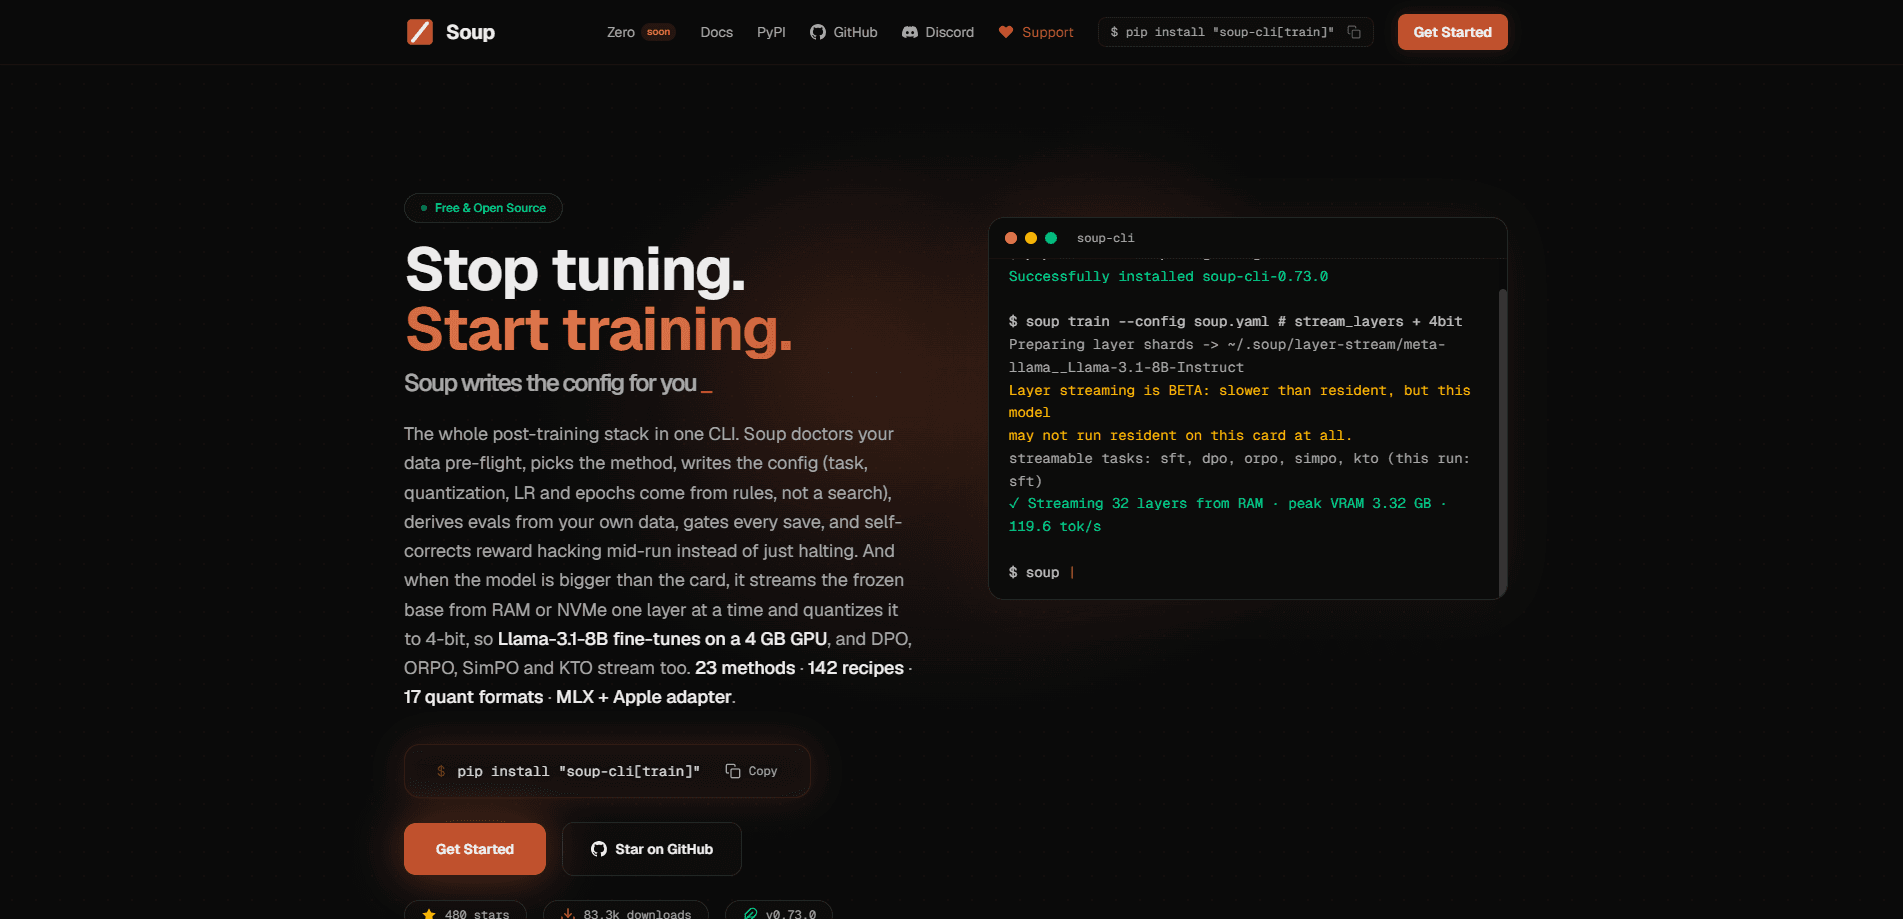
Soup CLI est un outil en ligne de commande open source pour le fine-tuning et le post-entraînement de grands modèles de langage. En tant qu'outil de fine-tuning de LLM, il transforme le travail de configuration habituel en un seul flux : vous écrivez un fichier YAML, lancez `soup train`, et Soup gère seul la détection du GPU, la taille des lots et la quantification. Le projet vise ceux qui veulent affiner des modèles en local plutôt que louer des GPU dans le cloud ou se battre avec des scripts d'entraînement, et sa fonction phare, le streaming de couches, permet d'entraîner un modèle 8B sur le GPU d'un portable avec seulement 4 Go de VRAM.
À propos de Soup CLI
Qu'est-ce que Soup CLI
Soup CLI (également publié comme le paquet Python soup-cli) est une pile centrée sur la ligne de commande qui couvre tout le cycle de post-entraînement : nettoyage des données, choix de méthode, génération de configuration, évaluation et filtrage des checkpoints. Le projet est maintenu par MePlay, Inc. et publié sous licence Apache-2.0, donc vous pouvez lire le code, le forker ou l'intégrer à votre propre pipeline.
Le principal problème qu'il résout, c'est la friction. Quiconque a déjà entraîné un modèle connaît le rituel : choisir le matériel, se battre contre les conflits de dépendances, deviner la taille des lots et déboguer un plantage à l'étape 400. Soup compresse tout cela dans un fichier de configuration qu'il écrit pour vous. Pourquoi est-ce important ? Parce que la mise en route, et non l'entraînement lui-même, est l'endroit où la plupart des fine-tunings de débutant échouent. Il s'adresse aux développeurs, aux chercheurs et aux petites équipes qui veulent un fine-tuning fonctionnel sans devenir ingénieurs en infrastructure.
La plus grande limite, c'est le matériel. L'entraînement demande toujours un GPU CUDA, et lancer une vraie tâche de 7B à 8B sur une machine ordinaire suppose d'accepter QLoRA et des poids quantifiés plutôt qu'un entraînement en pleine précision. C'est le compromis. Le streaming de couches, la fonction qui rend les petits GPU viables, est encore étiqueté BETA et doit être activé à la main.
Pour commencer
- Installez le paquet. Utilisez
pipx install "soup-cli[train]"ouuv tool install "soup-cli[train]". L'installation simple desoup-cliest une CLI légère sans PyTorch, donc il vous faut l'extra[train]pour affiner. - Générez une configuration. Lancez
soup init --template chatpour créer unsoup.yamlde départ pour un fine-tuning de style chat. - Pointez-le vers vos données et le modèle de base. Modifiez le YAML pour définir le chemin de votre jeu de données et le modèle que vous voulez adapter.
- Lancez l'entraînement. Exécutez
soup trainet laissez-le détecter votre GPU et choisir les réglages. Pour les gros modèles sur de petites cartes, activez d'abordstream_layers: true. - Servez ou exportez le résultat. Utilisez
soup servepour exposer le modèle affiné derrière un endpoint d'API compatible avec OpenAI.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Soup CLI.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs indépendants et amateurs
- Ingénieurs ML et chercheurs
- Petites startups
Tâches
- Fine-tuning supervisé
- Optimisation des préférences
- Expérimentation locale
Cas d'usage
- Un flux uniquement sur portable
- Fine-tuning privé
- Transformer un modèle affiné en service
Fonctionnalités clés
Une configuration, une commande
L'idée centrale est qu'un seul fichier YAML décrit toute la tâche. Vous lancez soup init pour générer une configuration de départ, modifiez quelques champs, puis lancez soup train. Soup lit la configuration, vérifie votre GPU et choisit une taille de lots et une quantification adaptées. Pour qui a déjà maintenu un dossier de scripts d'entraînement en shell, c'est là tout l'attrait : la configuration fait office de documentation.
Streaming de couches pour petits GPU
Le streaming de couches est la fonction qui attire le plus l'attention. Au lieu de charger tout le modèle de base figé dans la VRAM, Soup le garde hors mémoire et alimente le GPU une couche de décodeur à la fois. Sur une RTX 3050 Laptop avec 4 Go, le projet rapporte un modèle 8B tournant à 3,32 Go de mémoire de pointe. Un résultat énorme. Le hic, c'est que c'est optionnel et encore en BETA, et les chiffres de débit viennent d'une version ancienne précise, donc prenez la vitesse comme un plancher, pas comme une promesse.
Évaluation intégrée et filtrage des checkpoints
Soup ne s'arrête pas à l'entraînement. Il dérive des évaluations de votre configuration et filtre les checkpoints en fonction d'elles, donc une exécution qui régresse est signalée au lieu d'être sauvegardée en silence. Pour les équipes qui entraînent souvent, cela compte plus que la vitesse brute. Vous voulez un pipeline qui vous prévient quand un checkpoint est pire que le précédent.
Service compatible avec OpenAI
La commande soup serve transforme un modèle entraîné en service d'API en une seule commande. Elle expose les endpoints standards /v1/chat/completions, /v1/models et /health, prend en charge les réponses en streaming, et peut basculer vers des backends vLLM ou SGLang pour un débit plus élevé. Les adaptateurs LoRA peuvent être servis directement, le modèle de base étant résolu depuis la configuration de l'adaptateur, donc vous n'avez pas à fusionner les poids à la main au préalable.
Local d'abord, sans cloud
Tout est conçu pour tourner sur du matériel que vous possédez déjà. Aucun cloud requis. Pas de compte obligatoire, pas de tableau de bord hébergé, et aucune donnée ne quitte votre machine sauf si vous le configurez. Pour les équipes qui traitent des données sensibles, c'est souvent le facteur décisif face à un service d'entraînement géré.
Outils de données et commandes d'inspection
L'installation légère de soup-cli inclut tout de même soup data ... et des commandes d'inspection qui fonctionnent sans PyTorch. Cela veut dire que vous pouvez nettoyer et inspecter votre jeu de données sur une machine sans aucun GPU. Préparez maintenant, entraînez plus tard.
Avantages et inconvénients
Avantages
- Open source sous Apache-2.0, donc aucune dépendance à un fournisseur et un code entièrement auditable.
- Un seul fichier YAML de configuration remplace la plupart du scripting et de la mise en route que le fine-tuning exige d'ordinaire.
- Le streaming de couches rend de vraiment gros modèles entraînables sur de petits GPU grand public.
- Le service et l'évaluation font partie du même outil, ce ne sont pas des utilitaires séparés à relier.
- Fonctionne entièrement hors ligne, ce qui garde données et poids sur votre propre matériel.
Inconvénients
- Le streaming de couches, la fonction vedette, est encore en BETA et doit être activé à la main, donc ce n'est pas un choix qu'on configure une fois pour toutes.
- Les meilleures performances supposent un GPU CUDA ; le support Apple Silicon et CPU est expérimental et lent.
- L'installation divisée peut perdre les débutants, car un simple `pip install soup-cli` ne vous laisse pas entraîner tant que vous n'ajoutez pas l'extra `[train]`.
- La documentation est dense et propre à chaque version, donc les conseils de guides plus anciens peuvent ne pas correspondre à la version actuelle.
Questions fréquentes
C'est un outil en ligne de commande open source pour le fine-tuning et le post-entraînement de grands modèles de langage. Vous définissez une tâche dans un fichier YAML et lancez soup train, et il gère pour vous la détection du GPU, la quantification et les lots.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Soup CLI.
Alternatives à Soup CLI
Forefront
Forefront · ProgrammationForefront est une plateforme web pour construire avec de l'IA open source. Elle vous laisse affiner les principaux modèles de langage open source sur vos propres données, évaluer leurs performances et les exécuter via une API ou les exporter pour les héberger vous-même. Les développeurs qui veulent le confort d'une plateforme fermée mais tiennent à rester propriétaires de leurs modèles et de leurs données sont le public visé ici.

Startkit
StartKit.AI · ProgrammationStartkit est un boilerplate pour créer des produits SaaS d'IA et des wrappers d'IA. Voyez-le comme un boilerplate de startup IA avec les parties ennuyeuses déjà branchées : authentification, paiements Stripe et Lemon Squeezy, limites d'usage, e-mail transactionnel et un kit de démarrage d'API IA qui parle à OpenAI, Anthropic, Groq ou Llama. Vous clonez le dépôt, fixez votre prix et attaquez la partie du produit pour laquelle les gens paient vraiment. Il repose sur Next.js au-dessus de React et Tailwind, donc une bonne partie du code boilerplate vous semble déjà familière.
Testim
Tricentis · ProgrammationTestim est une plateforme d'automatisation des tests dopée à l'IA, qui sert à créer et exécuter des tests de bout en bout sur des applications web, mobiles et Salesforce. Elle s'appuie sur l'apprentissage automatique pour garder les tests stables quand une interface change, alors les équipes passent moins de temps à réparer des sélecteurs cassés. Pas mal pour un outil de tests automatisés que vous pouvez utiliser dès aujourd'hui. Vous créez des tests en enregistrant des actions dans un navigateur, puis vous ajoutez du JavaScript quand vous avez besoin de plus de contrôle. C'est un choix solide pour une équipe QA bien occupée.