
TraceLLM
TraceLLM · Programmation
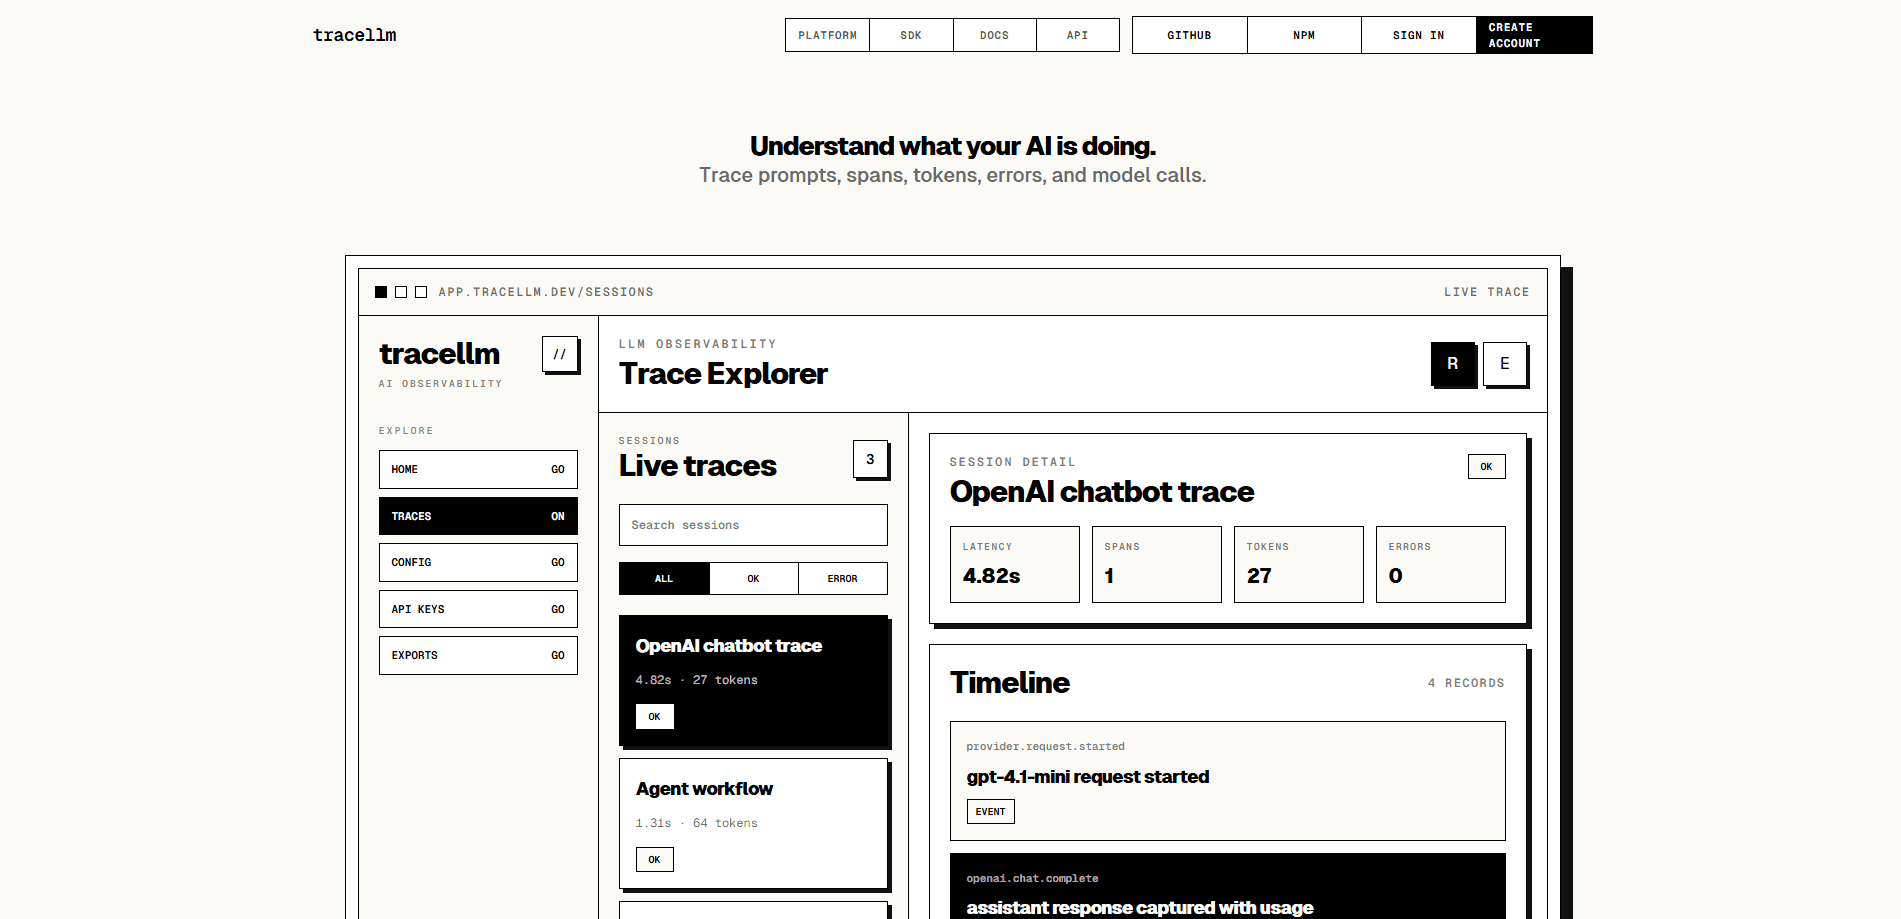
TraceLLM est une plateforme d'observabilité de LLM à traitement local, pensée pour les équipes qui exploitent des applications d'IA en production. Elle enregistre les sessions, les spans, les prompts et les sorties (quand vous l'autorisez), la consommation de tokens, la latence et les erreurs dans les chatbots, les agents et les pipelines RAG, puis affiche le tout sur une seule chronologie. Une couche de politiques décide de ce qui est capturé, masqué ou écarté, et un chemin d'export OpenTelemetry transmet les traces sélectionnées à des backends comme SigNoz ou Honeycomb. Qu'est-ce que ça vous apporte ? Un seul endroit pour répondre à la question de savoir pourquoi une réponse a mal tourné.
À propos de TraceLLM
Qu'est-ce que TraceLLM
TraceLLM est une plateforme d'observabilité conçue spécifiquement pour les applications d'IA. Au lieu de disperser les indices entre les tableaux de bord des fournisseurs, les logs de l'application et les rapports de bugs des utilisateurs, elle donne à chaque flux d'IA une seule chronologie : ce qui l'a déclenché, quel appel au modèle s'est exécuté, combien de temps a duré chaque étape, combien de tokens ont été brûlés et où ça a échoué.
Le projet est open source sous licence MIT, avec le code sur GitHub et l'application hébergée sur tracellm.in. Il est né d'un problème courant : une réponse erronée apparaît en production, mais le code de l'application, le magasin vectoriel et le fournisseur du modèle ne détiennent chacun que des fragments de l'histoire. TraceLLM recoud ces fragments en un seul enregistrement inspectable.
La principale limite, c'est la maturité. TraceLLM est jeune. Le SDK Node est un paquet de workspace plutôt qu'une version publiée sur npm, et la documentation renvoie encore à un guide de démarrage local. Si vous avez besoin d'un outil éprouvé avec une grande galerie d'intégrations, ce n'est pas encore ça. Si vous voulez lire le code et l'auto-héberger, le fit est propre.
Premiers pas
- Créez un compte sur tracellm.in, ou lancez le stack en local avec
pnpm install,pnpm infra:buildetpnpm infra:up. - Créez un projet et copiez la clé API propre au projet (
trllm_...). - Installez le SDK Node dans votre application et démarrez une session avec votre endpoint, la clé API et le nom du service.
- Enveloppez vos appels au modèle dans des spans, puis enregistrez les événements, les comptages de tokens et les erreurs au fil de l'eau.
- Ouvrez l'Explorateur de traces pour inspecter chaque session et, si vous le souhaitez, ajoutez un endpoint OTLP pour transmettre les traces à votre propre backend.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de TraceLLM.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Ingénieurs IA et développeurs backend
- Petites équipes produit sans budget de plateforme
- Personnel de support axé sur le débogage
Tâches
- Tracer une mauvaise réponse de chatbot
- Surveiller la dépense en tokens
- Garder les erreurs attachées aux vraies sessions
- Exporter vers un APM existant
Cas d'usage
- Livrer un agent en production et avoir besoin d'un moyen de rejouer une conversation qui échoue
- Travailler sous des règles de contenu où les prompts contiennent des données personnelles
- Uniformiser l'observabilité sur plusieurs services d'IA
Fonctionnalités clés
Traçage des sessions et des spans
TraceLLM organise un flux d'IA comme une session avec des spans imbriqués. Une session contient le tour d'utilisateur. Chaque span couvre une unité de travail, comme un appel à un fournisseur, une étape de récupération ou l'exécution d'un outil. C'est le cœur du traçage de LLM. Vous démarrez une session, ouvrez des spans à l'intérieur, enregistrez les événements au fur et à mesure et fermez les deux avec un statut. La structure transforme un tas désordonné de lignes de log en une exécution rejouable.
Contrôles de politique de capture
Tout ne doit pas être stocké. Vous définissez la politique par projet : si le contenu des prompts et des sorties est capturé, combien de métadonnées et d'usage sont conservés et si le masquage cache les clés API et les tokens bearer avant qu'ils n'atteignent la base de données. C'est là que le traçage de prompts gagne ses garde-fous. L'échantillonnage peut capturer de 0 % à 100 % des sessions, et certains types de spans peuvent être entièrement ignorés.
Suivi de la consommation de tokens et de la latence
Chaque span peut porter les comptages de tokens et les durées à côté de ses attributs. Coût et vitesse se trouvent dans la même vue que l'appel lui-même. Vous voyez quelle étape est lente et laquelle est chère. Sans joindre deux tableaux de bord. C'est la différence entre savoir que la facture a augmenté et savoir quel prompt en est la cause.
Export OpenTelemetry et OTLP
TraceLLM conserve sa propre chronologie et peut transmettre des traces sélectionnées à un collecteur OTLP HTTP qui vous appartient. Vous collez un endpoint, choisissez les signaux à transmettre, et les données partent vers SigNoz, Honeycomb, Tempo, Datadog ou tout backend compatible OTLP. Les équipes qui utilisent déjà un APM gardent leur stack actuel et traitent TraceLLM comme la couche spécifique à l'IA par-dessus.
Instrumentation agnostique du fournisseur
Voyez cela comme un outil de débogage IA qui ne vous enferme pas chez un fournisseur. Les spans se moquent du modèle que vous appelez. TraceLLM fonctionne avec OpenAI, Claude, Gemini, des routeurs maison, des services internes et des flux en forme de MCP, parce que vous enveloppez vous-même l'appel au lieu de dépendre d'un plugin spécifique. Changer de modèle ou de passerelle ne casse pas votre configuration de traçage.
Clés API propres au projet
Chaque clé API associe les requêtes à un projet et transporte la politique de capture de ce projet dans le runtime du SDK. Créez plusieurs clés. Nommez-les. Révoquez les anciennes quand un service cesse de les utiliser. Ainsi, une politique partagée ne fuit pas vers des applications sans rapport, et la rotation des clés devient une tâche simple en deux étapes.
Avantages et inconvénients
Avantages
- Sous licence MIT et open source, donc aucune souscription et le code est lisible.
- La conception locale vous laisse auto-héberger et garder les données de traces sur votre propre infrastructure.
- La politique de capture sépare contenu, métadonnées, usage et erreurs, ce qui aide avec les prompts sensibles.
- L'export OTLP signifie que vous n'abandonnez pas une configuration SigNoz ou Datadog existante.
- Les spans agnostiques du fournisseur couvrent OpenAI, Claude, Gemini et les passerelles maison sans plugins.
Inconvénients
- Le SDK Node n'est pas encore publié sur npm, donc les premiers utilisateurs l'installent depuis le dépôt ou comme paquet de workspace.
- C'est un projet jeune, donc attendez-vous à moins d'intégrations prêtes à l'emploi et à moins d'exemples communautaires que n'en offrent les outils matures.
- L'auto-hébergement signifie que vous gérez vous-même le déploiement, les mises à jour et le dimensionnement du stockage.
- La documentation est encore en cours de rédaction, donc certaines étapes de mise en place demandent de lire le code source.
Questions fréquentes
TraceLLM sert à déboguer et surveiller les applications d'IA en production. Il enregistre les sessions, les spans, la consommation de tokens, la latence et les erreurs des chatbots, des agents et des pipelines RAG, puis les affiche sur une seule chronologie pour que vous trouviez pourquoi une réponse précise a mal tourné.
Contenus associés
Découvrez des outils, des compétences et des articles liés à TraceLLM.
Alternatives à TraceLLM
Forefront
Forefront · ProgrammationForefront est une plateforme web pour construire avec de l'IA open source. Elle vous laisse affiner les principaux modèles de langage open source sur vos propres données, évaluer leurs performances et les exécuter via une API ou les exporter pour les héberger vous-même. Les développeurs qui veulent le confort d'une plateforme fermée mais tiennent à rester propriétaires de leurs modèles et de leurs données sont le public visé ici.

Startkit
StartKit.AI · ProgrammationStartkit est un boilerplate pour créer des produits SaaS d'IA et des wrappers d'IA. Voyez-le comme un boilerplate de startup IA avec les parties ennuyeuses déjà branchées : authentification, paiements Stripe et Lemon Squeezy, limites d'usage, e-mail transactionnel et un kit de démarrage d'API IA qui parle à OpenAI, Anthropic, Groq ou Llama. Vous clonez le dépôt, fixez votre prix et attaquez la partie du produit pour laquelle les gens paient vraiment. Il repose sur Next.js au-dessus de React et Tailwind, donc une bonne partie du code boilerplate vous semble déjà familière.
Testim
Tricentis · ProgrammationTestim est une plateforme d'automatisation des tests dopée à l'IA, qui sert à créer et exécuter des tests de bout en bout sur des applications web, mobiles et Salesforce. Elle s'appuie sur l'apprentissage automatique pour garder les tests stables quand une interface change, alors les équipes passent moins de temps à réparer des sélecteurs cassés. Pas mal pour un outil de tests automatisés que vous pouvez utiliser dès aujourd'hui. Vous créez des tests en enregistrant des actions dans un navigateur, puis vous ajoutez du JavaScript quand vous avez besoin de plus de contrôle. C'est un choix solide pour une équipe QA bien occupée.