
UbiOps
UbiOps · Productivité · Marketing · Apprentissage · Autres
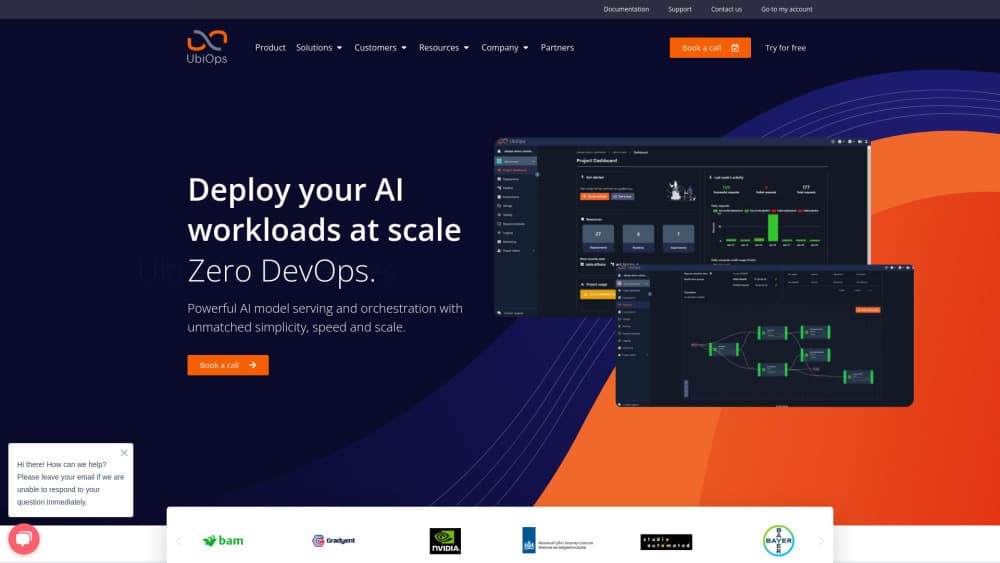
UbiOps est une plateforme de serving de modèles IA et de MLOps qui transforme votre code Python ou un LLM en API scalable, sur votre cloud, votre matériel ou les deux à la fois.
À propos de UbiOps
About
Qu'est-ce qu'UbiOps
UbiOps est une plateforme néerlandaise destinée aux équipes qui doivent mettre de l'IA en production sans construire leur propre couche de serving de modèles sur GPU. Vous apportez le code du modèle ou une image de conteneur. UbiOps se charge de construire le conteneur, de publier l'endpoint, de gérer la file de requêtes, l'équilibrage, l'autoscaling, puis les journaux et métriques qui vont avec.
Le vrai argument, c'est la liberté d'infrastructure. Un plan de contrôle se place au-dessus de vos environnements de calcul et les traite comme un seul pool, si bien qu'une charge peut tourner aujourd'hui sur un GPU local et basculer cette nuit vers une région de cloud public. C'est ce qu'on appelle l'IA en cloud hybride, et c'est pourquoi les hôpitaux, les distributeurs d'énergie et les administrations soumis à des règles de résidence des données la retiennent : ils ne peuvent pas confier leurs informations à un fournisseur d'API de modèles.
Autant dire les limites tout de suite. Il n'y a ni constructeur visuel de modèles ni catalogue d'applications prêtes à l'emploi. Il vous faut du code qui fonctionne, une certaine aisance avec Docker et une idée précise de ce que votre endpoint doit recevoir. Ceux qui cherchent un créateur de chatbots sans programmation se trompent de produit.
Premiers pas
- Créez un compte sur l'interface web d'UbiOps, puis installez le client Python ou la CLI si vous travaillez par scripts.
- Définissez un environnement avec vos dépendances, ou poussez votre propre image Docker quand les runtimes Python fournis ne conviennent pas.
- Créez un deployment, envoyez votre code et déclarez le schéma d'entrée et de sortie de son API.
- Choisissez un type d'instance, fixez le minimum et le maximum d'instances, et activez la mise à zéro si le trafic arrive par pics.
- Envoyez une requête à l'endpoint pour tester, puis enchaînez plusieurs deployments dans un pipeline quand il vous faut un flux complet.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de UbiOps.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Ingénieurs machine learning
- Équipes data science des secteurs réglementés
- Ingénieurs plateforme et MLOps
Tâches
- Servir un modèle en endpoint REST
- Faire tourner l'inférence de modèles de langage sur vos GPU
- Enchaîner prétraitement, modèle et post-traitement
- Des entraînements qui ont besoin de capacité en pointe
Cas d'usage
- Un service de vision par ordinateur aux pics imprévisibles
- Un proof of concept qui doit devenir un produit
- Une sortie d'un fournisseur cloud unique
Fonctionnalités clés
Des deployments avec endpoint d'API géré
Chaque deployment reçoit son endpoint HTTP versionné, sa file de requêtes et la validation des entrées. Vous envoyez du code dans un runtime pris en charge ou votre propre conteneur, et UbiOps le construit, le démarre et l'expose. Une nouvelle version se promeut ou se restaure sans supprimer la précédente, donc une mauvaise mise en ligne se corrige en deux clics.
Autoscaling avec mise à zéro
La plateforme suit le volume de requêtes et ajoute ou retire des instances d'elle-même. La mise à zéro éteint complètement les deployments inactifs, si bien qu'un modèle appelé quelques fois par jour ne facture pas 24 heures de GPU à l'arrêt. Les groupes de types d'instances permettent à un deployment de privilégier vos GPU locaux et de basculer vers le cloud quand ils sont occupés.
Pipelines et opérateurs de flux
L'orchestration IA est la partie que presque toutes les équipes sous-estiment, et c'est là que la plateforme se rentabilise. Les pipelines relient plusieurs deployments en un service appelable, et chaque objet à l'intérieur monte en charge séparément. Les opérateurs fournis découpent, réassemblent, filtrent et routent les données selon des conditions, ce qui couvre l'essentiel de la plomberie qu'on écrit d'habitude à la main. Un pipeline s'importe, s'exporte et se partage avec l'équipe.
Expériences et exécutions d'entraînement
Au-delà du serving, UbiOps lance des jobs d'entraînement sur la même infrastructure. Une expérience fixe l'environnement, le code et le matériel ; les exécutions tournent dessus, et vous comparez les résultats entre exécutions dans l'interface web. Les artefacts arrivent dans un stockage que vous contrôlez, donc le modèle entraîné est à une étape du deployment.
Services personnalisés et votre propre image Docker
Les services exposent des serveurs HTTP longue durée à l'intérieur d'un deployment. C'est ainsi que les équipes font tourner des serveurs GenAI à haut débit qui ne rentrent pas dans le format de requête standard. Avec les images Docker maison, cette voie couvre les piles d'inférence de type vLLM, les applications multi-endpoints et tout ce qui attend du HTTP brut.
Supervision, versionnement et contrôle d'accès
Journaux, métriques d'usage et alertes sont inclus, donc un deployment en panne apparaît avant qu'un utilisateur ne le signale. Accès par rôles, pistes d'audit et chiffrement couvrent le volet conformité, et les réglages de traitement des données vous laissent décider si les payloads sont conservés.
Avantages et inconvénients
Avantages
- Tourne sur votre matériel, sur un cloud public ou sur un mélange des deux, ce que peu de services d'inférence managés autorisent.
- L'autoscaling inclut la mise à zéro, donc les modèles à pics ou rarement sollicités restent abordables.
- Les pipelines avec opérateurs intégrés réduisent le code de colle dans les flux IA à plusieurs étapes.
- Le versionnement et le retour arrière rendent chaque mise à jour de modèle moins risquée pour une équipe sans processus de release dédié.
- La même plateforme sert les modèles et lance les entraînements, ce qui évite un second fournisseur de calcul.
Inconvénients
- Aucune grille tarifaire publique. Il faut parler au service commercial avant d'estimer la facture mensuelle, ce qui ralentit la planification budgétaire.
- Il faut écrire du code de deployment et comprendre les conteneurs. Un analyste ou un utilisateur métier n'ira pas loin seul.
- L'interface suppose que vous connaissez le vocabulaire MLOps (environnements, types d'instances, requêtes), donc la première semaine demande de vraies lectures.
- Rien ici n'entraîne ni n'ajuste un modèle de fondation à votre place. La plateforme exécute votre code, le travail de modélisation reste de votre côté.
Questions fréquentes
La plateforme prend votre code de modèle ou de traitement de données et l'exécute comme une API de production. Elle construit le conteneur, démarre le service, répartit les requêtes entre instances et ajuste la capacité selon le trafic.
Contenus associés
Découvrez des outils, des compétences et des articles liés à UbiOps.
Alternatives à UbiOps

Udon
Udon · Programmation · ProductivitéUdon transforme un Mac Apple Silicon en serveur personnel piloté depuis le navigateur, avec conteneurs, partages de fichiers et un administrateur système IA en option.

offstage
offstage cloud · Programmation · Productivitéoffstage confie aux agents IA et aux jobs de CI un vrai Mac : un compte macOS 27 sur Apple silicon, piloté par API et facturé à la seconde.

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · Programmation · ProductivitéBotBus permet de contrôler des agents IA depuis son téléphone ou sa montre, même quand ils tournent sur l’ordinateur resté au bureau : vous validez les commandes, lancez des tâches et lisez les résultats.