

Unbody
Unbody (Unbody Labs) · Programmation · Autres
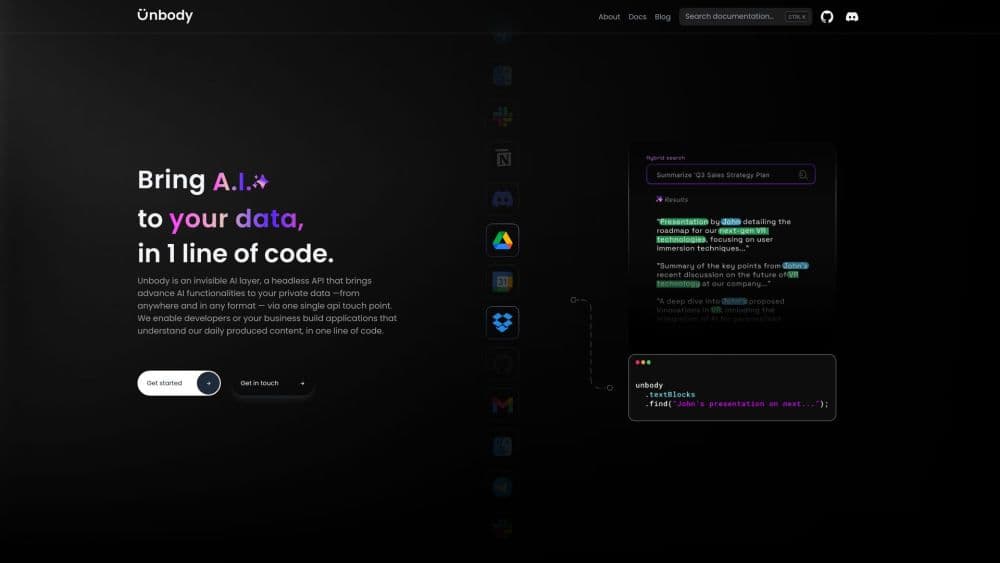
Unbody est un backend natif d'IA qui ingère, enrichit et vectorise du contenu, puis le sert via une seule API GraphQL pour la recherche sémantique, les chatbots et les réponses générées.
À propos de Unbody
About
Qu'est-ce qu'Unbody
Unbody est un backend destiné aux équipes qui veulent des fonctions d'IA sans assembler l'infrastructure à la main. Vous connectez une source de données, choisissez quelques étapes d'enrichissement et interrogez le résultat depuis un point d'entrée GraphQL unique. La promesse tenait en une phrase : un backend RAG et backend pour chatbots dans la même boîte, sans base de données vectorielle, service d'embeddings, surcouche LLM ni file de tâches à maintenir en phase.
L'architecture se répartit en quatre couches. La perception couvre l'ingestion, l'analyse, l'enrichissement et la vectorisation. La mémoire conserve les objets et les vecteurs produits. Le raisonnement exécute les appels aux modèles et les prompts. L'action expose le tout par des API et des SDK. Les connecteurs fournis couvrent Google Drive, Discord et GitHub, et l'API Push accepte toute autre source dès que vous définissez un schéma. Les enrichisseurs ajoutent résumés, mots-clés, légendes d'images, texte OCR et pages aspirées avant l'indexation.
Un point compte davantage que n'importe quelle fonction : Unbody n'est plus développé. Le dépôt GitHub est archivé, l'application hébergée sur app.unbody.io ne se charge plus et le domaine de documentation renvoie des erreurs. Unbody Labs travaille désormais sur Adapt, un cadre de mémoire distinct. Cette page sert de trace de ce que la plateforme proposait et de guide du code archivé si vous comptez l'exploiter vous-même. Le code reste au stade alpha, et personne ne publie de correctifs.
Pour démarrer
- Installez Node.js 20 ou 22, Docker, Docker Compose et yarn. Clonez le dépôt unbody-io/unbody, puis lancez yarn pour récupérer les dépendances.
- Copiez .env.example vers .env.local et ajoutez une clé API OpenAI. Cette clé alimente les embeddings et les points d'entrée génératifs.
- Démarrez les services annexes avec docker compose up, puis exécutez yarn start. Les tâches d'indexation passent par Temporal, dont le tableau de bord écoute sur le port 8233.
- Créez un projet et ajoutez une source avec la commande unbody-cli source add. Vous pouvez ensuite suivre les premiers fichiers dans les étapes d'analyse, d'enrichissement et de vectorisation.
- Interrogez le projet depuis l'API GraphQL ou le SDK TypeScript. Le SDK regroupe les appels de récupération, de recherche et de génération dans un client chaînable.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Unbody.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs backend qui ajoutent une recherche ou un chat à un produit existant
- Petites équipes produit sans ingénieur machine learning
- Équipes dont le contenu vit déjà dans Google Drive, Discord ou GitHub
Tâches
- Transformer une archive de documents en base de connaissances interrogeable
- Ajouter un chatbot documentaire à un site
- Résumer et étiqueter du contenu par lots
- Tester la similarité sémantique ou visuelle
Cas d'usage
- Évaluer un backend natif d'IA avant de le construire en interne
- Maintenir un ancien projet en vie
- Enseigner ou démontrer un pipeline RAG
Fonctionnalités clés
Une API GraphQL unique pour le contenu
Tout ce que la plateforme stocke s'interroge depuis un point d'entrée GraphQL qui fait office d'API de base de connaissances, avec filtres, tri, pagination et objets imbriqués dans la même requête. Vous demandez les champs utiles et recevez des enregistrements enrichis, résumés et mots-clés générés compris. Des points d'entrée séparés pour l'image et la vidéo couvrent le traitement des médias, et l'API d'administration gère projets et sources sans passer par le tableau de bord.
Connecteurs prêts à l'emploi et API Push
Google Drive, Discord et GitHub disposent d'intégrations déjà écrites. Chacune définit un point d'entrée, un dossier ou un canal par exemple, puis extrait le contenu selon un calendrier. Pour le reste, l'API Push accepte des enregistrements dans un schéma que vous définissez et couvre bases internes, archives exportées et flux maison. Cet ensemble réglait le démarrage habituel d'un produit de connaissance sans ETL sur mesure.
Pipelines d'enrichissement
Avant l'indexation, un pipeline configurable analyse le contenu et lance des enrichisseurs sur le résultat. AutoSummary rédige des résumés courts, AutoKeywords extrait les termes importants, et AutoVision produit des légendes, récupère le texte par OCR et étiquette les objets. Les crawlers transforment des pages web en enregistrements structurés. Les pipelines se montent dans le tableau de bord ou via l'API d'administration, et des plugins maison peuvent être enregistrés quand l'ensemble fourni ne suffit pas.
Cinq modes de recherche
L'API propose recherche sémantique, recherche par mots-clés et recherche hybride, plus deux modes de similarité : similarité d'enregistrements et similarité visuelle. La recherche sémantique travaille sur le sens, ce qui aide quand les mots de l'utilisateur ne correspondent pas au document. Celle par mots-clés reste prévisible pour les termes exacts. L'hybride combine les deux. La similarité visuelle s'appuie sur les vecteurs d'image, donc la photo d'un produit retrouve ses semblables dans un catalogue.
Recherche générative et sortie JSON
Deux modes de génération reposent sur la récupération. From One lance un prompt sur chaque objet et peut insérer la valeur de ses champs dans le texte. From Many prend un ensemble d'objets et produit un résultat unique pour tous, ce qui convient aux synthèses et aux comparaisons. Un mode distinct renvoie du JSON structuré validé par un schéma, pensé pour extraire des champs plutôt que de la prose. Le modèle se choisit par plugin, donc le backend ne dépend pas d'un seul fournisseur.
SDK TypeScript et composants d'interface
Le SDK TypeScript transforme les appels GraphQL en client chaînable : prendre une collection, filtrer, chercher, choisir des champs, puis générer. Des projets de démarrage existent pour Next.js, Nuxt, NestJS et Express, et la couche frontend fournit des composants prêts pour React et Vue. Rien de tout cela ne vous enferme dans un service hébergé, le même SDK pointant vers une instance locale.
Avantages et inconvénients
Avantages
- Une API couvre ingestion, enrichissement, vectorisation, recherche et génération, ce qui supprime une pile de services séparés.
- Le code est public sous Apache 2.0 : vous pouvez lire l'implémentation, la forker et l'exécuter sur votre matériel.
- Les connecteurs Google Drive, Discord et GitHub ramènent la première démonstration fonctionnelle à une après-midi.
- L'enrichissement se fait dans le pipeline, donc résumés, mots-clés et étiquettes d'images existent avant la première requête.
- Le SDK TypeScript et les projets de démarrage réduisent la quantité de GraphQL à écrire à la main.
Inconvénients
- Le dépôt est archivé et l'application hébergée est hors ligne. Il n'y a ni correctifs de sécurité, ni corrections de bugs, ni support.
- Le site de documentation ne répond plus, donc les détails d'installation viennent du code, du README et d'anciens billets de blog.
- C'était un logiciel alpha : les API changeaient d'une version à l'autre et certains plugins sont restés inachevés.
- L'auto-hébergement exige Docker, Node, un worker Temporal et une clé OpenAI, plus de la patience pour déboguer une pile que personne ne maintient.
Questions fréquentes
Unbody était un backend pour les fonctions d'IA. Il récupérait du contenu depuis des sources comme Google Drive et Discord, l'enrichissait avec des résumés et des métadonnées, stockait des vecteurs et servait le résultat via une API GraphQL. Les équipes l'utilisaient pour la recherche sémantique, les chatbots documentaires et les réponses générées.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Unbody.
Alternatives à Unbody

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.