
Unreal Speech
Unreal Speech · Voix et langage
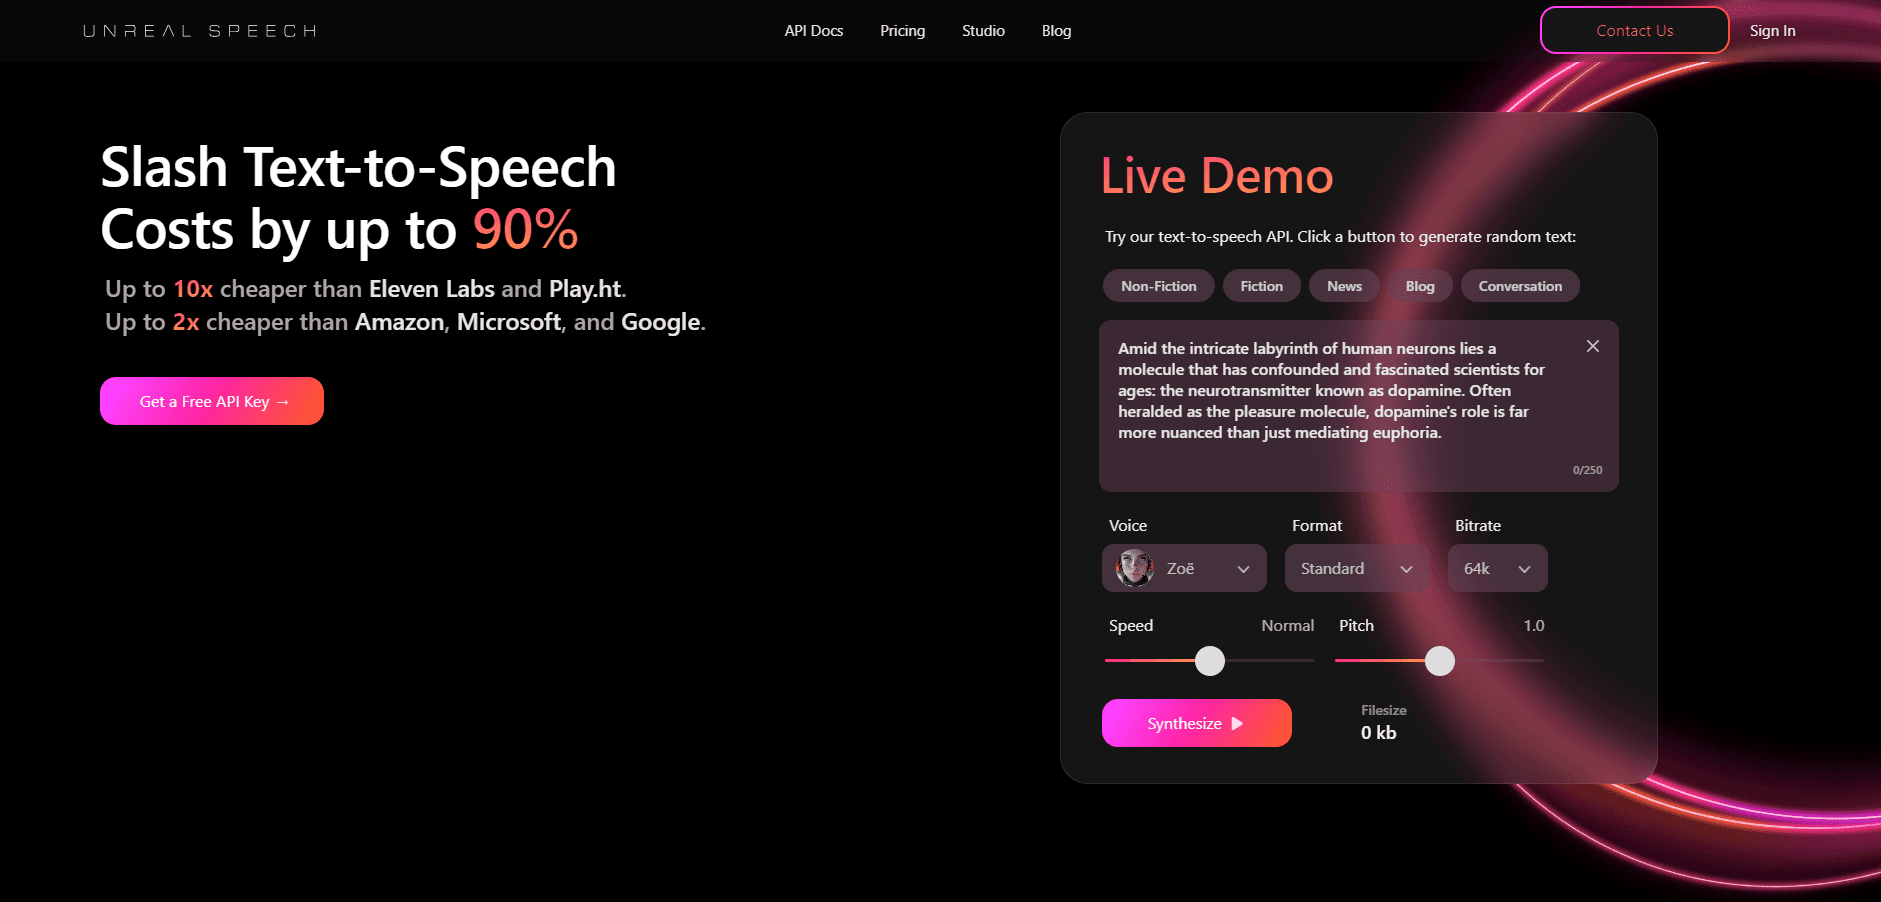
Unreal Speech est une API de synthèse vocale qui transforme un texte écrit en voix IA naturelles, renvoie l'audio en environ 300ms et fournit un horodatage par mot pour une fraction du prix des API vocales courantes.
À propos de Unreal Speech
About
Qu'est-ce qu'Unreal Speech ?
Unreal Speech est une API de synthèse vocale conçue pour ceux qui veulent ajouter de la voix à une application sans payer les tarifs de l'IA vocale haut de gamme. Vous envoyez du texte à un point d'accès et recevez de l'audio parlé via un simple appel REST ou une connexion websocket en streaming. L'entreprise présente le service comme une API de synthèse de la parole environ 11 fois moins chère qu'ElevenLabs, tout en gardant une sortie vocale proche de l'humain. Ceux qui comparent les outils vocaux cherchent souvent une alternative à ElevenLabs plus abordable, et c'est sur le prix que celle-ci se démarque.
Le travail principal est de générer de la voix à grande échelle. Au-delà de l'audio brut, Unreal Speech renvoie un horodatage par mot qui situe le début et la fin de chaque terme, exactement ce qu'il faut pour les sous-titres, la mise en surbrillance façon karaoké et la vidéo synchronisée. Il gère aussi les longs travaux : une seule requête couvre jusqu'à 10 heures d'audio via le point d'accès de tâches asynchrones, donc les livres audio et les narrations longues ne s'effondrent pas sur un délai d'attente.
Les limites méritent d'être connues. Le palier gratuit couvre un quota fixe de caractères par mois, donc les projets en production passent à une formule payante ou à une facturation à l'usage. Le catalogue de voix est plus restreint que celui des grands fournisseurs cloud, et la qualité dépend de la voix et du modèle choisis. C'est aussi un produit qui vit dans l'API : il n'existe pas de studio pour retoucher une narration à la main, donc ceux qui ne codent pas ont besoin d'un autre outil pour le piloter.
Pour commencer
- Récupérez une clé d'API gratuite sur le site d'Unreal Speech, sans carte pour démarrer.
- Envoyez une requête POST au point d'accès /stream ou /speech avec votre texte, un VoiceId et des réglages comme le débit, la vitesse et la hauteur.
- Choisissez un codec tel que libmp3lame ou pcm_mulaw et ajustez la hauteur et la vitesse pour façonner la voix.
- Pour un texte long, basculez vers le point d'accès /synthesisTasks et interrogez-le jusqu'à ce que l'audio et l'horodatage soient prêts.
- Enregistrez le MP3 renvoyé, ou reliez l'horodatage à une couche de sous-titres ou de surbrillance dans votre application.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Unreal Speech.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs d'applications et de back-end
- Petits studios et créateurs indépendants
- Équipes de contenu qui produisent de l'audio régulièrement
Tâches
- Générer une narration pour la vidéo
- Transformer de longs documents en livres audio
- Ajouter de la voix à une application ou à un bot
Cas d'usage
- Lancer des fonctions vocales avec un budget de startup
- Créer un outil de lecture ou d'accessibilité
- Localiser la narration pour toucher plus de monde
Fonctionnalités clés
Audio en streaming en environ 300ms
Le point d'accès /stream renvoie l'audio rapidement, l'entreprise annonçant une réponse d'environ 300ms. C'est la voie centrale du TTS en streaming, et celle qu'on privilégie quand la latence compte : l'audio arrive en flux de données, pas sous forme de fichier qu'il faut attendre en entier. Dans les assistants, les jeux et les interfaces en direct, cet écart décide si la conversation paraît fluide ou cassée.
Horodatage par mot
Unreal Speech renvoie des données de temps qui marquent le début et la fin de chaque mot, livrées en JSON à côté de l'audio. C'est la base des sous-titres, de la surbrillance façon karaoké et du texte qui suit la voix avec précision. Une route websocket plus récente diffuse audio et horodatages ensemble, donc la couche de surbrillance se met à jour en temps réel sans attendre le clip complet.
Synthèse longue jusqu'à 10 heures
Le point d'accès /synthesisTasks traite les gros travaux en une seule requête, l'entreprise citant une prise en charge jusqu'à 10 heures d'audio. Cela convient aux livres audio, aux cours longs et aux rapports complets qu'il faudrait sinon découper et recoller. Vous soumettez le texte, interrogez la tâche et récupérez l'audio terminé avec son fichier d'horodatage à la fin.
Voix naturelles avec contrôle de vitesse et de hauteur
Chaque requête prend un VoiceId et des valeurs de vitesse, de hauteur et de débit, donc vous façonnez le rendu sans réenregistrer. Le débit monte à 320k pour une lecture propre, et les réglages de vitesse et de hauteur permettent de coller à un personnage ou à un rythme précis. Le catalogue s'appuie sur un ensemble soigné de voix nommées plutôt que sur des centaines d'options, ce qui simplifie le choix mais réduit la variété.
Codecs et formats flexibles
L'API produit l'audio dans des codecs comme libmp3lame et pcm_mulaw, couvrant la diffusion MP3 courante et l'audio de téléphonie à bande réduite. Vous réglez la fréquence d'échantillonnage et le débit selon la plateforme visée, donc le même service sert à la lecture web comme aux flux de type téléphone. Cette amplitude vous épargne la conversion de formats après coup.
API REST et WebSocket simple
Le service s'articule autour de quelques points d'accès : /stream pour les clips courts, /speech pour les textes moyens avec URL d'horodatage, /synthesisTasks pour les longs travaux et /streamWithTimestamps pour l'audio et le temps en temps réel. L'authentification est un simple jeton bearer, et la documentation montre des exemples en Python, Node et cURL. Cette sobriété explique qu'il entre dans un prototype en une après-midi.
Avantages et inconvénients
Avantages
- Le prix est l'argument phare : comme option de TTS économique, il coûte plusieurs fois moins cher qu'ElevenLabs, ce qui compte quand un projet génère beaucoup de volume vocal.
- Le palier gratuit permet de tester l'API avec de vrais caractères avant de payer, donc vous jugez la qualité avec votre propre script.
- L'horodatage par mot arrive avec l'audio, ce qui supprime l'étape supplémentaire d'aligner sous-titres ou surbrillances à la main.
- Le point d'accès de tâches traite jusqu'à 10 heures de parole en une seule tâche, donc les livres audio et les longs rapports n'ont pas besoin d'être découpés.
- Une route websocket en streaming démarre l'audio en environ 300ms et garde vives les réponses vocales en temps réel.
Inconvénients
- Le catalogue de voix est plus court que celui des grands fournisseurs de voix cloud, donc certains accents ou langues précis peuvent manquer.
- La précision et le rythme varient selon la voix et le modèle, donc il vaut mieux tester un échantillon avant de consacrer tout un projet à un seul choix.
- C'est un produit uniquement API, sans éditeur visuel, ce qui oblige ceux qui ne codent pas à passer par un autre outil pour livrer une narration finie.
- La qualité sur les paliers gratuits ou remisés est plafonnée par les caractères mensuels, donc un usage intensif peut épuiser le quota plus vite que prévu.
Questions fréquentes
Unreal Speech est une API de synthèse vocale et une API TTS qui convertit un texte écrit en voix IA naturelles. Les développeurs envoient du texte à des points d'accès REST ou websocket et reçoivent de l'audio parlé, avec un horodatage par mot pour les sous-titres et la surbrillance. Elle vise les équipes qui veulent des fonctions vocales sans payer les tarifs de l'IA vocale premium.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Unreal Speech.
Alternatives à Unreal Speech

Foley
Hanamori Labs, LLC · Voix et langage · Productivité · Assistant d’IAFoley est une liste de tâches vocale qui transforme une phrase prononcée en tâche classée, projet, date et heure compris, puis vous aide à organiser la journée à partir de ce qui est déjà noté.

HireKey
HireKey · Voix et langage · Productivité · ApprentissageHireKey est un copilote de recherche d'emploi IA conçu par une ancienne recruteuse tech. Il évalue l'adéquation au poste, adapte le CV, entraîne aux entretiens et suit chaque candidature.

Fluence
Yay Software (Yannick Huchard) · Rédaction · Voix et langage · ProductivitéFluence est une application Android qui lit à voix haute vos PDF, EPUB, fichiers Word et articles web, suit la phrase prononcée et répond aux questions sur le texte sans quitter le téléphone.