
Vectorize
Vectorize · Programmation · Apprentissage
Vectorize est une plateforme RAG managée qui extrait les données non structurées de documents, d'applications SaaS et de bases de connaissances vers votre propre base vectorielle, puis maintient cet index à jour.
À propos de Vectorize
What Is Vectorize
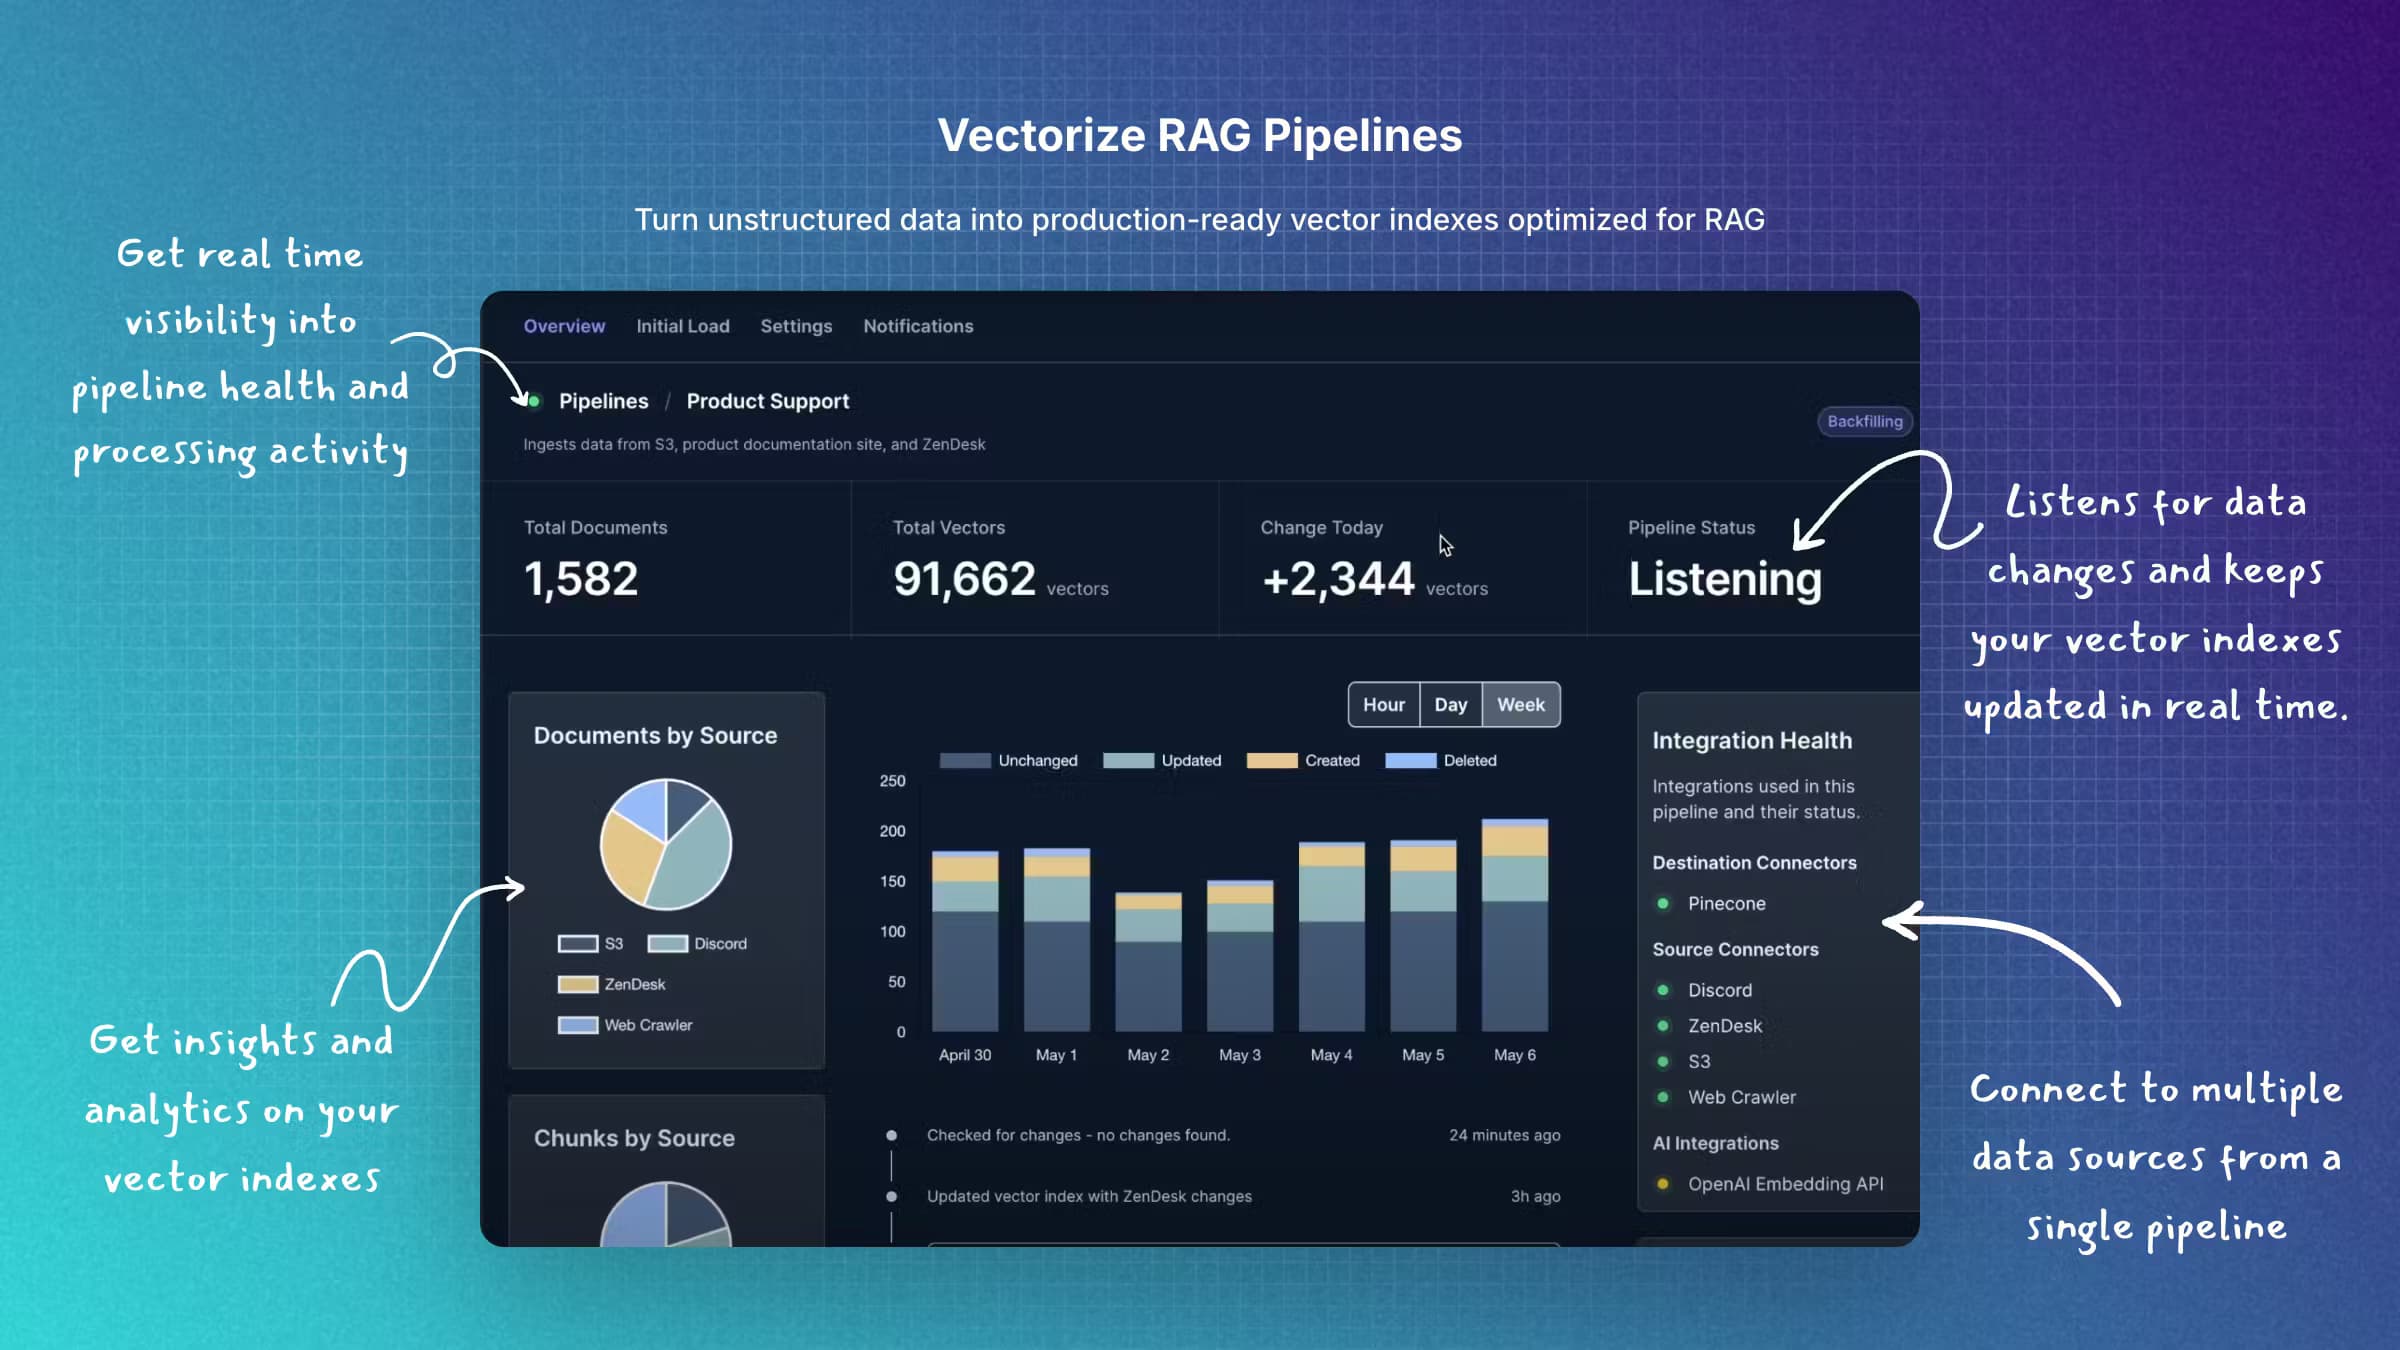
Vectorize est une plateforme hébergée pour construire des pipelines de génération augmentée par récupération, ou RAG. Elle vise à monter un pipeline RAG en temps réel, où l'index se met à jour au fil des changements des données sources. Elle se connecte aux données que vous avez déjà, fichiers, espaces cloud, historiques de conversation, tickets de support et contenus web, transforme ces contenus en embeddings et les écrit dans une base vectorielle que vous contrôlez. Le but est de donner à un modèle de langage un contexte privé et récent sur lequel il n'a jamais été entraîné.
Le problème visé, c'est le savoir éparpillé ou périmé. Si vous montez le même pipeline à la main, vous finissez par brancher plusieurs services, un pour extraire le texte, un autre pour le découper et calculer les embeddings, un troisième pour stocker les vecteurs, plus votre propre code pour tout garder synchronisé. Vectorize regroupe ces étapes derrière une seule interface et fait remonter chaque changement de vos données sources jusqu'à l'index.
La limite principale tient à la portée. Vectorize couvre la couche de récupération, pas celle du modèle : vous fournissez donc toujours votre propre LLM et votre base vectorielle. La plateforme privilégie aussi les connecteurs prêts à l'emploi plutôt que des pipelines entièrement sur mesure, ce qui veut dire qu'une source de données inhabituelle peut demander du travail supplémentaire.
Getting Started
- Créez un compte sur platform.vectorize.io et mettez en place une organisation pour votre projet.
- Connectez une source de données, comme un espace cloud, un envoi de fichiers ou une base de connaissances SaaS, depuis la liste de connecteurs intégrés.
- Choisissez une base vectorielle de destination, par exemple Pinecone, Qdrant ou PostgreSQL, puis sélectionnez un modèle d'embeddings chez OpenAI, Voyage AI ou parmi les options intégrées.
- Configurez le pipeline pour qu'il synchronise les changements au fil de l'eau, puis lancez l'indexation de vos contenus.
- Interrogez l'index via l'endpoint de récupération, qui calcule l'embedding de la question, exécute une recherche k-ANN et renvoie des résultats classés avec leurs scores de pertinence.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de Vectorize.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Développeurs backend et ML
- Jeunes équipes qui lancent un produit IA
- Ingénieurs données et plateforme en grande entreprise
Tâches
- Ancrer un chatbot de support
- Garder un index de recherche frais
- Tester la qualité de récupération
Cas d'usage
- Équipes dont la documentation bouge vite
- Produits avec de nombreuses sources de données
- Environnements réglementés
Fonctionnalités clés
Constructeur de pipelines RAG
Le constructeur de pipelines est le cœur de l'outil. Vous choisissez une source, une base de destination et un modèle d'embeddings, et Vectorize assemble pour vous les étapes d'extraction, de découpage, d'embeddings et de stockage. On configure en cliquant plutôt qu'en codant, ce qui raccourcit le délai entre le branchement d'une source et un index interrogeable. Les équipes qui veulent changer de modèle plus tard le font sans reconstruire tout le flux.
Mises à jour vectorielles en temps réel
Presque toutes les configurations RAG deviennent périmées dès qu'un document change, car l'indexation tourne selon un calendrier fixe. Vectorize surveille vos sources connectées et pousse les changements vers le stockage vectoriel au moment où ils surviennent : une nouvelle page de politique ou un ticket résolu arrivent dans l'index peu après leur apparition. Les réponses restent ainsi liées à ce qui existe vraiment dans vos systèmes aujourd'hui.
Endpoint de récupération avancée
L'endpoint de récupération réunit plusieurs étapes en un seul appel. Il vectorise la requête entrante, exécute une recherche k-ANN sur votre index, réécrit éventuellement la requête à partir de l'historique de conversation et applique un reclassement intégré. Les résultats reviennent avec des scores de pertinence, la similarité cosinus et des métadonnées, ce qui aide quand il faut afficher les sources ou filtrer par attributs de document plutôt que recevoir un simple bloc de texte.
Intégration base de données vectorielle
L'intégration base de données vectorielle vous laisse choisir le stockage. Vectorize stocke les embeddings dans une base que vous choisissez au lieu d'enfermer les données dans son propre stockage. Les connecteurs prêts à l'emploi couvrent Pinecone, Qdrant, Weaviate, PostgreSQL, Elastic, Azure AI Search, Neo4j, Milvus et d'autres. Vous conservez les outils de requête, les contrôles d'accès et les sauvegardes sur lesquels vous comptez déjà, et vous pouvez déplacer les données ou faire tourner des charges mixtes sur le même stockage.
Connecteurs de sources
La liste de connecteurs va là où vivent les contenus réels : stockage cloud comme Amazon S3 et Google Cloud Storage, applications de productivité comme Google Drive et Dropbox, outils de conversation comme Discord et plateformes comme Confluence, GitHub ou Intercom. Ingérer directement depuis ces sources évite d'exporter le tout vers un dossier temporaire, ce qui réduit à la fois le travail de mise en place et les désynchronisations.
Choix du modèle d'embeddings
Vous n'êtes pas lié à un seul fournisseur d'embeddings. La plateforme prend en charge des modèles d'OpenAI, Voyage AI, Amazon Bedrock, Vertex AI et d'autres plateformes d'IA : vous pouvez peser le coût face à la qualité de récupération et choisir pipeline par pipeline. Changer de fournisseur plus tard relève du réglage de configuration et non de la réécriture, ce qui aide quand un modèle meilleur ou moins cher apparaît.
Traitement visuel avec Iris
Vectorize Iris gère les PDF complexes que l'extraction de texte simple abîme, comme les pages scannées, les tableaux denses et les mises en page où le sens dépend de la structure. Il lit la disposition visuelle pour que les fragments vectorisés gardent les relations de tableau et de page qui comptent pour une récupération précise, là où les analyseurs simples échouent souvent.
Avantages et inconvénients
Avantages
- Garde vos vecteurs dans une base que vous contrôlez, donc les règles d'accès et les sauvegardes que vous utilisez déjà continuent de s'appliquer.
- La synchronisation en temps réel réduit le travail manuel de réindexation dont dépendent les configurations RAG périmées.
- Des connecteurs prêts à l'emploi pour le stockage, le SaaS et les bases de connaissances courantes raccourcissent la mise en place.
- L'endpoint de récupération regroupe la réécriture de requête et le reclassement, donc vous écrivez moins de code de liaison.
- Une offre gratuite existe pour les développeurs individuels et les projets annexes.
Inconvénients
- Vous avez toujours besoin de votre propre LLM et base vectorielle : ce n'est pas une pile applicative complète.
- Les sources de données inhabituelles ou internes peuvent demander un travail sur mesure hors des connecteurs prêts.
- Le tarif suit le nombre de pages traitées, donc de gros volumes de documents font vite grimper les coûts.
- Le constructeur de pipelines passe par l'interface : les équipes qui préfèrent les outils orientés code peuvent le trouver limité.
Questions fréquentes
Vectorize construit et exécute des pipelines RAG qui donnent à un modèle de langage un contexte privé et à jour issu de vos propres données. Vous connectez des sources, choisissez une base vectorielle et interrogez l'index via un endpoint de récupération.
Contenus associés
Découvrez des outils, des compétences et des articles liés à Vectorize.
Alternatives à Vectorize

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.