
wafer
Wafer · Programmation
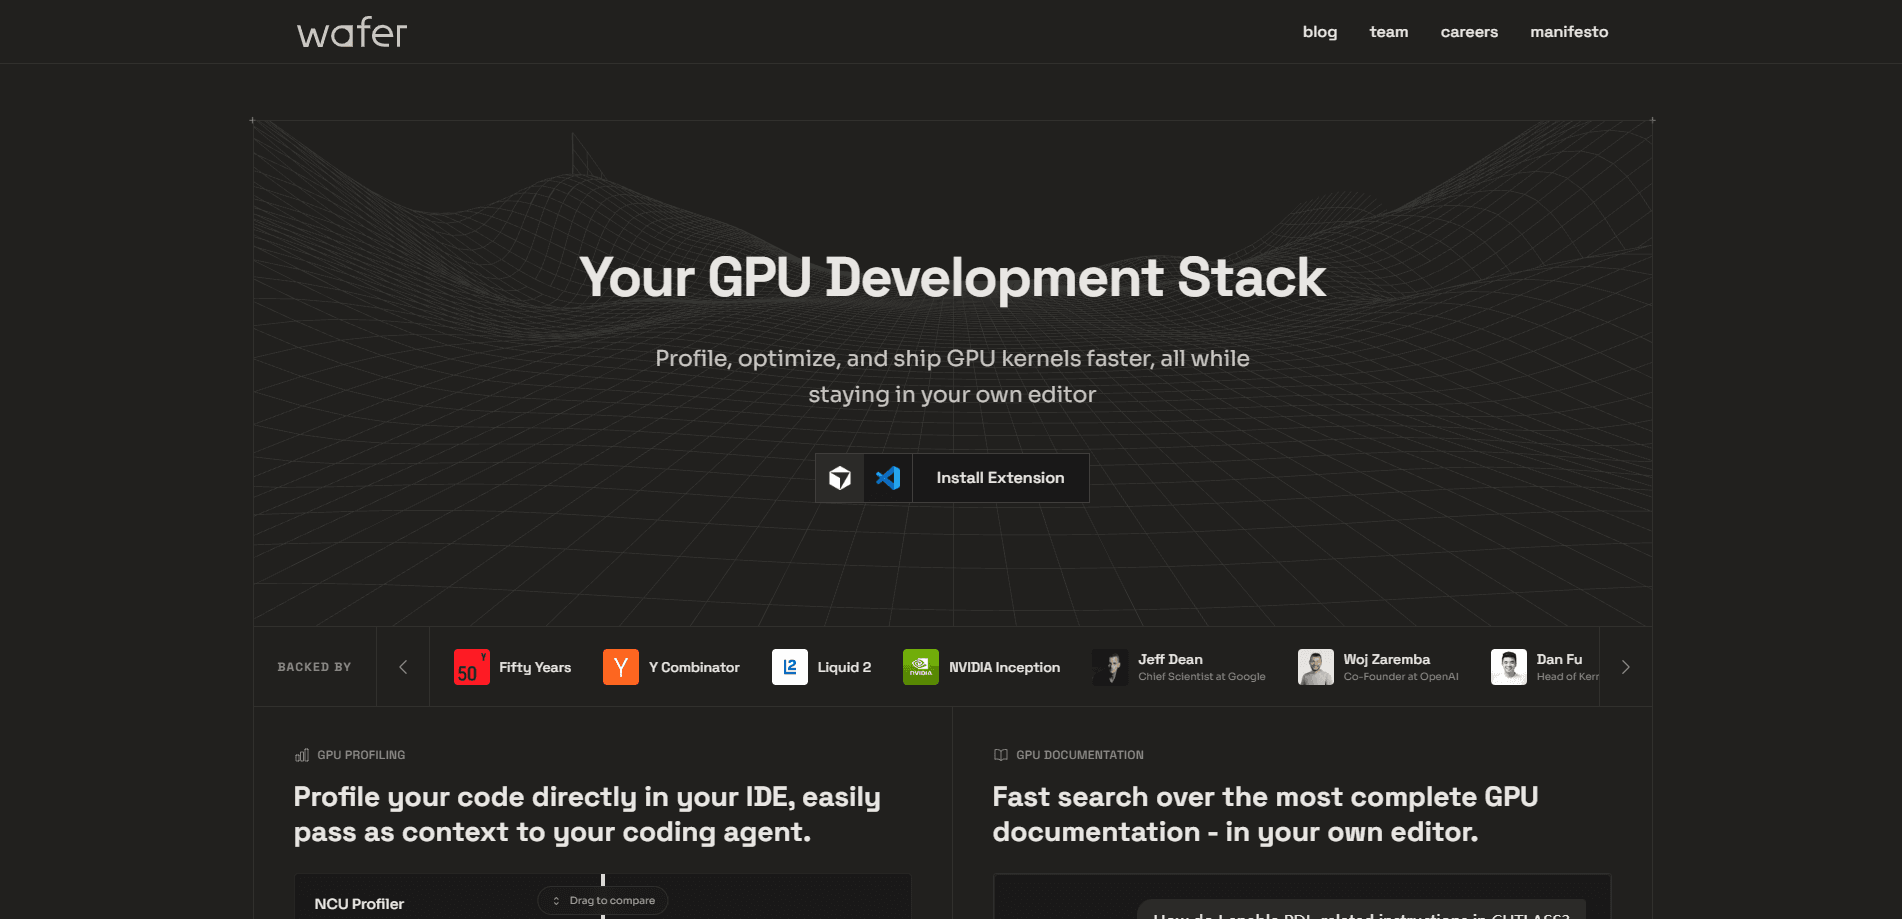
Wafer est une plateforme d'optimisation d'inférence IA qui règle toute la pile de serving GPU en fonction de votre trafic réel, et non d'un benchmark générique. Au lieu d'activer un interrupteur en espérant que ça marche, elle profile où vont vraiment la latence et le débit, génère des configurations candidates parmi les noyaux, les moteurs, le batching et la quantification, puis ne déploie que celles qu'elle a mesurées comme plus rapides. L'accent porte sur l'inférence LLM à une échelle où le coût et la latence comptent. Les équipes apportent un modèle, une forme de trafic et un objectif de niveau de service, et Wafer maintient l'endpoint réglé à mesure que la charge et le matériel changent.
À propos de wafer
Qu'est-ce que Wafer
Wafer est une plateforme d'inférence managée créée par l'équipe derrière Continual Inference. La promesse est volontairement étroite : la configuration la plus rapide pour un modèle de langage est rarement un seul réglage qu'on active. Le choix des noyaux, le comportement du moteur de serving, le batching, la quantification, le matériel et la forme du trafic se contrarient mutuellement, si bien que régler une couche casse souvent une autre.
C'est ce problème que Wafer attaque. Son agent profile votre pile pour déterminer si le goulot d'étranglement se situe dans l'ordonnancement, le décodage, les noyaux, la pression mémoire ou l'adéquation matérielle, puis explore des configurations candidates et mesure chacune d'elles pour voir quelle combinaison gagne vraiment sur votre trafic. Seuls les changements qui tiennent sont déployés. Toute la boucle est pensée pour continuer à tourner après le lancement. Le trafic évolue. Les modèles sont mis à jour. Du nouveau matériel arrive sans cesse. Un réglage fait une seule fois survit-il à tout cela ? Non.
Les principales limites méritent d'être dites franchement. Wafer vise les équipes qui exploitent l'IA à une échelle où le coût d'inférence pèse, pas quelqu'un qui bricole un modèle local. C'est aussi un service dédié et accompagné : vous apportez votre modèle et votre trafic réel, pas un produit en libre-service à glisser-déposer. Si vous voulez juste appeler un modèle open source hébergé en quelques clics, ce n'est pas cela.
Premiers pas
- Créez un compte sur l'application web de Wafer et ouvrez l'espace de déploiement dédié.
- Partagez votre modèle, la forme de votre trafic réel et l'objectif de niveau de service à atteindre.
- Laissez l'agent profiler la pile et générer des configurations candidates parmi le batching, le décodage, la quantification, les moteurs, les noyaux et le matériel.
- Examinez les résultats mesurés et déployez la configuration la plus rapide qui préserve l'exactitude et vos objectifs de fiabilité.
- Continuez à profiler le trafic de production pour que Wafer s'adapte quand la charge, les modèles ou le matériel changent.
Informations sur le produit
Aperçu des tarifs, des plateformes compatibles et des performances de wafer.
Idéal pour
Les utilisateurs, tâches et cas d'usage où cet outil convient le mieux.
Utilisateurs
- Équipes plateforme ML
- Équipes d'ingénierie de startups
- Ingénieurs backend et performance
Tâches
- Réduire les coûts de serving LLM
- Atteindre un objectif de latence
- Régler des modèles MoE
Cas d'usage
- Un modèle déjà en production qui coûte trop cher à exécuter
- Déplacer une charge vers un nouveau matériel
- Préparer un lancement
Fonctionnalités clés
Profilage de toute la pile
L'agent de Wafer profile le chemin de serving complet plutôt qu'une seule couche, et détermine si la latence ou le débit vient de l'ordonnancement, du décodage, des noyaux, de la pression mémoire ou d'une adéquation matérielle mal ajustée. Ce diagnostic oriente tout ce qui suit, si bien que les changements ciblent le vrai goulot d'étranglement et non une supposition. Pour une équipe bloquée sur un plateau de latence, c'est la différence entre deviner et mesurer. Fini les retouches à l'aveugle.
Recherche de configurations candidates
L'agent génère de nombreuses configurations candidates parmi le batching, le décodage, la quantification, les moteurs de serving, les noyaux et le matériel, puis mesure chacune. Rien n'est déployé sur la seule théorie. C'est la raison d'être de la plateforme : ce qui semble rapide sur le papier perd souvent face à une autre combinaison en pratique. Faites confiance aux chiffres, pas à l'intuition.
Génération de noyaux personnalisés
Wafer écrit des ops fusionnées, des chemins d'attention, des variantes de GEMM et des noyaux de décodage réglés pour une forme de modèle et une cible matérielle précises. Ce sont des noyaux CUDA et leurs équivalents, et la même approche couvre HIP, Triton et NKI, ce qui englobe NVIDIA, AMD et d'autres piles d'accélérateurs. Les noyaux personnalisés comptent surtout quand un chemin standard laisse de la performance sur la table.
Autoréglage du moteur de serving
Les moteurs de serving sont réglés pour le modèle exact, la forme du trafic, la pression mémoire et l'objectif de latence, en couvrant le comportement de l'ordonnanceur, la gestion du cache KV et les réglages d'exécution. L'autoréglage ici supprime le balayage manuel que la plupart des équipes feraient à la main. Il garde aussi le moteur aligné sur le comportement réel de votre charge. Moins de surveillance, plus de débit.
Recherche de stratégie de décodage
Wafer compare le décodage spéculatif, la quantification FP8 et FP4, les stratégies de batching et le sharding d'experts pour les modèles MoE. Ces choix interagissent fortement, donc les tester ensemble vaut mieux que les régler un par un. Pour qui sert de grands modèles, la stratégie de décodage est souvent là où se cachent les plus gros gains. Sautez-la et vous laissez de l'argent sur la table.
Fiable par conception
Chaque candidat doit préserver l'exactitude et respecter vos objectifs de fiabilité avant de pouvoir être déployé. Ce garde-fou compte quand l'optimisation et la quantification peuvent changer discrètement les sorties. Vous obtenez l'accélération sans échanger en silence les résultats dont vos utilisateurs dépendent. C'est tout l'intérêt.
Réajustement continu
La plateforme reste dans la boucle après le déploiement. Quand le trafic évolue, que les modèles sont mis à jour ou que du nouveau matériel arrive, Wafer mesure à nouveau et s'adapte. La performance d'inférence dérive, donc un réglage fait une seule fois tend à devenir obsolète. Le réajustement continu est ce qui garde un endpoint compétitif pendant des mois plutôt que des jours.
Avantages et inconvénients
Avantages
- Optimise toute la pile de serving plutôt qu'une couche, ce qui permet de repérer des goulots d'étranglement que les outils à réglage unique manquent.
- Ne déploie que des configurations mesurées, ce qui réduit le risque de régression lié à un changement non testé.
- Couvre des stratégies de décodage modernes comme le décodage spéculatif, la quantification FP8/FP4 et le sharding d'experts MoE.
- Continue de régler en production à mesure que la charge, les modèles et le matériel changent, donc les résultats ne deviennent pas obsolètes.
- Le programme pour startups offre 500 $ de crédits gratuits plus un abondement 1:1 jusqu'à 10 000 $, ce qui adoucit le coût du démarrage.
Inconvénients
- C'est un service dédié et accompagné, donc il n'y a pas de voie en libre-service instantanée si vous voulez juste déployer un modèle rapidement.
- La valeur dépend d'un trafic et d'une échelle réels ; un petit projet à charge d'inférence légère peut ne pas voir un gain suffisant pour justifier l'effort.
- Le réglage profond entre noyaux et quantification suppose une équipe d'ingénierie à l'aise avec les entrailles du serving.
- Le tarif public n'est pas indiqué sur le site, donc le coût doit être établi lors d'un échange avec l'équipe.
Questions fréquentes
Wafer règle toute la pile de serving LLM pour votre charge et ne déploie que les configurations qu'il a mesurées comme plus rapides. Il profile la pile, explore des configurations candidates et continue de réajuster en production.
Contenus associés
Découvrez des outils, des compétences et des articles liés à wafer.
Alternatives à wafer

Base Code
Base44 (Wix) · Programmation · ProductivitéBase Code est un environnement de développement cloud partagé signé Base44. Votre équipe décrit des modifications sur un dépôt GitHub dans le chat, les vérifie en aperçu et les renvoie sous forme de pull requests.

Google EmbeddingGemma 2
Google DeepMind · Rédaction · Image · ProgrammationGoogle EmbeddingGemma 2 est un modèle ouvert de 740 millions de paramètres qui transforme texte, code, images, audio et images vidéo en vecteurs d'un même espace de 768 dimensions, sur un téléphone ou un ordinateur portable.

GitGlow
GitGlow · Programmation · ProductivitéGitGlow est un client Git de bureau qui place votre code et les modifications de vos agents IA dans une même revue, pour savoir ce qui quitte votre machine avant de livrer.