Anthropicが、モデルの重みと出力の対応を暗号学的に証明する研究実装を公開した。検証はCPUで17秒。代償は推論の数十倍という計算量にある。
FlashProveが解く問題
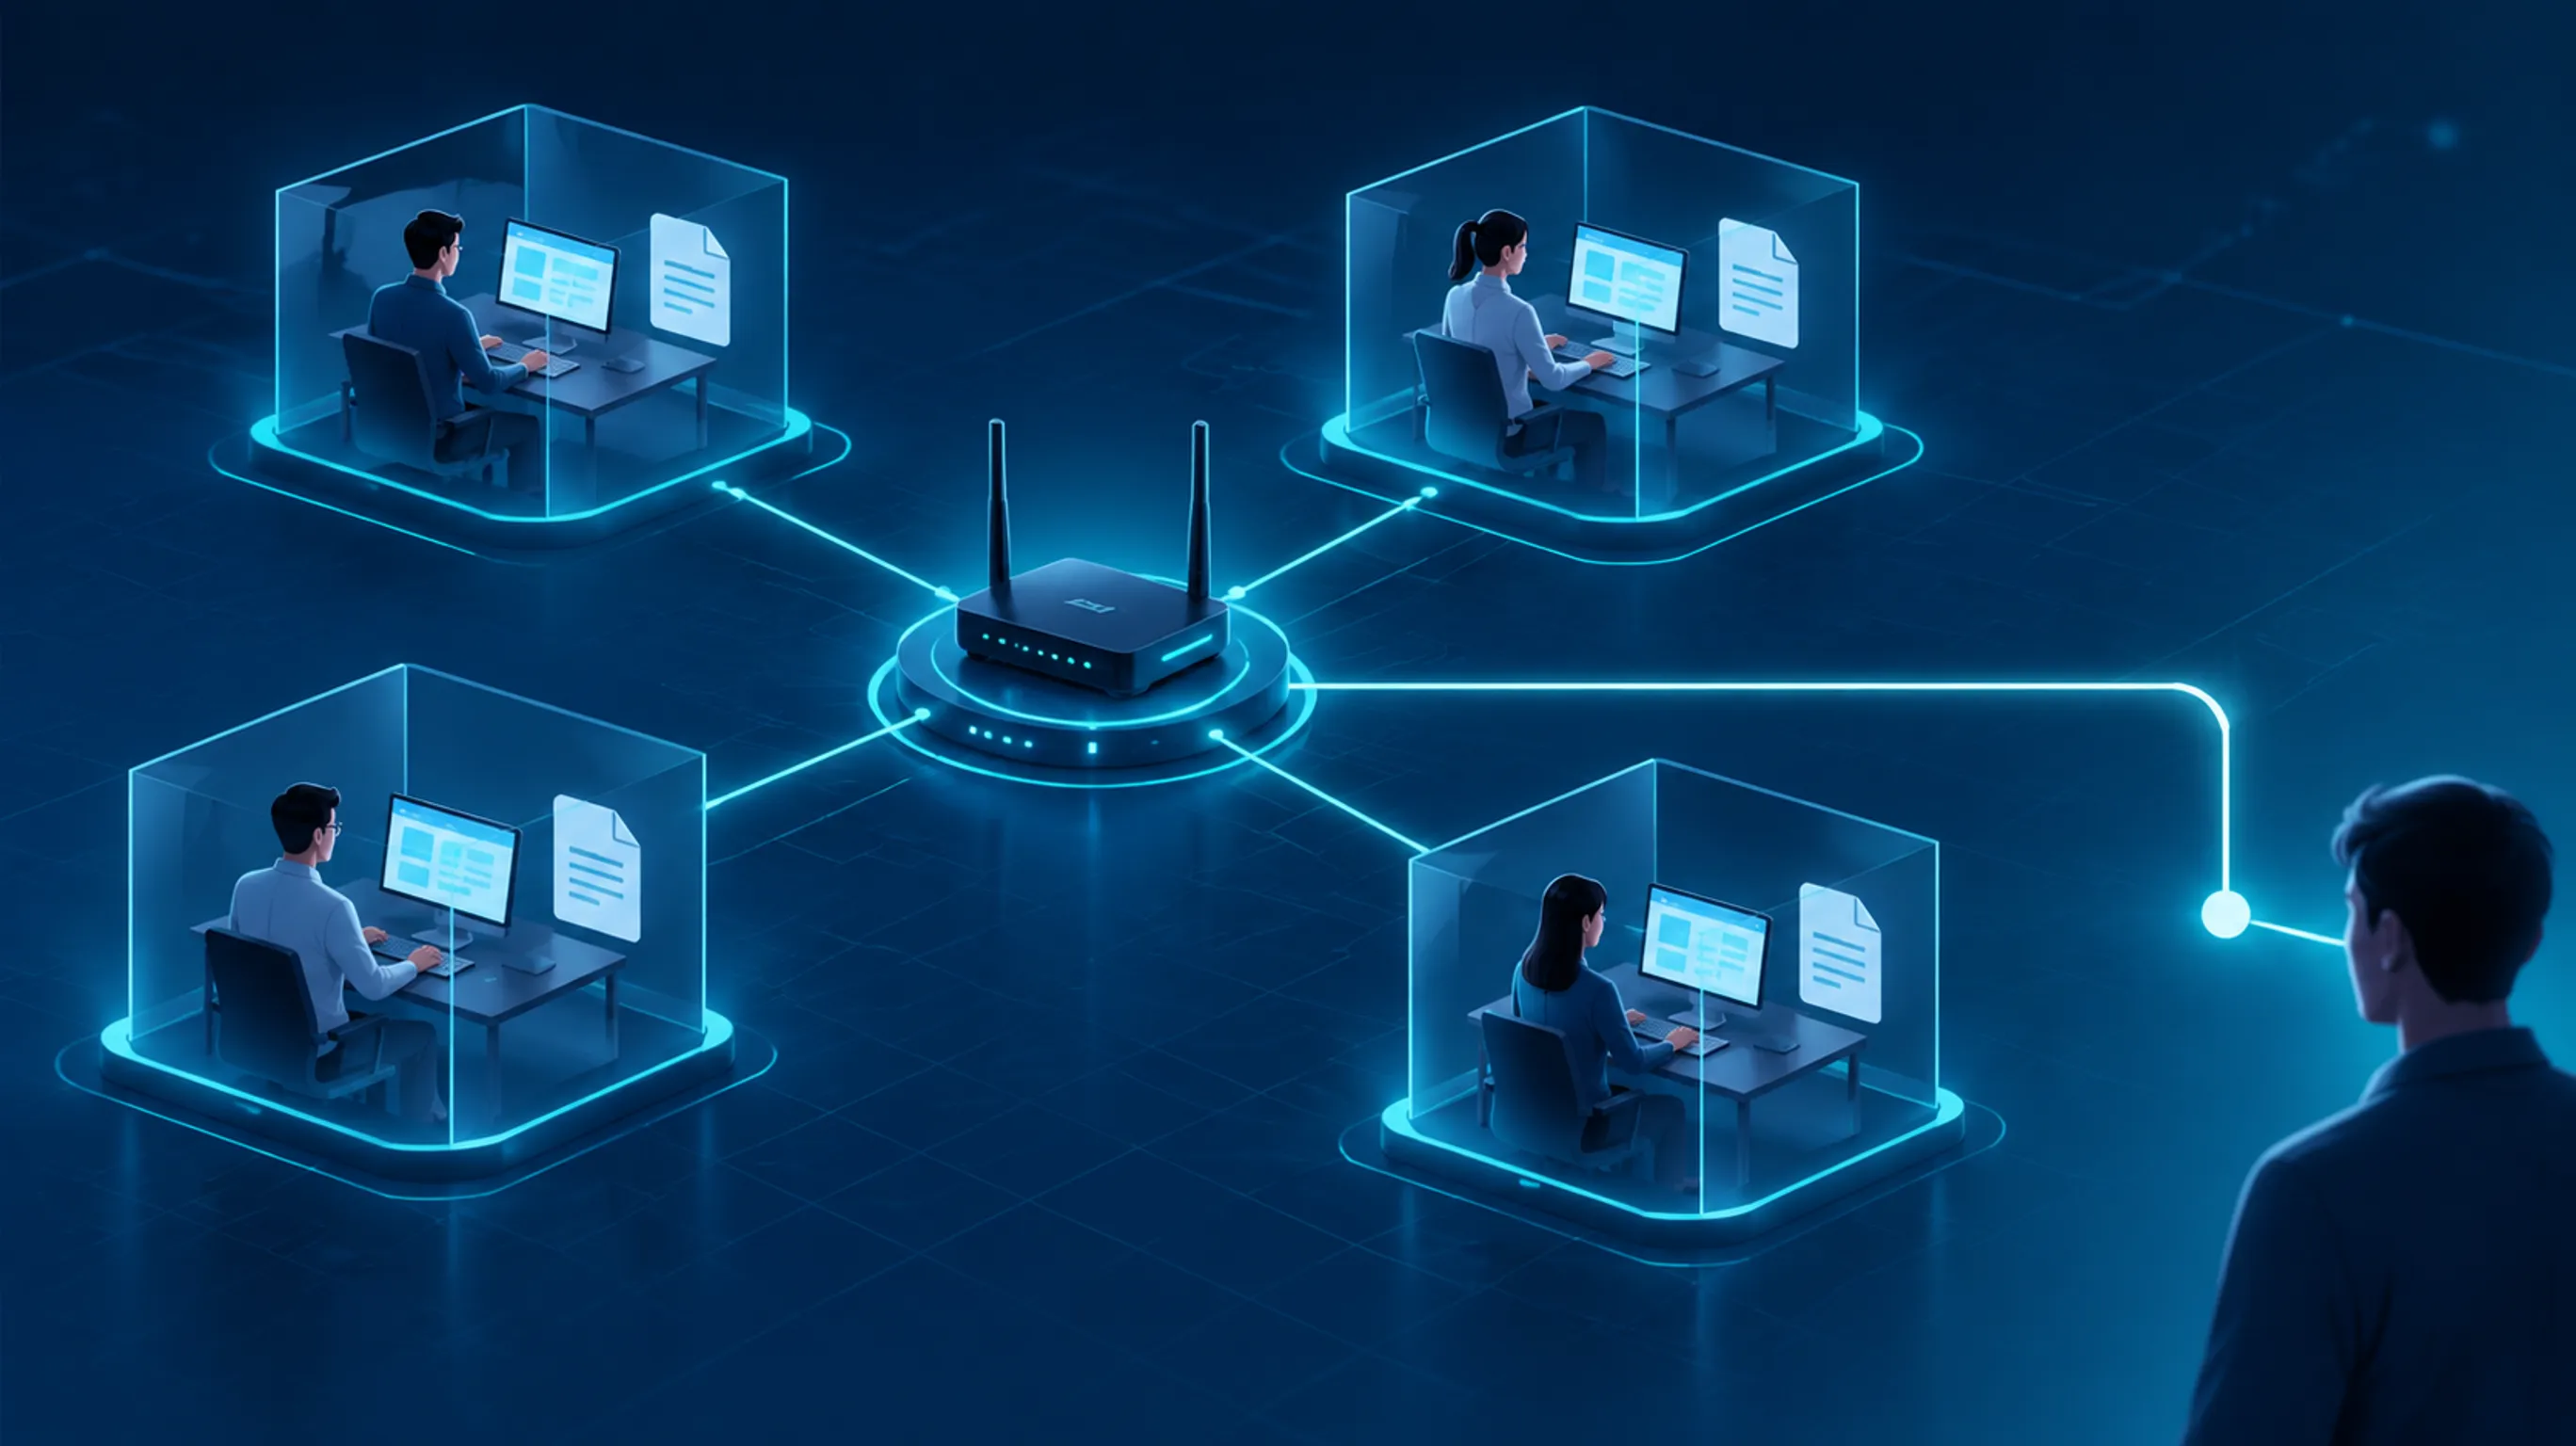
クラウドでモデルを動かすとき、利用者は自分が選んだモデルが答えているか確認できない。運営側がこっそり安いモデルに差し替えても、出力だけを見て見分けるのは難しい。
Anthropicは2026年11月3日、この不信に技術で答える研究「Progress on provable inference for large language models」を公開した。技術レポート、プロトコル仕様、証明生成器と検証器のコード、Leanの証明がApache 2.0で付いている。
FlashProveはzkSNARKを使う。zkSNARKは中身を明かさずに「この計算が正しい」と示せる暗号技術だ。ここでは、固定した重みの集合がこのプロンプトにこのトークン列を返したことを証明する。重み自体は見せない。
zkSNARK inferenceの2つの段階
処理は2段に分かれる。オフラインで重みへのコミットメントを作る。重みの短い指紋のようなもので、サイズは約6.5MB、1回の実行に約39分かかり、およそ1,600万リクエスト分に使える。オンラインではリクエストごとに証明を付け、1,024トークンで約19MB(18.78MB)になる。
Llama 4 Maverickで測った数値
測定に使ったのはLlama 4 Maverickだ。400BパラメータのMixture of Expertsで、1トークンあたり実際に働くのは約17B。公開されている4bit重みを使い、H100を1枚、CPUコア24本という構成で動かした。
証明の生成速度は毎秒約110トークン。検証はGPUなしの普通のCPUで17秒(24スレッド)、シングルスレッドでも21秒で終わる。重い処理をGPUに残し、確認だけをCPUに移せる設計は、クラウド事業者が顧客ごとに証明を添えて回るうえで現実的な選択になる。
Anthropic provable inferenceの代償
同じバッチをvLLMで配信した場合と比べ、証明付きの処理はGPUあたり約72倍の時間がかかる。試行によって66倍から77倍まで幅があり、最も負荷の高い条件では約94倍だった。
料金への影響は書かれていない。今の数値は研究用の測定だ。
FlashProveで防げる3つの不正
想定される不正は3つある。ルーティングサービスが安いモデルに差し替える。攻撃者がトークン列を途中で書き換える。規制当局が承認したモデルだけを動かすよう求める。
有効な証明があれば、どれも検出できる。重みを渡さずに済むのがzkSNARKの利点だ。Anthropicは「失敗の証明」にも触れている。モデルがバグ探しに一定のトークンを使い、見つからなかったことを示す使い方だ。
Zero-Knowledge AIの限界
研究チーム自身が制約を並べている。研究用のプロトタイプで、本番提供ではない。証明の対象は整数化した重みと貪欲法の出力に限る。サンプリングや浮動小数点が入ると答えがずれ、証明と合わなくなる。
Mixture of Expertsを前提とし、アーキテクチャは隠さない。サイドチャネル攻撃は対象外で、コンテキストは1,024トークンまで。C++の高速検証器は形式検証されておらず、Leanの検証器は証明済みだが遅い。
Lean検証で埋まらない隙間
完全性、健全性、ゼロ知識性という性質はLeanで機械的に検査されている。ここは強い主張だ。ただし形式化した命題が意図を捉えているかは人の監査が要るし、証明コードが仕様と一致するかという隙間も残る。
FlashProveは研究プロトタイプの段階
AnthropicのFrontier Safety Roadmapには、2026年9月30日までに検証可能な推論の試作を出す目標があった。同社は別プロジェクトで達成したと説明する。推論の通信に署名し、信頼できるサーバーで再計算する方式だ。FlashProveはソフトウェアだけで済む2つ目の経路になる。
では、その証明を誰が検証するのか?今の実装は利用者か監査者が自前で回す前提だ。1,024トークンの窓も、長い会話や文書要約には足りない。それでも「払ったモデルが答えている」を数学で示せる道が開いた意味は大きい。