OpenAIは9月22日、「GPT-6 Sol」と「GPT-6 Luna」を公開した。いずれもGPT-5.6の同名モデルから料金がほぼ半額になる。GPT-6世代のラインアップがどう組み立てられているのか、なぜOpenAIはモデルを分けるのか、そして「半額」が実際の請求にどう跳ね返るのかを整理する。
GPT-6ファミリーの並び
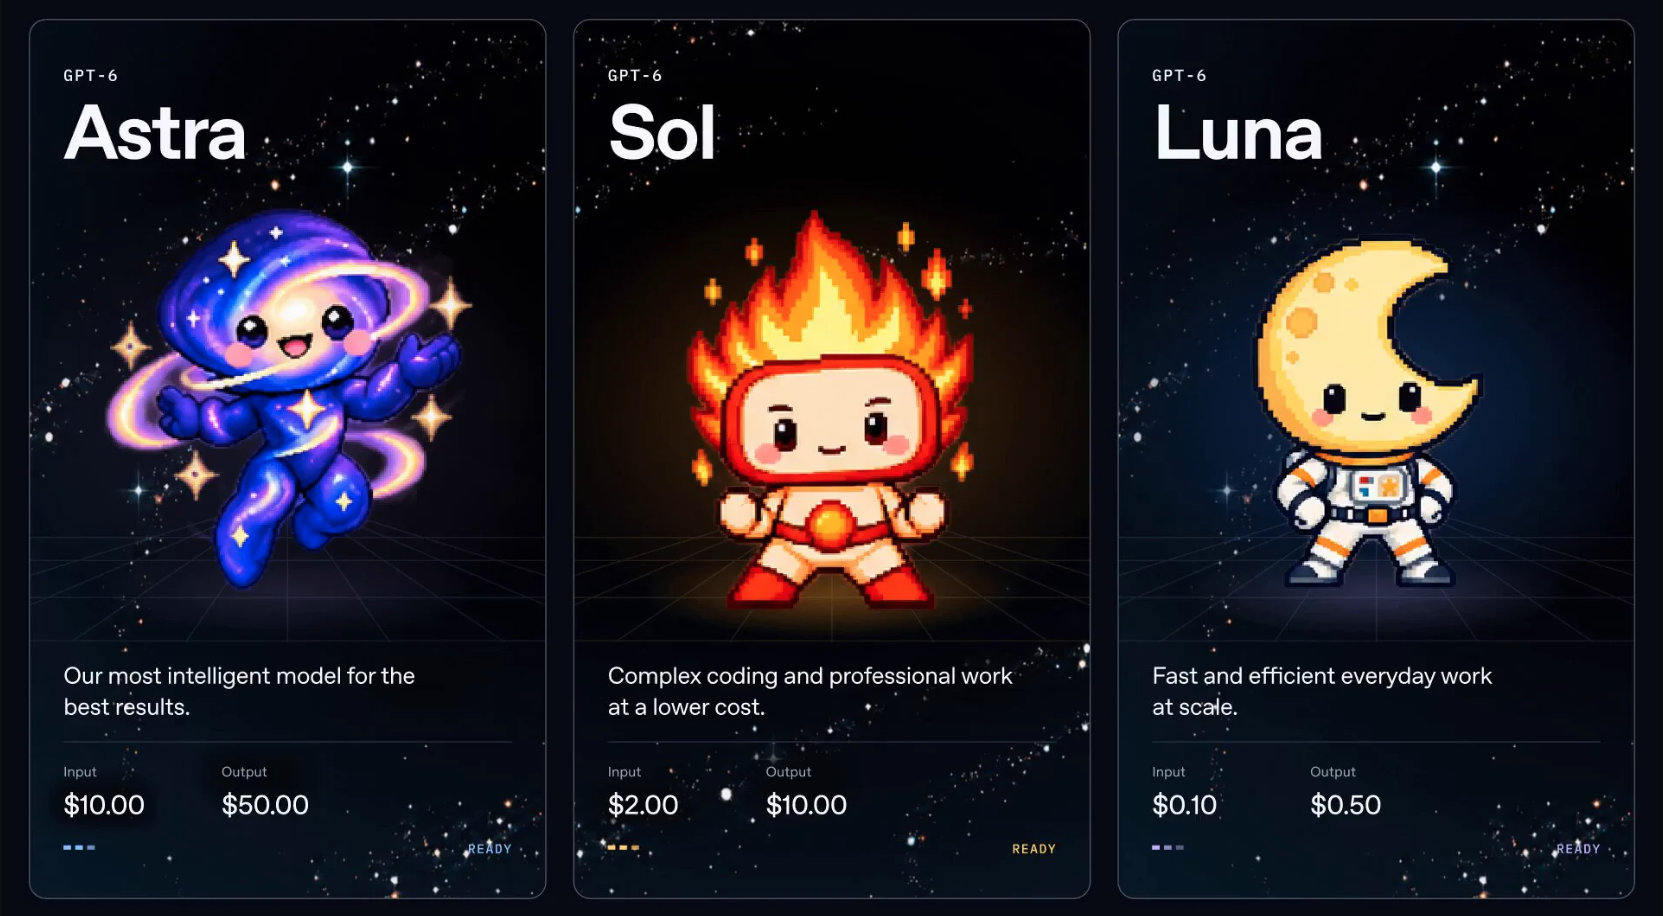
GPT-6は3つのモデルで構成される。上からGPT-6 Astra、中間のGPT-6 Sol、そして下位のGPT-6 Lunaだ。名前だけでは役割が見えてこないので、順に確認する。
Astraは9月3日に投入済みで、OpenAIはこれを自社で最も知能が高く、最も整合性が取れたモデルと位置づける。SolとLunaは9月22日に登場した。両者はAstraと同じ系統の手法で作られており、想定するコスト帯が異なる。
役割はこう分かれる。Astraは主力の最上位だ。Solは日常業務を回すためのミドルクラスで、複数ステップの作業を任せても最後までやり切る。Lunaは低価格モデルで、回数を重ねる大量処理に向く。安い呼び出しを数多く積むほうが、高い呼び出しを少数使うより得になる場面を想定している。
なぜ分けるのか。1つのモデルで全用途をこなすのは無理がある。難しい推論に合わせて鍛えたモデルは、短い処理を繰り返す用途に合わせたモデルより、運用コストが高くつく。それでいて、すべての入力に最先端の性能が要るわけではない。用途ごとにモデルを分ければ、簡単な処理は安い枠で回し、本当に必要なときだけ高い枠を使える。
ここで効くのが「同じ系統」という点だ。OpenAIによれば、SolとLunaはAstraに近い手法で学習されている。下位モデルが、ゼロから作り直すのではなく上位モデルの能力を受け継げるのはこのためだ。この引き継ぎが今回の発表の核心にあたる。
「半額」が請求書にどう効くか
料金を具体的に見る。Solは100万トークンあたり入力2ドル、出力10ドル。置き換え対象のGPT-5.6 Solは入力4ドル、出力20ドルだった。Lunaは入力0.10ドル、出力0.50ドルで、GPT-5.6 Lunaの入力0.20ドル、出力1.20ドルから下がった。どちらもおおむね従来の半分だ。
トークンとはテキストの断片で、短い単語1つ分くらいにあたる。APIでトークン単位の課金をしているなら、単価が半額になれば同じ処理のコストも半分になる。OpenAIはこの削減をキャッシュと推論の改善によるものと説明する。推論とは、入力文を応答に変換する処理の部分だ。浮いた分は自社に残さず利用者に渡しているという。ただしこれはOpenAI自身の説明であり、外部が検証した事実ではない。
下位モデル
- GPT-6 Luna:100万トークンあたり入力0.10ドル/出力0.50ドル
- GPT-5.6 Lunaでは入力0.20ドル/出力1.20ドル
- 回数を重ねる大量処理向け
ミドルクラス
- GPT-6 Sol:100万トークンあたり入力2ドル/出力10ドル
- GPT-5.6 Solでは入力4ドル/出力20ドル
- 日々の実務を回す用途向け
ここでラインアップの分け方が効いてくる。半額と一口に言っても、影響は2つの別々の予算に及ぶ。数百万回の短い呼び出しを回しているなら、月次のコストを動かすのはLunaの単価だ。長く複雑な処理に金を払っているなら、体感するのはSolの単価になる。
公表ベンチマークで見る実力差
OpenAI自身のベンチマークでは、Solはいくつかの試験で上位モデルに迫る。ただし数値はすべてOpenAIのもので、競合のスコアは公開レポートからの引用だ。47のツールにまたがる業務手順を測るAutomationBenchで、Solは最高努力設定のとき33.2%を記録し、1タスクあたり0.27ドルかかる。OpenAIによれば、これはClaude Opus 5の最高設定(26.9%)を上回る。しかもOpus 5は1タスクあたり11.1倍のコストがかかるという。
コーディングでは差が縮む。DeepSWE 1.1でSolは最高努力時に68.8%を出し、より高い努力設定のClaude Fable 5(69.9%)に1.1ポイント差まで迫る。コストは1タスクあたり約80%低い。
Lunaは低価格モデルらしく下に位置する。DeepSWE 1.1の最高努力時で66.6%に達し、OpenAIはこれを中程度の努力設定のOpus 5とFable 5と同水準に置く。1タスクあたりのコストは93〜96%少ない。さらに努力を上げれば、旧GPT-5.6 Solと約100分の1のコストで並ぶという。事実の正確さについては、OpenAIの社内評価でSolの誤りはGPT-5.6 Solのおよそ半分だと報告されている。
この最後の主張には留保が要る。自社試験による自社の数値であり、外部が追試できるよう手法の全体は公開されていない。方向性は信頼できるが、正確な規模はまだ第三者に確かめられていない、と読むのが正直なところだ。
モデル間の実力差は、料金差ほど大きくない。SolはOpenAIが重視する試験で上位に食い込み、Lunaは前世代のミドルクラスに数ポイント差まで迫る。上位モデルで買っているのは、最も難しい作業での最後のわずかな精度だ。多くの用途では、そのために数倍の料金を払う価値はない。
なぜモデルを分けるのか
3つの構成は、技術判断であると同時に価格戦略でもある。単一の最先端モデルでは、全顧客が同じ高い単価を払わされる。Astra、Sol、Lunaに分ければ、最高の性能を必要としない処理には安い料金を設定できる。すべてに最上位の単価を払うのではなく、処理にモデルを合わせる道が生まれる。
低価格を支えるのはキャッシュだ。長い入力文を送ると、システムは処理済みの部分を保持し、毎回やり直さずに済む。OpenAIによれば、新モデルは既定でキャッシュの当たり率が高く、キャッシュ済み入力の読み取りに90%の割引を用意する。長い会話の繰り返し部分を再利用するコストが大きく下がる仕組みだ。この仕組みがなければ、下位モデルは表示価格より遅く、高くついたはずだ。
落とし穴もある。安いモデルは、想定外の用途に使いたくなる誘惑を生む。Solの精度が要る長い調査作業をLunaに投げれば、単価で浮いた分より、やり直しに使うトークン代のほうが高くつく。モデル名は目安であって、保証ではない。
どこで使えるのか
両モデルはChatGPT WorkとCodexで、Plus、Pro、Business、Enterprise、Eduの各ユーザーが利用できる。FreeとGoのユーザーはデスクトップアプリでLunaを使える。目立つ穴が1つある。どちらのモデルも通常のChatGPTチャットにはまだ入っていない。メインのチャット画面を普段使いしている人は、初日にそこでは見つけられない。
開発者はAPIのgpt-6-solとgpt-6-lunaという名前でアクセスできる。OpenAIによれば展開は段階的で、すぐに見えないのはタイミングの問題であって、利用者側の不具合ではない。
3モデル構成が利用者にとって意味するもの
まとめると、OpenAIのモデル構成の中でミドルクラスが、大きな犠牲なしに安くなった。下位モデルは、何を作る価値があるかを変えるほど安くなった。日常業務に割高な料金を払っているなら、Solはその取引のために用意されている。呼び出し1回あたりのコストを抑えたい規模の処理なら、見るべきはLunaだ。最も難しい作業での精度がすべてという場面では、Astraが選択肢として残る。
次に見たいのは独立系の検証だ。OpenAIのベンチマークは方向性は当たるが、程度まで正確とは限らない。今後数週間の第三者による試験で、Lunaのコスト優位が実際の負荷に触れて生き残るかが見えてくる。今のところ両モデルはChatGPT WorkとCodexで順次展開中で、APIでは2つの新しい名前で利用できる。PlusかProなら、ChatGPT WorkかCodexを開いてモデルピッカーを確認すればいい。無料プランなら、デスクトップアプリでLunaを探そう。