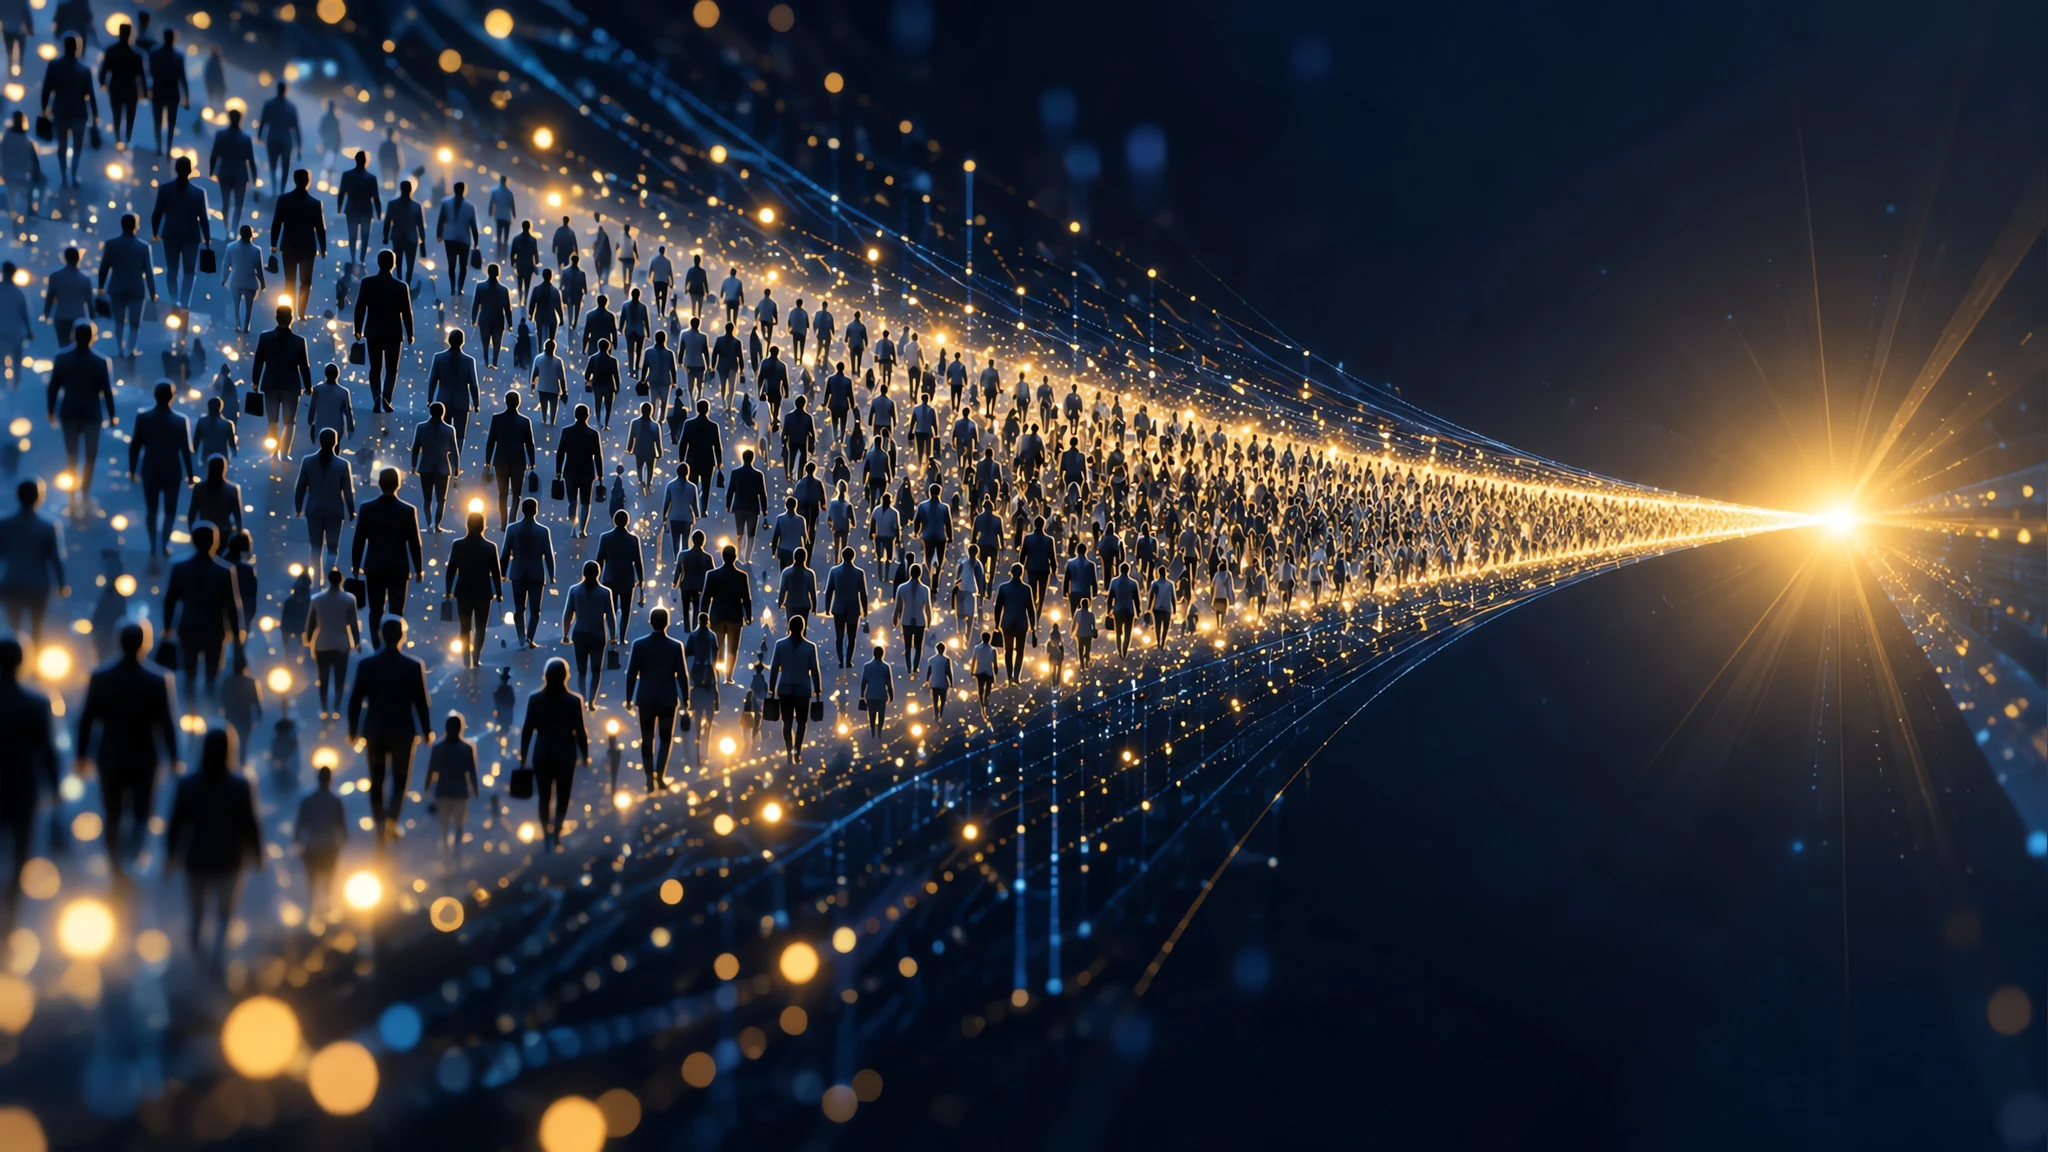
Andrej Karpathyは、大規模言語モデルの能力をめぐる理解の隔たりを「2つの集団がすれ違う」状態ではなく、急なすり鉢状の形をした漏斗(ファネル)だと表現した。彼の概算では、約60億人、つまり人口のおよそ75%が最先端モデルの能力にほとんど触れていない。
Karpathyが指摘したLLM能力の理解ギャップ
Karpathyは日曜日、Xへの投稿でこの構図を書き直した。4月に書いた投稿を再び持ち出し、そのときより隔たりが広がったと述べている。かつては「互いに噛み合わない2つの集団」だったものが、いまや上から下へ急に細くなる漏斗の形をとるという。
漏斗という比喩が効くのは、人数が上から下へ急減することを示せるからだ。多くの人がいる広い口の側から、最先端を扱うごく少数の先端へ、急な傾斜で絞られていく。2集団という言い方では、この急な落差は表せない。
Karpathyの「ナプキン計算」が示す60億人
Karpathyは手元の概算として、約60億人が最先端のLLMの能力にほとんど触れていないと書いた。世界人口のおよそ75%にあたる。
この数字は精密な統計ではない。本人が「ナプキン計算」と呼ぶ粗い見積もりだ。それでも、モデルの性能が話題になる場と、実際にそれを日常で使う人の数との間に、桁違いの開きがあることは伝わる。技術の進歩を語る声と、それを体験している人の規模は、同じ土俵にない。
Karpathyの投稿に集まった反応
この投稿はHacker Newsで大きな反響を呼び、数百件のコメントが付いた。研究者や実務者の間でも転載が広がり、Ethan Mollickらが取り上げている。
反応の多くは、漏斗の上側にいる側の実感に寄り添うものだった。最先端モデルを使い込む人ほど、その能力の伸びを強く感じる。同時に、周囲に見えている利用者の姿との差にも気づいている。この落差自体が、議論を呼ぶ理由になっている。
LLM能力の理解ギャップが広がる理由
隔たりが縮まないのは、性能が上がるほど、それを知る人と知らない人の距離も開くためだ。モデルは数カ月ごとに良くなる。だが、その変化に触れるには、契約や環境、言語や地域といった前提が要る。
Karpathyはさらに、社内で最先端モデルに触れられる人の数を約5000人と見積もっている。最先端の内部にいられる人数がこれだけ少なければ、外側との認識の差は自然と開く。能力が高いほど、その恩恵に届く経路は狭い。
Karpathyの指摘が意味すること
この投稿は、AIの議論が届く範囲そのものを問い直している。性能の話は、すでに使っている人の間で非常によく共有される。だがその外側には、ほとんど接点のない大多数がいる。
議論を見るとき、自分が漏斗のどのあたりにいるのかを意識すると、噛み合わなさの正体が見えやすくなる。数字は概算であっても、隔たりが縮まっていないという指摘は、能力の話とは別の論点として受け止めておきたい。